
ComplexDataLab/chai-veracity-20260720-dbscan-dry-run-1a
收藏数据链接:
官方服务:
资源简介:
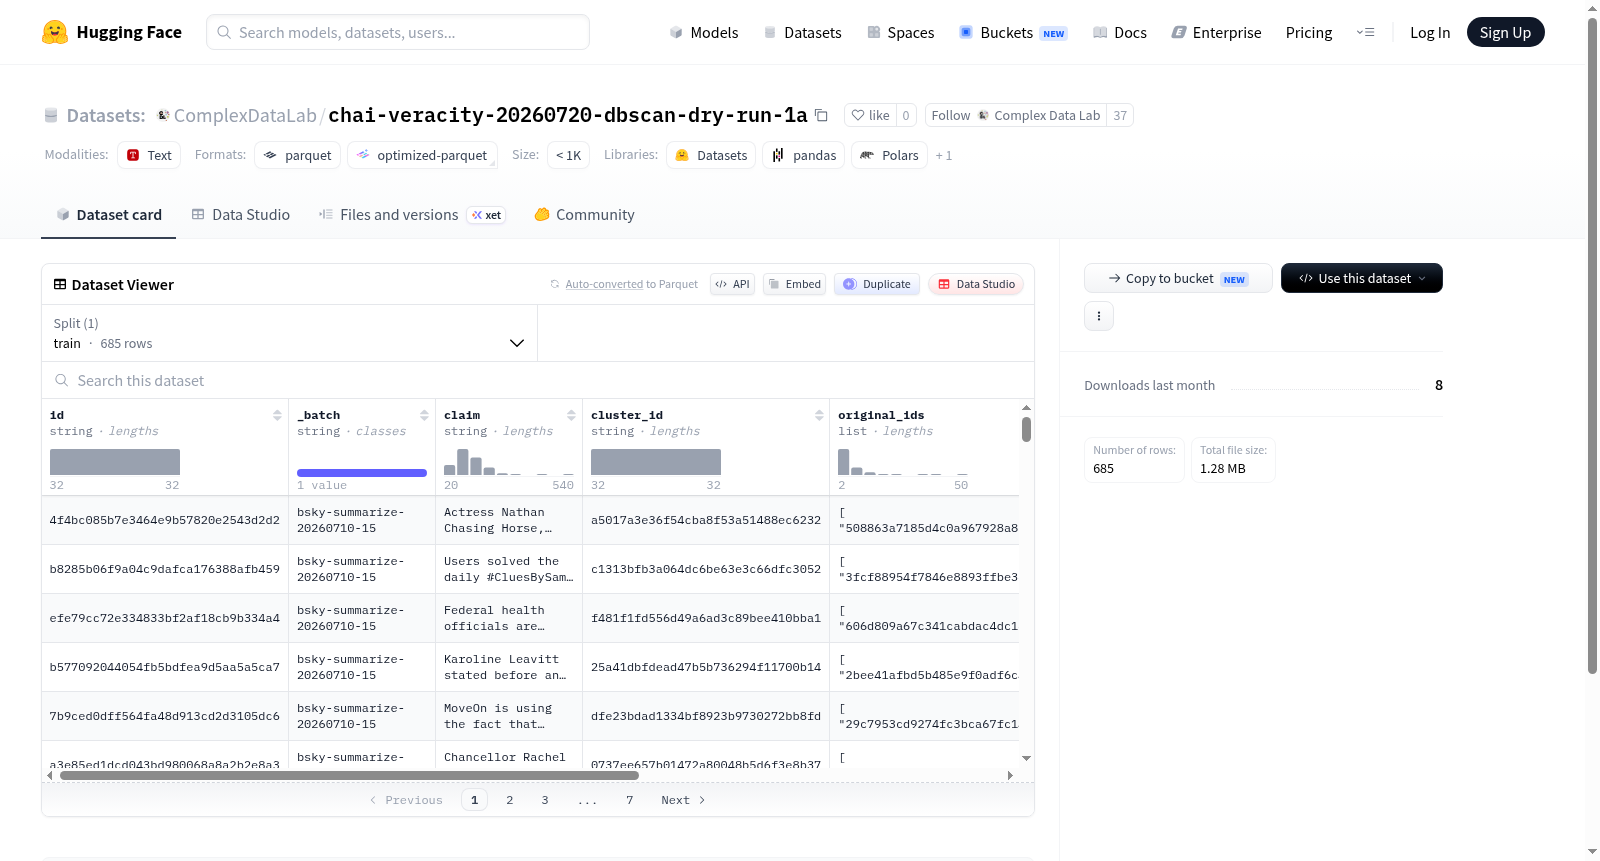
--- dataset_info: features: - name: id dtype: string - name: _batch dtype: string - name: claim dtype: string - name: cluster_id dtype: string - name: original_ids list: string - name: original_texts list: string - name: post_count dtype: int64 splits: - name: train num_bytes: 1345987 num_examples: 685 download_size: 1276256 dataset_size: 1345987 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
ComplexDataLab搜集汇总
数据集介绍
构建方式
该数据集基于DBSCAN聚类算法构建,旨在对社交媒体中围绕特定声明的讨论进行分组归类。原始数据经过预处理后,通过密度聚类方法识别出具有相似内容的帖子簇,并为每个簇分配唯一的cluster_id。数据集包含了来自多个来源的原始文本及其对应的ID,通过聚合同一簇内的帖子形成结构化样本。构建过程注重保留数据的原始语境,同时确保聚类结果的可解释性与稳定性。
使用方法
数据集以HuggingFace Datasets格式提供,默认配置下包含一个训练集(train),共685个样本。用户可通过加载该数据集直接访问各字段,包括id、claim、cluster_id、original_ids、original_texts及post_count。适用于声明级文本分类、聚类质量评估、以及基于聚类的多证据事实核查等任务。使用时可依赖claim字段作为分析对象,或利用original_texts获取细粒度原始证据,灵活适配下游研究需求。
背景与挑战
背景概述
该数据集名为chai-veracity-20260720-dbscan-dry-run-1a,诞生于2026年,由未知研究团队或机构构建,旨在探索社交媒体中声明(claim)真伪验证的聚类方法。数据集聚焦于将相关声明及其原始文本聚合为簇,为虚假信息检测提供结构化资源。其核心研究问题在于通过DBSCAN聚类算法对海量社交媒体帖子进行预分组,以辅助后续的细粒度真伪判别。作为一项中间实验性产物,该数据集展示了将无监督聚类应用于声明验证的潜力,为后续开发更鲁棒的验证系统奠定了基础,尤其在多源文本整合与信息可靠性评估领域具有参考价值。
当前挑战
数据集面临的核心挑战在于所解决的领域问题——社交媒体声明真伪验证的复杂性:单一声明常以多种变体形式传播,需依赖聚类算法有效聚合,但噪声数据、语义模糊及跨主题漂移易导致聚类失真。构建过程中,DBSCAN参数(如邻域半径)的选择缺乏通用标准,且原始文本的多样性(如口语化表达、多语言混合)增加了预处理难度。此外,少量样本(仅685例)与8个字段的有限结构,限制了模型泛化能力,且缺乏人工标注的真值标签,使得聚类质量评估依赖于外部校验,进一步放大了结果的不确定性。
常用场景
经典使用场景
在信息验证与虚假信息检测领域,chai-veracity-20260720-dbscan-dry-run-1a数据集为研究者提供了一组经过DBSCAN聚类处理的声明文本及其对应上下文。该数据集的核心价值在于支持基于聚类分析的跨文本一致性验证,经典使用场景包括:通过比较同一聚类内多条文本的语义差异来识别潜在的虚假信息模式,或利用聚类标签作为弱监督信号训练自动化的谣言检测模型。此外,数据集中提供的原始文本列表和聚类标识,使得多文档摘要、观点聚合以及社交媒体叙事追踪等任务得以在结构化数据基础上高效开展。
解决学术问题
该数据集直面社交媒体中声明文本的碎片化与匿名化挑战,通过DBSCAN聚类将分散的原始言论归并为有意义的语义簇,有效解决了跨文本间真实性对比的基准缺失问题。学术界常藉此数据集探究如何从大规模无标注文本中自动挖掘谎言模式与一致性偏差,推动着弱监督学习、对比学习以及图神经网络在信息核验领域的理论创新。其意义在于为验证声明真实性这一长期难题提供了可量化的实验平台,使得模型能够在缺乏昂贵人工标注的情况下学习到区分真伪的判别特征,从而显著降低了虚假信息研究的入门门槛并加速了相关方法的迭代。
实际应用
在实际部署中,该数据集最适合用于构建社交媒体平台的实时内容审核辅助系统,通过对用户发布的声明进行聚类分析,帮助审核人员快速识别重复传播的误导性信息。新闻机构可利用其聚类结果自动生成可疑声明核查清单,提升事实核查工作效率。此外,在舆情监控与危机沟通场景下,该数据集支撑的模型能够追踪同一事件的多种变体陈述,辅助制定差异化的辟谣策略,减少虚假信息对公共安全的潜在危害。
数据集最近研究
最新研究方向
在虚假信息检测与事实核查领域,该数据集聚焦于社交媒体中声明的聚类分析,通过DBSCAN算法对原始文本进行无监督分组,揭示了热点事件中观点传播的集群化特征。研究前沿在于利用聚类结果追踪虚假信息的扩散路径,评估不同声明的社会影响力,并为自动化事实核查系统提供结构化训练数据。这一方向与当前社交媒体治理中的信息污染问题紧密相关,推动了从单一声明验证向多源关联分析的范式转变,具有优化预警机制和提升辟谣效率的显著意义。
以上内容由遇见数据集搜集并总结生成


