
alinf/hikma_one_shot
收藏官方服务:
资源简介:
HIKMA(人文与伊斯兰知识多任务评估)基准数据集,包含多个波斯语配置,涵盖古兰经注释(tafsir)、修辞(balagha)、记忆(memorization)和苏拉信息(surah_info)等任务,每个配置提供问题、四个选项和答案,用于评估模型在伊斯兰知识相关多任务上的性能。
HIKMA (Humanities and Islamic Knowledge Multitask Assessment) Benchmark, containing multiple Persian configurations covering tasks such as Quranic commentary (tafsir), rhetoric (balagha), memorization, and surah information, each providing questions, four choices, and answers for evaluating model performance on multitask Islamic knowledge.
提供机构:
alinf搜集汇总
数据集介绍
构建方式
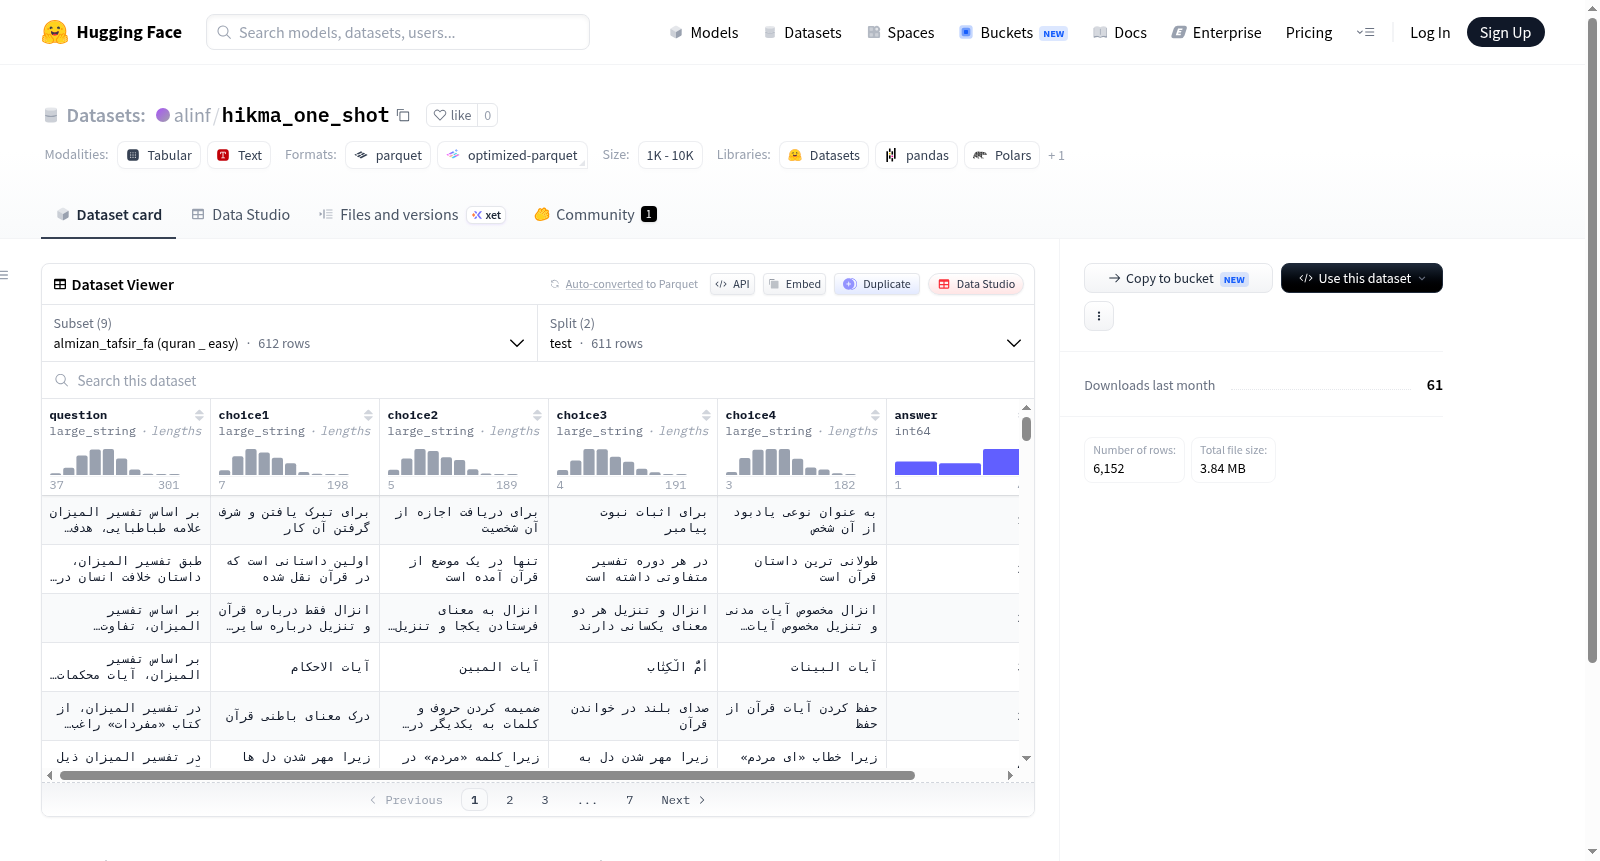
HIKMA(人文学科与伊斯兰知识多任务评估)基准测试中的一子集,名为hikma_one_shot,其构建方式基于对《古兰经》及伊斯兰经典知识的深度挖掘与结构化处理。该数据集通过从多个权威波斯语注释源(如almizan_tafsir、nemooneh_tafsir)和语法修辞学科(quran_balagha_nahw)中提取问题与答案对,并依据难易程度划分为“easy”与“hard”两种配置。每个样本包含一个问题、四个选项(choice1至choice4)以及一个整数型答案字段,同时辅以上下文信息,从而形成适用于多选问答任务的标准化评测框架。
特点
该数据集最显著的特点在于其丰富的多学科覆盖与精细化的难度分层。其涵盖《古兰经》注释、古兰学知识、经文背诵以及篇章信息等多个维度,共计八种配置,总计超过5,000个测试样本。每个配置均配备了独立的开发集与测试集,开发集仅含一个示例,旨在评估模型在零样本或单样本情境下的泛化能力。此外,问题表述紧扣波斯语伊斯兰学术传统,兼顾语言难度与知识深度,可有效检验模型在特定宗教文化语境下的语言理解与推理水平。
使用方法
使用该数据集时,研究者可依据实验需求选择指定的配置名称(config_name)进行加载,例如通过HuggingFace数据集库直接调用。每个配置中的test分片用于评估,dev分片提供单样本示例以支持上下文学习或提示工程。模型需根据给定的问题及四个候选选项,输出对应答案索引(0-3)。该数据集尤其适合用于评测大规模语言模型在波斯语伊斯兰知识领域的问答表现,为跨语言与文化的人文学科推理提供可靠的基准支持。
背景与挑战
背景概述
HIKMA(Humanities and Islamic Knowledge Multitask Assessment)基准测试集由研究团队于2026年4月创建,旨在评估语言模型在伊斯兰知识与人文领域的多任务理解能力。该数据集以《古兰经》为核心,涵盖多部权威注疏(如Al-Mizan、Nemouneh)、修辞语法(Balagha Nahw)、背诵(Memorization)及章节信息(Surah Info)等九个子配置,每个配置按难度分为easy与hard两级。HIKMA聚焦于阿拉伯语—波斯语语境下的宗教文本推理,填补了现有自然语言处理基准在神学与古典学术交叉领域的空白,为跨学科人工智能研究提供了标准化评估框架。
当前挑战
HIKMA数据集的核心挑战包括:其一,所解决的领域问题是对古典宗教文本的深度理解,要求模型掌握注疏中的多义性阐释、修辞隐喻及历史语境,超越了常规的文本分类或事实检索范畴;其二,构建过程中需面对注疏文献的稀缺性与专家标注的高成本,每个配置仅包含少量开发样本(多为1条),而测试集规模从133到2894条不等,易受数据稀疏性影响;其三,多音化、阿拉伯语形态变化及波斯语语法差异导致选择题选项的语义区分极为微妙,对模型推理的稳定性构成严峻考验。
常用场景
经典使用场景
在伊斯兰文化与人文科学交叉领域,HIKMA基准数据集以其精细的多任务设置,成为评估大语言模型在宗教文本理解上表现的核心工具。该数据集涵盖《古兰经》背诵、章节信息、修辞语法及多种波斯语注解等内容,巧妙地将经文章节、教义知识、语言特征与难度层次融为一体。研究者通过在此数据集上进行零样本或少样本问答测试,能够系统地衡量模型在宗教知识检索、经文理解与多选项推理上的综合能力,从而推动语言模型在低资源、高知识密度领域的发展。
衍生相关工作
围绕HIKMA数据集已衍生出一系列引领伊斯兰NLP领域发展的工作。相关研究包括针对《古兰经》理解的专用微调模型、融合多源伊斯兰知识的多任务学习框架,以及探索经典文本中修辞与语法特征的预训练语言模型改进方案。这些工作不仅验证了数据集在诱导模型习得宗教领域常识中的有效性,也催生了诸如跨语言伊斯兰问答系统与古兰经智慧助手的原型。此外,HIKMA还作为重要基准被多个中东及北非地区学术机构用于评测其本地化语言模型,推动了区域级人文计算研究生态的繁荣。
数据集最近研究
最新研究方向
hikma_one_shot数据集作为人文与伊斯兰知识多任务评估基准(HIKMA)的重要组成部分,近期研究聚焦于推动低资源语言环境下大语言模型在宗教典籍理解与推理能力上的深度评测。该数据集通过结构化的多选题设计,涵盖《古兰经》注释(如Al-Mizan、Nemouneh)、修辞语法、章节记忆及基本信息等多个维度,为模型在波斯语领域的细粒度语义理解与知识迁移评估提供了高质量标杆。当前前沿方向正围绕构建跨领域、跨难度的标准化评测体系展开,旨在揭示模型在宗教文本深层逻辑推理中的局限性,对促进多模态、多任务学习的鲁棒性发展具有重要影响。
以上内容由遇见数据集搜集并总结生成


