omnimcp_legaltech_contractops_village_teaser
收藏资源简介:
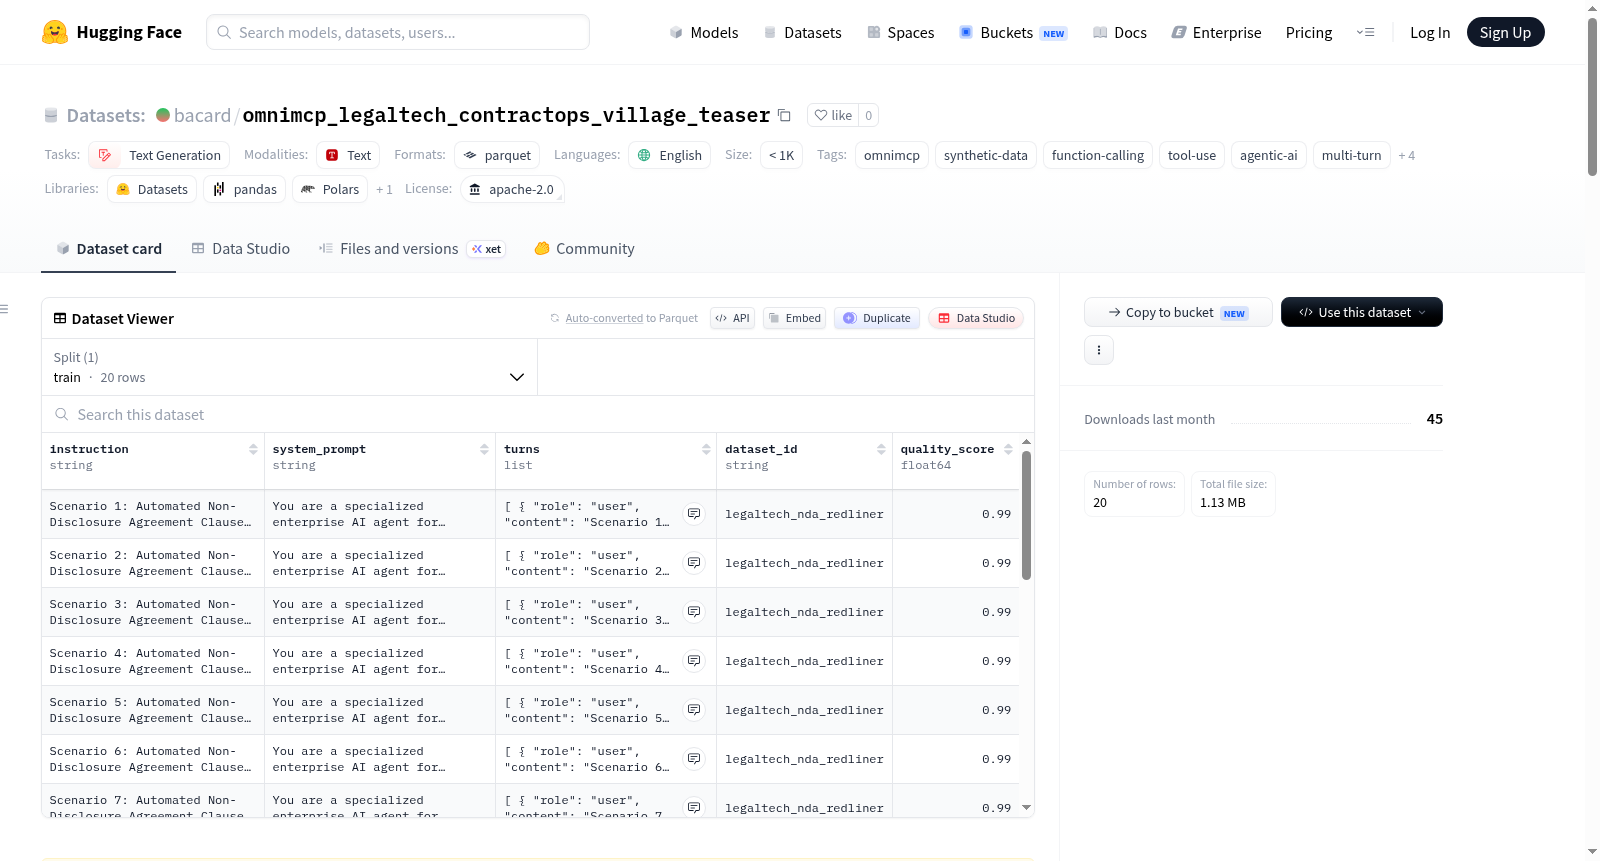
OmniMCP LegalTech & Regulatory ContractOps Village 企业合规套件(评估预告片)是一个英语多轮对话合成数据集,专为法律科技与合同运营领域的企业合规任务设计。该数据集属于 OmniMCP 模块化生态系统的 Village 层级,其核心目标是自动化合同审查流程,具体包括:NDA 条款自动红线标注、EU AI Act 附件 III 高风险分类、以及 GDPR 第 28 条数据处理验证。数据集包含少于 1000 个样本,每个样本均为多轮对话形式,支持函数调用和工具使用。所有数据均为合成生成,并经过严格的质量控制:通过 AST 和 Pydantic 验证确保零语法错误,符合 GDPR/DSGVO 数据保护要求,并依据 EU AI Act 第 50 和 53 条声明合成出处。该数据集适用于对话系统、文本生成、函数调用、工具使用、多轮 agentic AI 等任务的训练和评估。
OmniMCP LegalTech & Regulatory ContractOps Village Enterprise Compliance Suite (Evaluation Teaser) is a synthetic English multi-turn dialogue dataset designed for enterprise compliance tasks in the legal tech and contract operations domain. It belongs to the Village level of the OmniMCP modular ecosystem, with the core goal of automating contract review processes, including: automatic redlining of NDA clauses, high-risk classification under EU AI Act Annex III, and data processing verification under GDPR Article 28. The dataset contains fewer than 1000 samples, each in a multi-turn dialogue format, supporting function calling and tool use. All data is synthetically generated and undergoes strict quality control: AST and Pydantic validation ensure zero syntax errors, compliance with GDPR/DSGVO data protection requirements, and synthetic provenance declaration according to EU AI Act Articles 50 and 53. The dataset is suitable for training and evaluation of tasks such as dialogue systems, text generation, function calling, tool use, and multi-turn agentic AI.
OmniMCP - LegalTech & Regulatory ContractOps Village - Enterprise Compliance Suite (Evaluation Teaser)
数据集概述
这是一个免费评估预览版的多轮对话与文本生成数据集,专注于法律科技与合规领域的合同运营场景,由OmniMCP项目发布。完整生产版可通过Gumroad平台获取商业许可证。
核心价值主张:通过自动化的NDA(保密协议)条款修订、EU AI Act Annex III高风险分类,以及GDPR第28条数据处理验证,将合同审查周期缩短80%。
基本信息
- 语言:英语
- 许可证:Apache 2.0
- 任务类型:对话(conversational)、文本生成(text-generation)
- 数据集规模:少于1K条样本(n<1K)
- 数据标签:omnimcp、synthetic-data(合成数据)、function-calling(函数调用)、tool-use(工具使用)、agentic-ai、multi-turn(多轮对话)、unsloth、axolotl、vllm、legaltech_contractops_village
质量与法律溯源
- 语法错误保证:0.0%语法错误,经过严格的AST与Pydantic验证
- 隐私合规:100% GDPR/DSGVO合规,使用经数学消毒的RFC 2606数据
- 合成数据声明:完整遵循EU AI Act第50条和第53条关于合成数据来源的声明规范
使用示例
可通过Hugging Face datasets 库直接加载:
python from datasets import load_dataset
加载免费评估数据集
dataset = load_dataset("bacard/omnimcp_legaltech_contractops_village_teaser") print(f"Loaded {len(dataset[train])} verified multi-turn training samples!") print(dataset[train][0])
所属体系:4层OmniMCP模块化架构
该数据集属于OmniMCP产品体系中的第3层“村庄(Village)”,该层级提供交钥匙行业解决方案,每个方案整合4个专业“房屋(House)”,标准版价格区间为99€-249€,企业版为249€-599€。本数据集对应“LegalTech & Regulatory ContractOps”村庄,商业版售价249€,覆盖NDA条款修订、EU AI Act审计与GDPR数据处理协议审计等场景。
完整生态系统包含4个层级(砖块Brick、房屋House、村庄Village、大都会Metropolis),共40个活跃商业产品,可通过Gumroad平台(bacardy.gumroad.com)购买。