kimi-lora-memorization-vision-codes
收藏资源简介:
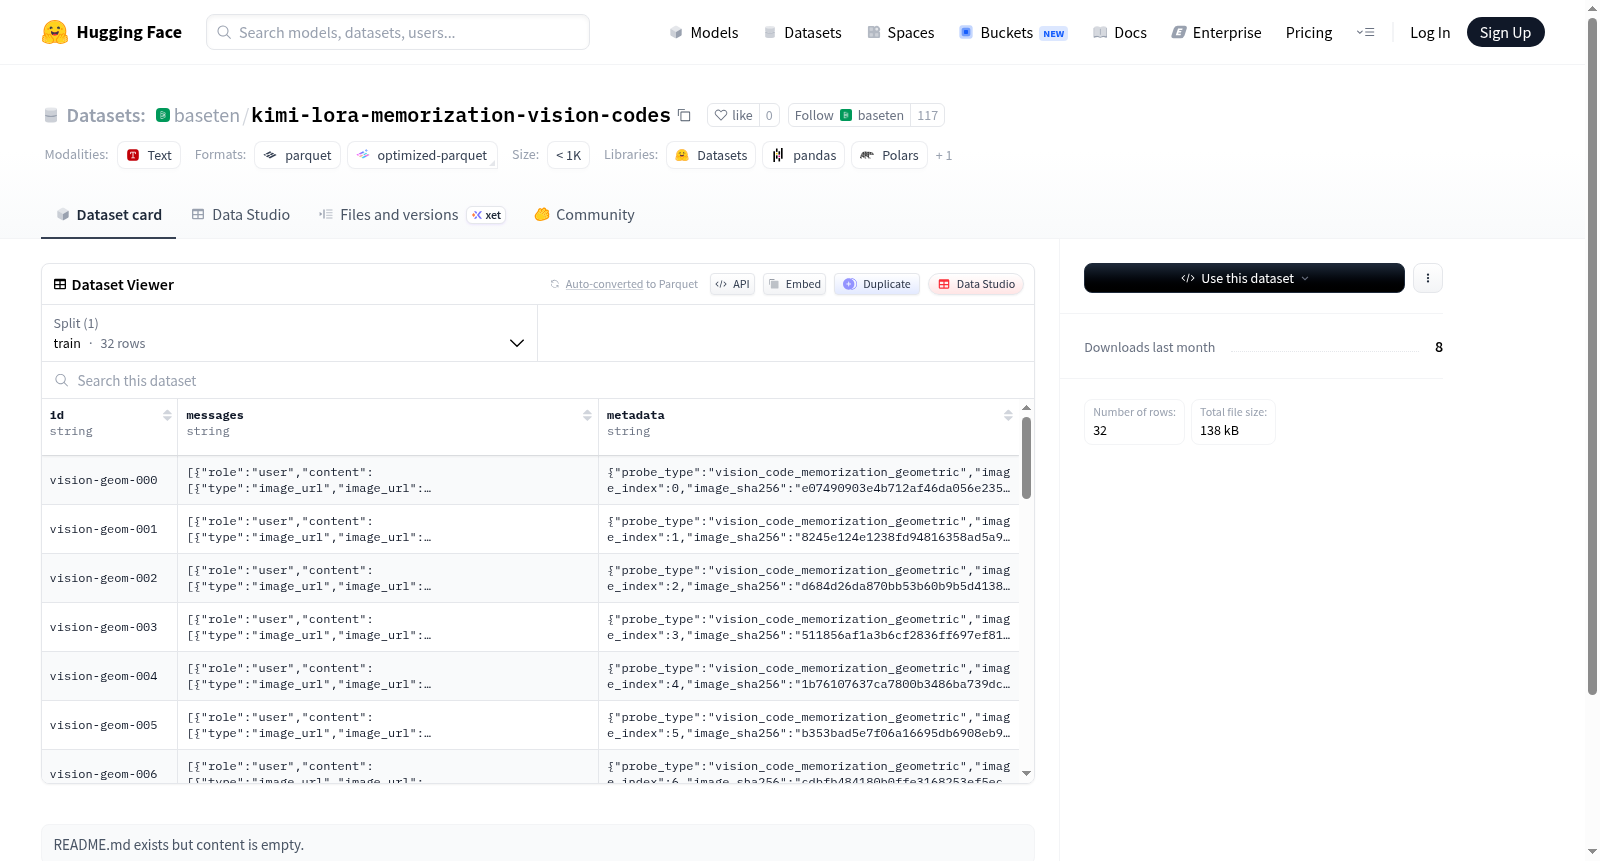
该数据集是一个训练数据集,包含32个样本,总大小为170138字节,下载大小为135557字节。数据集由三个字段组成:id(字符串类型,用于标识样本)、messages(字符串类型,可能包含消息或文本内容)和metadata(字符串类型,可能包含元数据信息)。数据仅划分为训练集,未提供关于数据集背景、目的或具体应用场景的详细描述。
This dataset is a training dataset containing 32 samples, with a total size of 170138 bytes and a download size of 135557 bytes. It consists of three fields: id (string type, used to identify samples), messages (string type, possibly containing message or text content), and metadata (string type, possibly containing metadata information). The data is only divided into a training set, and no detailed description of the datasets background, purpose, or specific application scenarios is provided.
根据您提供的数据集详情页面信息,以下是该数据集的概述:
数据集名称:kimi-lora-memorization-vision-codes
基本信息
- 数据集地址:https://huggingface.co/datasets/baseten/kimi-lora-memorization-vision-codes
特征(Features)
该数据集包含以下三个特征字段:
- id:字符串类型,用于唯一标识每条数据。
- messages:字符串类型,包含对话或消息内容。
- metadata:字符串类型,存储元数据信息。
数据集划分(Splits)
- 训练集(train):共32个样本,数据大小约为170,138字节。
数据集配置(Configs)
- 默认配置(default):训练集数据文件路径为
data/train-*。
大小信息
- 下载大小:约135,557字节。
- 数据集大小:约170,138字节。
用途说明
根据数据集名称及字段结构,该数据集可能用于训练与Kimi相关的视觉代码记忆任务的LoRA模型。