
遇见数据集

CongLab-Research/LabHorizon-3D-Asset-Perception

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

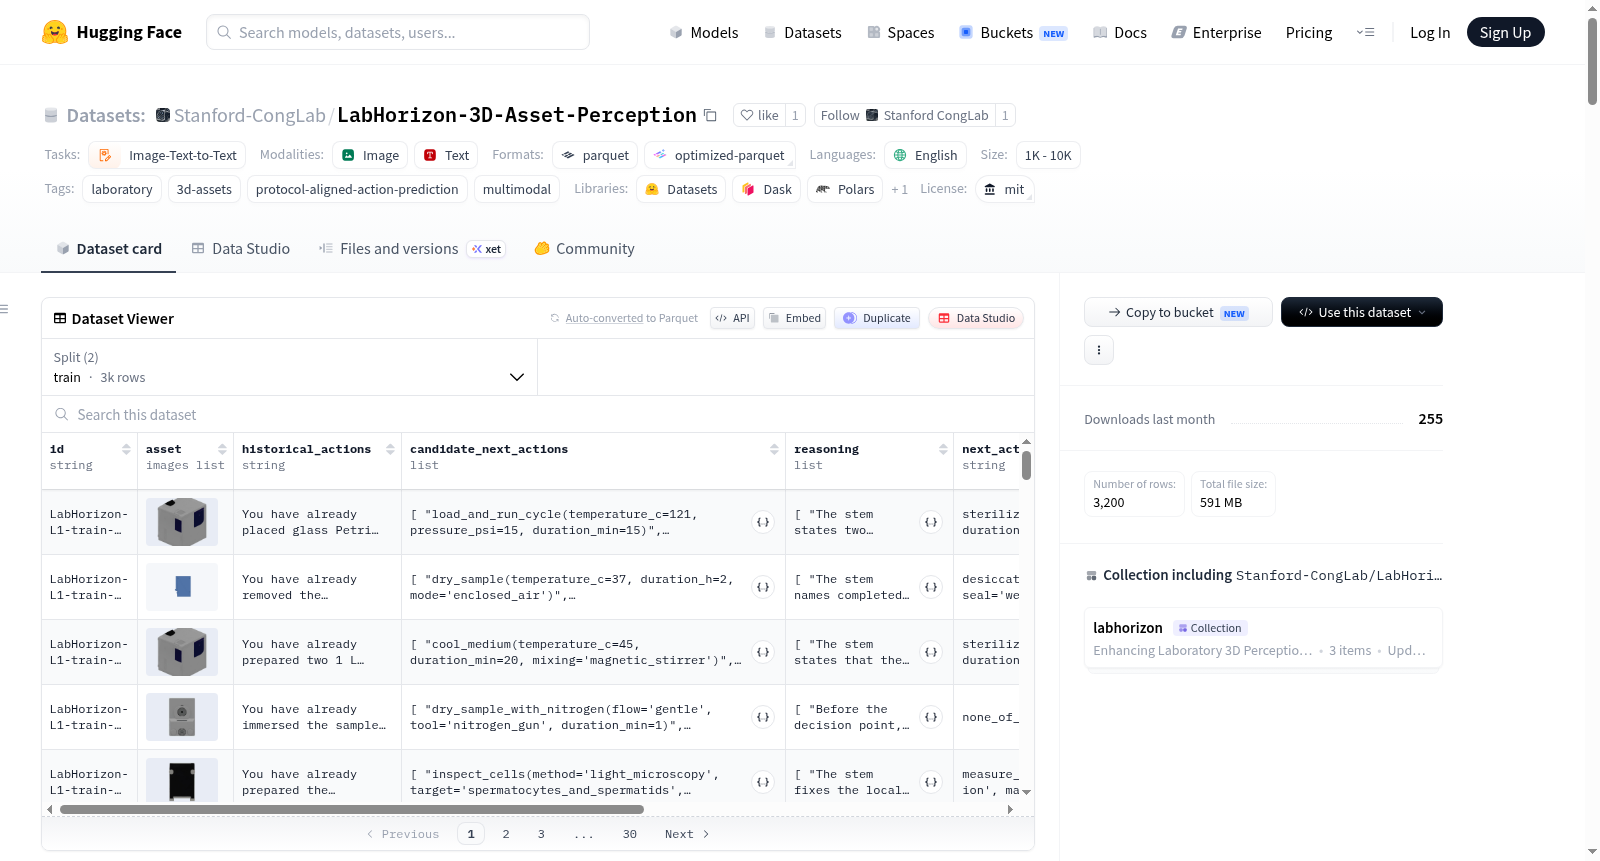
该数据集是LabHorizon项目的Level 1部分,专注于实验室3D资产感知和协议条件下的下一个动作预测。每个样本包含同一实验室资产的三个渲染视图、历史实验动作以及一组候选下一个动作。任务目标是选择与实验协议一致的下一个动作。该任务并非通用的图像描述或视觉问答,而是要求模型将实验室3D感知与协议条件下的动作预测相结合:视觉资产需与实验历史匹配,所选下一个动作需与邻近协议步骤和细粒度参数保持一致。数据集包含3,000个训练样本和200个测试样本,输入包括资产图像、历史动作和候选下一个动作,输出为正确的下一个动作。

This dataset is the Level 1 split of LabHorizon, focusing on laboratory 3D asset perception and protocol-conditioned next-action prediction. Each example pairs three rendered views of the same laboratory asset with historical experimental actions and a set of candidate next actions. The target is the protocol-consistent next action. The task is not generic image captioning or visual question answering; it asks whether a model can connect laboratory 3D perception with protocol-conditioned action prediction: the visual asset should match the experimental history, and the selected next action should be consistent with nearby protocol steps and fine-grained parameters. The dataset includes 3,000 training samples and 200 test samples, with inputs comprising asset images, historical actions, and candidate next actions, and the output being the gold next action.
提供机构:
CongLab-Research
搜集汇总
数据集介绍
CongLab-Research/LabHorizon-3D-Asset-Perception 数据集图片
构建方式
在实验室自动化与智能感知日益交融的背景下,LabHorizon-3D-Asset-Perception数据集应运而生。其构建路径精巧而严谨:首先,从实验室三维资产库中提取多视角渲染图像,每个样本涵盖同一资产的三张不同角度视图;随后,这些视觉资产被匹配至真实实验协议中的相关阶段,并结合历史操作步骤与当前实验状态,形成具有上下文的动作预测任务。为进一步提升挑战性,构建过程引入了邻近阶段干扰项与数值扰动,以增强模型的判别能力。最后,经过人工审查与自动化校验器的双重验证,确保图像质量、标注一致性及候选动作的合理性,方形成最终的数据集。
特点
该数据集的核心特色在于其深度融合了实验室三维感知与协议对齐动作预测两大前沿课题。每个样本并非孤立的图像分类任务,而是要求模型在理解三维资产视觉特征的基础上,结合实验历史上下文,从候选动作中甄选出符合协议规范的下一步操作。这种设计迫使模型跨越视觉感知与符号推理的鸿沟,同时考验其对精细参数(如容量、温度、转速)的敏感度。此外,数据集提供了3,000条训练样本与200条测试样本,并附带了参考推理步骤,为模型的可解释性研究提供了宝贵素材。
使用方法
使用者可通过HuggingFace Datasets库轻松加载该数据集,调用load_dataset函数即可获取包含多视图图像、历史动作、候选动作及黄金标准动作的样本。在评估环节,官方代码库提供了标准化流水线,支持多种主流大语言模型的直接提示评估。模型需在推理后以“Final Next Action: X”格式输出最终答案,其中X为候选动作的字母标识或精确动作描述。初始实验已表明,结合训练与智能体框架(如Actor-Simulator-Selector)可显著提升预测准确率,为实验室场景下的具身智能研究开辟了新路径。
背景与挑战
背景概述
LabHorizon-3D-Asset-Perception数据集由斯坦福大学CongLab团队于2026年5月发布,旨在解决实验室内三维感知与协议对齐动作预测的交叉难题。该数据集属于LabHorizon项目的Level 1层级,包含3000个训练样本和200个测试样本,每个样本由同一实验室资产的三维渲染视图、历史实验动作及候选下一步动作组成。其核心研究问题在于评估模型能否将实验室三维资产视觉信息与动态实验协议上下文相结合,从而精准预测符合协议规范的下一步操作。该数据集推动了多模态大模型在科学实验自动化中的应用,为实验室智能感知与规划领域提供了标准化评估基准,对生物医学、化学等领域的自动化研究具有重要影响力。
当前挑战
该数据集面临的挑战主要体现在两方面。在领域问题层面,传统的多模态模型难以将三维视觉感知与协议对齐的动作预测有效融合,模型需从资产多视图图像中提取功能性特征,并联系协议步骤与数值参数(如容器体积、试剂浓度),以区分干扰动作和正确操作。在构建过程中,团队需设计复杂的数据流水线,包括资产三维渲染、协议上下文匹配、候选动作生成及难度控制(如引入邻近阶段干扰项与数值扰动),同时通过人工审查与自动化验证器确保图像质量、动作一致性与数据无泄漏,整个过程需兼顾规模、多样性与标注可靠性的平衡。
常用场景
经典使用场景
LabHorizon-3D-Asset-Perception数据集的核心应用场景聚焦于实验室环境下的三维资产感知与协议对齐动作预测。该数据集通过提供每个实验室资产的三维渲染视图、历史实验操作记录以及候选下一步动作,构建了一个多模态视觉与语义联合推理任务。经典用法是让模型根据给定的资产图像和历史操作上下文,从多个候选动作中准确选择出与实验协议一致的下一个步骤。这一任务超越了传统的图像描述或视觉问答,要求模型具备将视觉资产特征与实验协议步骤进行精细匹配的能力,尤其考验对仪器功能、操作参数和实验逻辑的综合理解。
实际应用
在实际应用层面,该数据集为生物医学实验室的智能化转型提供了核心支撑。基于该数据集训练的模型可直接应用于实验辅助系统,帮助研究人员实时识别当前使用的仪器设备,并结合实验协议历史记录推荐下一步标准操作。例如,在涉及蒸汽灭菌或其他多步骤化学流程时,系统能够根据三维视觉输入精确判断反应容器类型、体积规格和当前实验阶段,自动过滤干扰选项并输出包含具体参数(如搅拌速度、温度设置)的规范操作指令。这一能力在无人值守实验、远程操作监控以及高危环境下的自动化实验执行中具有重要价值,可大幅降低人为操作失误,提升实验流程的标准化程度和生产效率。
衍生相关工作
围绕该数据集已衍生出多项具有影响力的研究工作。最显著的是基于Qwen3.6-35B-A3B基础模型训练并结合Actor-Simulator-Selector智能体框架的工作,将Level 1的下一步动作准确率从直接提示的0.475提升至0.665,证明了可优化学习循环在该任务中的有效性。该智能体框架中,训练后的Actor负责生成推理和候选动作预测,Simulator检查每个候选动作隐含的符号化协议状态,Selector则选择最匹配目标状态的最终动作。此外,该数据集还被用于构建公开的实验室视觉推理评测排行榜,吸引了Grok 4.3、GPT-5.5、Kimi K2.6等前沿模型的系统化对比评估,推动了实验室视觉感知与规划领域的整体进展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

