
遇见数据集

bismarck91/sm-cv-en-id

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

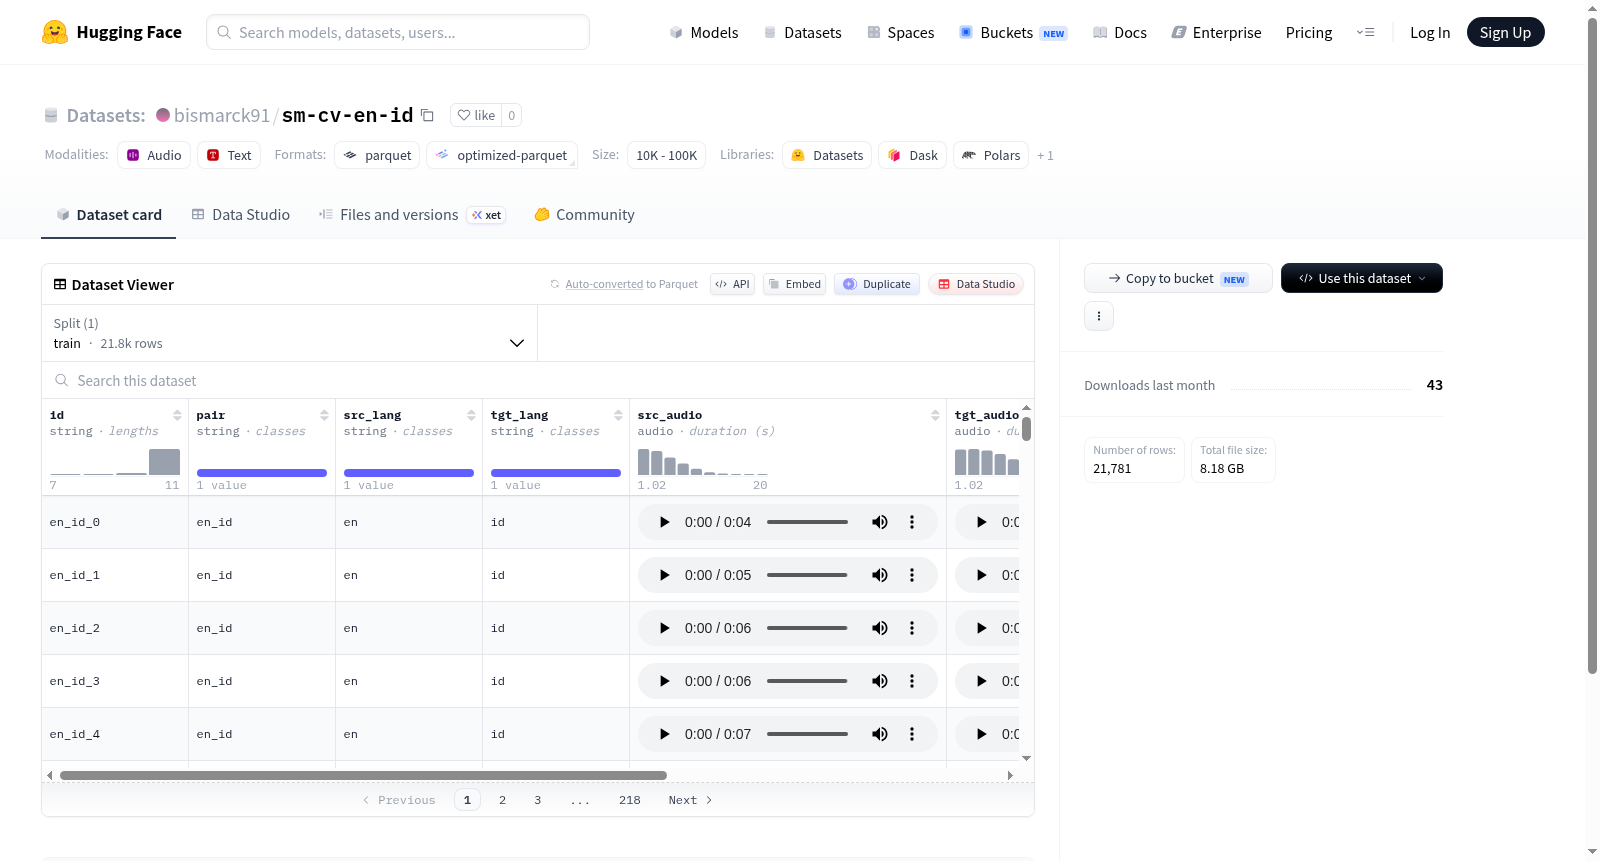
这是一个多语言语音翻译数据集,包含源语言和目标语言的成对数据。每个样本包括:唯一标识符(id)、语言对标识(pair)、源语言代码(src_lang)、目标语言代码(tgt_lang)、源语言音频(src_audio,采样率16kHz)、目标语言音频(tgt_audio,采样率16kHz)、源语言文本标记(src_tokens)和目标语言文本标记(tgt_tokens)。数据集仅包含训练集,共21781个样本,用于语音到语音或语音到文本的翻译任务。

This is a multilingual speech translation dataset containing paired data for source and target languages. Each sample includes: unique identifier (id), language pair identifier (pair), source language code (src_lang), target language code (tgt_lang), source language audio (src_audio, 16kHz sampling rate), target language audio (tgt_audio, 16kHz sampling rate), source language text tokens (src_tokens), and target language text tokens (tgt_tokens). The dataset only contains a training split with 21,781 examples, intended for speech-to-speech or speech-to-text translation tasks.
提供机构:
bismarck91
搜集汇总
数据集介绍
bismarck91/sm-cv-en-id 数据集图片
构建方式
该数据集面向跨语言语音翻译任务构建,聚焦于印尼语与英语之间的双向转换。数据来源于Common Voice开源语音语料库,通过选取同一说话人分别朗读印尼语和英语对应文本的语音片段,经过严格的对齐与筛选,形成成对的平行语音数据。每个样本包含源语言与目标语言的音频文件(采样率为16kHz)、对应的文本令牌序列以及语言标签,确保了模态间的一致性与可训练性。
特点
sm-cv-en-id数据集具备成对语音与文本的双模态结构,每条样本同时提供源语言和目标语言的音频及令牌序列,可直接用于端到端语音翻译模型的训练。数据集规模约21,781条样本,总存储量达8.8GB,在中等规模数据集中具备较好的覆盖度。其采用固定16kHz采样率统一编码,降低了预处理复杂度,且明确标注了语言方向与配对标识,便于实验配置与结果复现。
使用方法
该数据集预划分为训练集,用户可通过HuggingFace Datasets库按默认配置加载。使用时需指定音频列和令牌列作为输入与目标,适用于搭建基于序列到序列的语音翻译流水线。研究人员可结合预训练声学模型和文本解码器进行微调,或将其作为低资源语对场景下的基准数据集。建议在加载时设置采样率为16kHz以匹配预设参数,并利用语言标签控制翻译方向。
背景与挑战
背景概述
在跨语言语音翻译领域,高质量的平行语音数据资源极为稀缺,严重制约了多模态翻译系统的发展。sm-cv-en-id数据集应运而生,它由印尼语(id)与英语(en)的语音对构成,采样率为16kHz,包含21,781条训练样本,数据规模近9GB。该数据集主要服务于语音到语音翻译的研究任务,致力于弥补低资源语种对在端到端翻译中的短板。其创建旨在推动神经语音翻译模型在印尼语与英语之间的鲁棒对齐与生成能力,对未来多语言语音翻译系统的泛化性具有重要的推动意义。
当前挑战
该数据集所面临的首要挑战在于低资源语种对的语音翻译任务本身,即印尼语和英语的语音数据在公开领域极度匮乏,导致模型易出现过拟合与泛化能力不足的问题。同时,语音对的收集与对齐过程充满技术难度,包括音频的时长差异、音素级对齐的精确性、以及不同说话人口音与语速的多样性。此外,数据构建环节中需确保双语音频在语义与时间维度上的严格对应,并在有限样本下维持高信噪比与一致性,从而对数据清洗与标注质量提出了严苛要求。
常用场景
经典使用场景
sm-cv-en-id数据集是针对印尼语与英语之间语音翻译任务精心构建的平行语料库,涵盖21781条经过对齐的语音-文本对。其经典使用场景在于跨语言语音翻译系统的训练与评估,尤其是在资源稀缺的印尼语方向上。研究者可以基于该数据集构建端到端的语音到语音翻译模型,或采用级联方式先进行语音识别再执行文本翻译,从而探索低资源语言对在复杂噪声环境下的鲁棒性翻译能力。此外,数据集中提供的音频特征与词元化表示,为多模态融合与序列到序列学习提供了标准化的实验基准。
实际应用
在实际应用中,sm-cv-en-id数据集支撑了印尼语与英语间实时语音翻译系统的开发,服务于跨国商务沟通、旅游协助以及多语言客服场景。例如,基于该数据集训练的模型可集成至移动翻译应用,帮助印尼语使用者与英语使用者进行无障碍对话。此外,在新闻播报、学术讲座及政府多语言服务平台中,该数据集衍生的技术能够实现语音内容的即时跨语言转写与翻译,极大提升信息获取效率。其在语音助手与智能硬件中的潜在植入,使得低资源语言用户也能享受便捷的语音交互体验。
衍生相关工作
基于sm-cv-en-id数据集,衍生了一系列具有影响力的研究工作。早期工作聚焦于构建基于Transformer的端到端语音翻译基线,并验证了预训练语音模型如wav2vec 2.0在低资源语言对上的微调效果。后续研究引入对比学习与跨语言知识蒸馏策略,有效缩小了印尼语与英语之间语义鸿沟。同时,该数据集被用作多任务学习框架的测试床,探讨语音识别与翻译任务联合训练对性能的提升。近期,结合大语言模型的语音翻译探索也以此数据集为起点,开创了低资源语言与先进生成模型交融的新方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

