pakistan-notice-helper-traces
收藏资源简介:
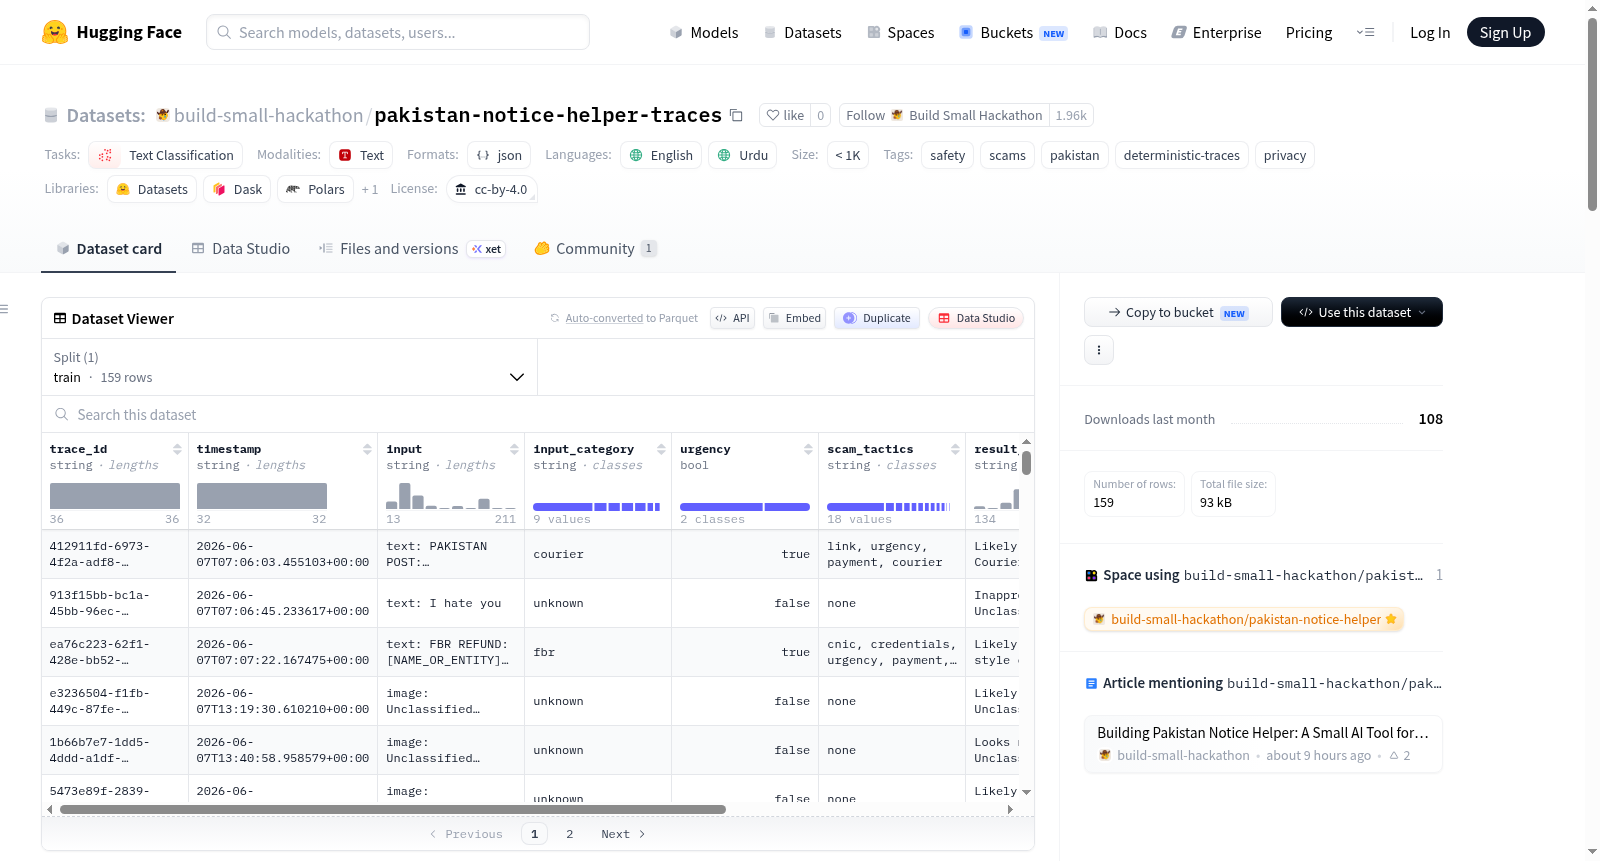
巴基斯坦通知助手隐私安全轨迹数据集包含巴基斯坦通知助手诈骗检查请求的紧凑、确定性元数据。该数据集不包含原始消息文本、图像字节、个人身份信息或模型推理过程,所有字段均为标量字符串、数字或布尔值,确保隐私安全。数据集字段包括轨迹ID、时间戳、经过严格脱敏的输入文本(限500字符)或固定模板的图像描述、输入类别(如快递、银行、FBR)、紧急程度布尔信号、结果摘要、诈骗策略标签以及风险标签和回复草稿策略等扁平化结果列。数据来源于应用中的种子示例(6个公开案例)和运行时操作日志,但需注意种子数据仅用于说明,运行时数据可能包含重复请求和未分类记录。该数据集适用于文本分类任务,特别是与诈骗检测、安全评估相关的场景,支持英语和乌尔都语。使用时应遵循数据集的局限性说明,包括正则表达式检测的近似性、运行时频率不代表总体分布、隐私脱敏可能遗漏非常规信息等。数据集采用CC BY 4.0许可证发布。
The Pakistan Notification Assistant Privacy-Safe Trajectory Dataset contains compact, deterministic metadata for scam check requests from the Pakistan Notification Assistant. It does not include raw message text, image bytes, personally identifiable information, or model inference processes; all fields are scalar strings, numbers, or booleans to ensure privacy safety. Dataset fields include trajectory ID, timestamp, strictly anonymized input text (limited to 500 characters) or fixed-template image descriptions, input categories (e.g., courier, banking, FBR), urgency boolean signals, result summaries, scam strategy labels, and flattened result columns like risk labels and reply draft strategies. Data is sourced from seed examples in the app (6 public cases) and runtime operation logs, but note that seed data is for illustration only, and runtime data may contain duplicate requests and unclassified records. This dataset is suitable for text classification tasks, particularly for scam detection and security assessment scenarios, supporting English and Urdu. Usage should adhere to the datasets limitations, including approximate regex detection, runtime frequency not representing overall distribution, and potential omission of unconventional information due to privacy anonymization. The dataset is released under the CC BY 4.0 license.
数据集概述
- 名称: Pakistan Notice Helper Privacy-Safe Traces
- 许可协议: CC BY 4.0
- 任务类别: 文本分类
- 语言: 英语、乌尔都语
- 标签: 安全、诈骗、巴基斯坦、确定性轨迹、隐私
目的
该数据集包含关于巴基斯坦通知助手(Pakistan Notice Helper)诈骗检测请求的紧凑、确定性元数据。数据集中不包含隐藏的模型推理或自主智能体轨迹。创建轨迹不会调用额外的AI模型调用,轨迹仅观察现有请求路径,并将其转换为允许列表中的类别、布尔值和固定描述。
字段
- Trace identity: 随机轨迹ID和UTC时间戳
- input: 针对文本提交的经过严格缩减、长度受限的文本,或图像提交的固定模板
image: ...描述 - input_category: 确定性类别,如快递、银行或FBR
- urgency: 确定性布尔值紧急信号
- result_summary: 映射模式的确定性摘要,包括是否已知或未分类,以及风险标签为何重要
- scam_tactics: 可读的逗号分隔策略
- risk_label 和 reply_draft_policy 等平面结果列
每个数据集单元格均为标量字符串、数字或布尔值,不包含字典或嵌套对象。trace_id 是第一个序列化列,所有检测到的布尔信号合并到单个 scam_tactics 类别列中。
隐私保护
数据集从不存储以下内容:
- 原始消息文本
- 截图、图像字节或base64
- URL、电话号码、CNIC、姓名、地址、账户/卡号或追踪号码
- 模型解释、红旗标记、安全步骤文本、回复草稿或原始模型输出
- 异常、凭据、令牌或端点标头
文本轨迹存储严格缩减的形式,最大500字符。正则表达式移除常见URL、电子邮件、电话、CNIC、卡/账号、凭据、地址、追踪ID、长数字和首字母大写的名称或实体。图像仅存储固定描述。
来源
- 种子轨迹: 代表巴基斯坦通知助手附带的六个公开示例
- 运行时轨迹: 可能代表成功、拒绝或失败的请求。轨迹生成本身不会调用模型
种子行是说明性示例,非评估集,六个均具有 Likely scam 标签,不可用于估算类别平衡、准确率、召回率或真实诈骗流行率。运行时行是操作日志,有意保留重复请求。
限制
- 正则表达式信号和类别检测是近似值
- 运行时频率可能反映测试或重复使用,而非总体流行率
- 正则表达式缩减可能遗漏异常的个人或机密信息
- 新颖性未针对外部威胁情报来源进行研究
- 数据集无法重现原始消息或截图
- 风险标签为安全指导,非官方验证
相关链接
- 应用: https://huggingface.co/spaces/build-small-hackathon/pakistan-notice-helper
- 源代码: https://github.com/kingabzpro/pakistan-notice-helper