
fosters/uilyam_folkner_pah_verbeny_output
收藏官方服务:
资源简介:
AudioSet Pipeline Output是由AudioSetPipeline发布的基于分片的数据集导出。
AudioSet Pipeline Output is a shard-based dataset export published by AudioSetPipeline.
提供机构:
fosters搜集汇总
数据集介绍
构建方式
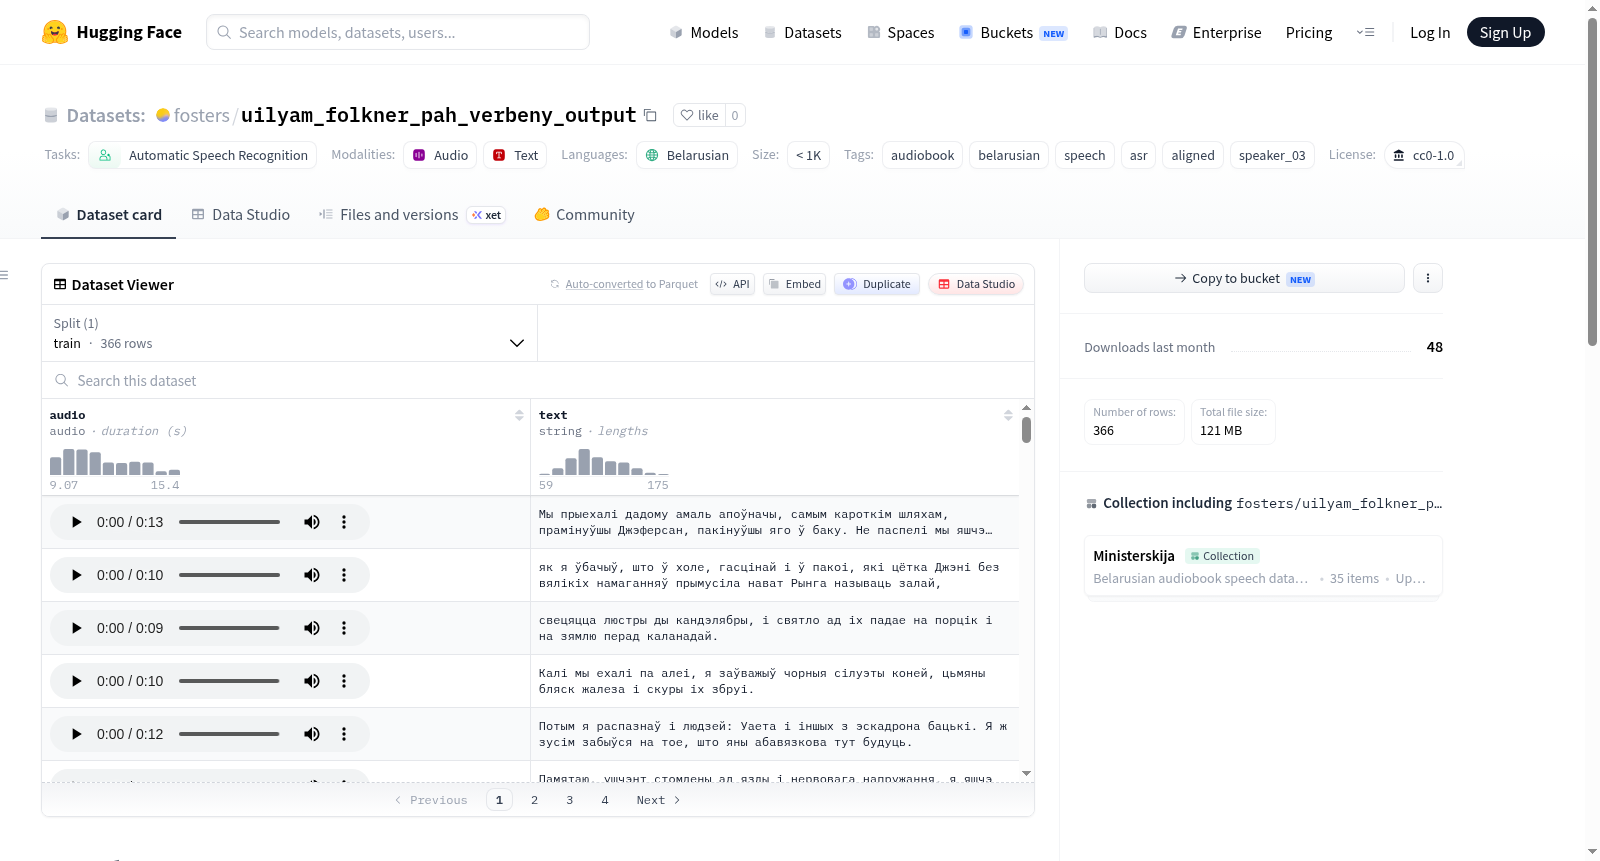
该数据集源自白俄罗斯语有声读物《Пах вербены》(威廉·福克纳作品),隶属于Ministerskija集合。构建过程中,将原始音频分割为约15秒的短片段,借助Gemini模型及两套独立ASR系统进行转录与对齐,仅保留对齐置信度不低于0.95的高质量样本。最终HuggingFace上发布366条有效数据,总音频时长约1小时22分钟。
使用方法
该数据集可直接用于自动语音识别模型的训练与评估,提供预分割的短音频片段与精确对齐的文本标注。用户可加载audio和text字段构建输入-标签对,支持使用HuggingFace的datasets库进行迭代。此外,chunk_uid可用于片段追溯与数据管理,说话人聚类信息则可用于多说话人场景下的模型微调或迁移学习。
背景与挑战
背景概述
该数据集名为“Пах вербены — Уільям Фолкнер”,创建于白俄罗斯语语音识别研究领域,由研究者fosters及其团队在HuggingFace平台上发布,隶属于Ministerskija集合。其核心研究问题聚焦于低资源语言——白俄罗斯语的自动语音识别(ASR)数据集构建,具体针对有声读物场景,通过对齐音频片段与转录文本,提升ASR系统在白俄罗斯语上的性能。数据集包含366条公开记录,总时长约1小时22分钟,通过Gemini和双ASR系统进行高置信度(≥0.95)的对齐,确保了数据质量。该数据集为白俄罗斯语语音研究提供了稀缺的标注资源,推动了该语言在语音技术领域的发展,尤其对文化传承和语言数字化具有重要意义。
当前挑战
数据集面临的挑战包括:1)所解决的领域问题——白俄罗斯语作为低资源语言,缺乏大规模、高质量的语音-文本对齐数据,导致ASR系统在该语言上性能低下;该数据集通过提供高置信度对齐片段,改善了语音识别的准确性和鲁棒性。2)构建过程中的挑战——音频书长度较长,需分割为约15秒的短片段,并与转录文本精确对齐;为此采用了Gemini模型和两套独立ASR系统进行双重验证,确保对齐置信度≥0.95;此外,说话人识别使用了WavLM-Base+模型,基于余弦相似度进行聚类,处理了多说话人场景下的区分与归类问题,最终识别出speaker_03集群,相似度均值达0.898。
常用场景
经典使用场景
白俄罗斯语自动语音识别(ASR)模型的训练与评估是该数据集最经典的使用场景。该数据集包含来自白俄罗斯语有声读物《Пах вербены》的音频片段及其对齐转录文本,专门为语音识别任务而设计。研究人员可利用这些经过精确对齐的语音-文本对,训练端到端或混合型ASR系统,尤其适用于低资源语言场景。数据集收录了531条记录,总时长约1小时22分钟,每个片段约15秒,确保了训练样本的多样性与实用性。由于其源自同一朗读者(speaker_03),数据集也适合进行说话人自适应或特定声学环境的模型微调。对齐置信度不低于0.95,保证了标注质量,为构建高精度的白俄罗斯语语音识别模型奠定了坚实基础。
解决学术问题
该数据集旨在解决白俄罗斯语这一低资源语言在语音识别研究中面临的标注数据匮乏问题。白俄罗斯语在全球语言资源中处于弱势地位,缺乏大规模、高质量、对齐良好的语音-文本数据集,严重制约了相关学术探索。该数据集的发布,为研究人员提供了一个可靠的基准,用以验证和比较不同ASR架构在白俄罗斯语上的表现,包括声学模型、语言模型以及序列到序列模型的性能。此外,它促进了跨语言声学建模、多语言预训练模型迁移学习以及低资源语言数据增强方法的研究。通过提供对齐置信度指标,数据集也推动了弱监督和自监督学习方法在低资源语音识别领域的应用,具有重要的学术价值。
实际应用
在实际应用中,该数据集可被用于开发面向白俄罗斯语用户的智能语音助手、语音输入系统以及无障碍辅助技术。例如,可以基于该数据集训练白俄罗斯语语音识别模型,集成到移动设备或桌面应用中,支持用户通过语音进行搜索、文字输入或命令控制。另有声读物自动生成字幕、语言学习辅助工具中的发音评估、以及为听力障碍人士提供的语音转写服务,均是这一数据集的典型落地场景。由于数据集来源于文学作品的朗读录音,其声学环境和朗读风格相对规范,适合作为高质量白俄罗斯语语音交互产品的初始训练资源。随着模型在此类数据上的优化,最终可拓展至更广泛的真实世界语音应用。
数据集最近研究
最新研究方向
在当前低资源语言语音技术迅猛发展的浪潮中,白俄罗斯语作为东斯拉夫语支中数据稀缺的语言之一,其自动语音识别(ASR)研究正迎来关键突破。该数据集以威廉·福克纳的白俄罗斯语有声书《Пах вербены》为基础,通过高置信度(≥0.95)的自动对齐流水线——结合Gemini模型与双ASR系统——生成了366条标注音频片段,总时长达1小时22分钟。这一成果不仅为白俄罗斯语的语音识别模型训练提供了稀缺的、按语句切分的高质量对齐数据,更体现了利用生成式AI辅助低资源语言数据构建的前沿方法。数据集中对说话人(speaker_03)的细粒度聚类与声纹相似度评估(平均0.898),也凸显了在多说话人场景下进行说话人识别和语音分离研究的价值。此类工作正推动低资源语言从“数据荒漠”迈向“数据绿洲”,对促进语言多样性和信息无障碍具有深远意义。
以上内容由遇见数据集搜集并总结生成


