
Ti-Ma/wikipedia_2018
收藏官方服务:
资源简介:
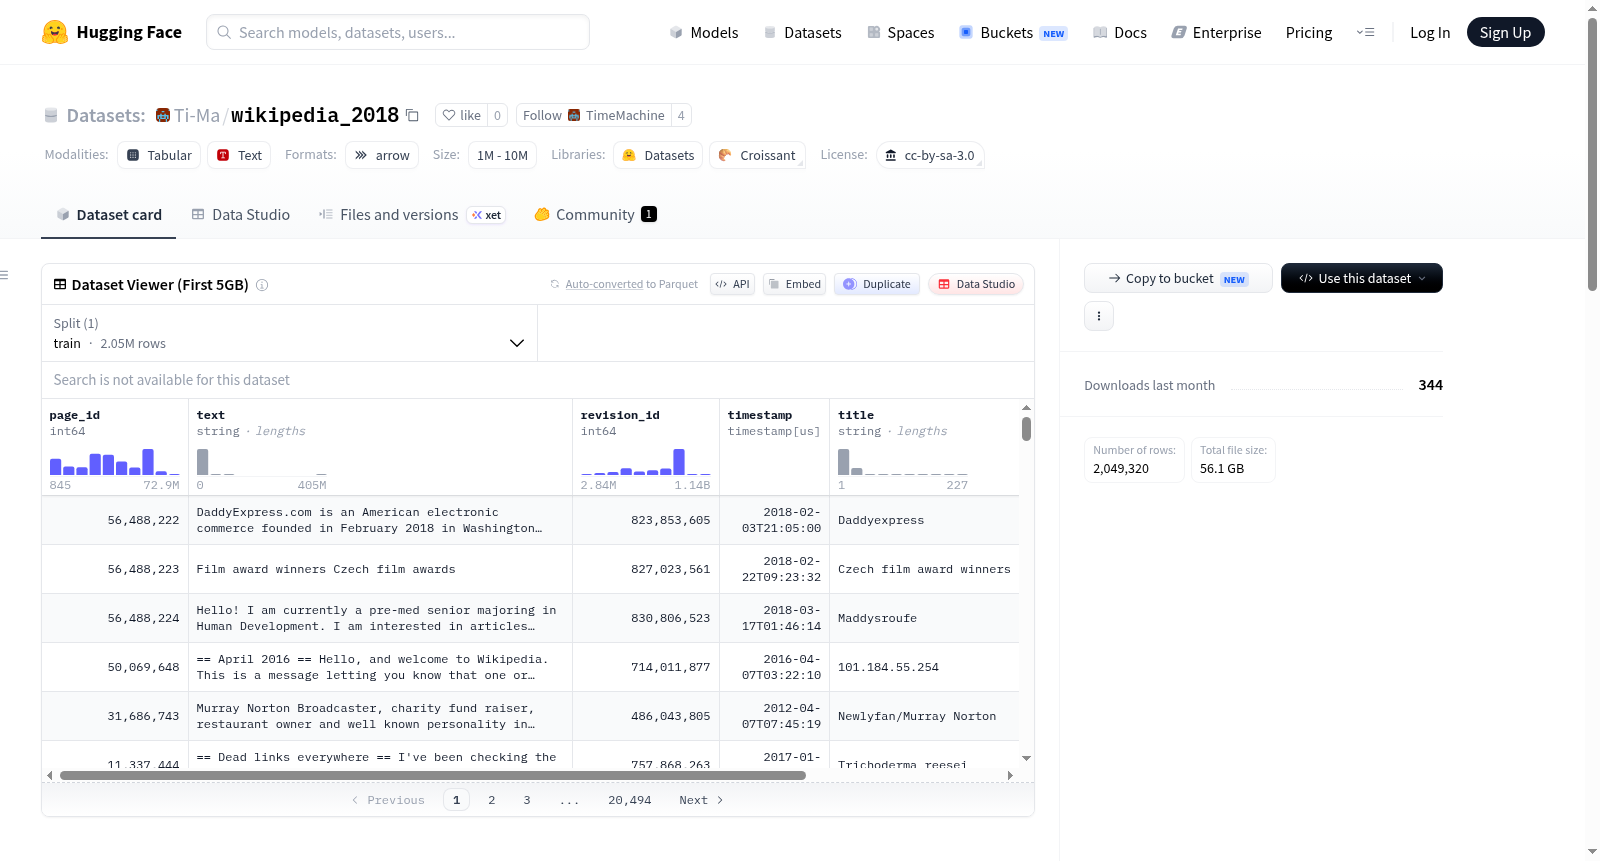
该数据集是基于截至2018年12月31日的Wikipedia数据构建的。通过选择每年12月31日的最新修订版本,确保数据集反映了每年年底Wikipedia上最新的信息。数据集经过清理,去除了文件链接、强调、注释、缩进、HTML、引用等不需要的特征和属性。数据集适用于历时研究、历史LLM预训练以及需要严格时间划分数据的任务。
该数据集是基于截至2018年12月31日的Wikipedia数据构建的。通过选择每年12月31日的最新修订版本,确保数据集反映了每年年底Wikipedia上最新的信息。数据集经过清理,去除了文件链接、强调、注释、缩进、HTML、引用等不需要的特征和属性。数据集适用于历时研究、历史LLM预训练以及需要严格时间划分数据的任务。
提供机构:
Ti-Ma原始信息汇总
数据集概述
数据集描述
本数据集是截至2018年12月31日的维基百科数据集。数据集包含了每年12月31日为止的最新版本文章。由于某些页面自目标日期以来未被编辑,因此一些修订版本可能追溯到几年前。这种方法确保了训练数据集反映了每年年底维基百科上可用的最新信息,提供了一个特定时间点的知识真实快照。
数据处理
数据集通过使用wiki-dump-reader工具进行清洗,去除了文件链接、强调、评论、缩进、HTML、参考等不必要特征和属性,最终输出干净的文本。
语言
- 语言(s): 英语
许可证
- 许可证: cc-by-sa-3.0
数据集结构
数据集以适合快速加载大型文件的格式保存,并与Huggingface数据集框架兼容。
使用场景
- 维基百科的历时研究
- 历史LLM预训练
- 任何需要严格数据时间分区的任务
偏差、风险和限制
数据集并非包含所有维基百科文章,部分文章可能对终端用户无用,因此可能需要对相关文章进行筛选以适应下游任务。
联系方式
- 联系邮箱: felix.drinkall@eng.ox.ac.uk
搜集汇总
数据集介绍
构建方式
该数据集基于维基媒体定期发布的维基百科转储文件构建,聚焦于2018年12月31日的知识快照。为确保时间节点的精确性,构建者首先为每篇文章确定截至该日期的最近修订版本,即使部分页面因长期未编辑而包含较早内容,这些版本仍被视为当时的最新状态,从而真实反映了特定时间点的知识全貌。随后,利用wiki-dump-reader工具对选定修订版本进行解析与清洗,移除文件链接、强调标记、注释、缩进、HTML标签及参考文献等非文本要素,最终生成纯净的文本语料。数据集以兼容Huggingface datasets框架的格式存储,便于高效加载与处理大规模文件。
特点
该数据集的核心特色在于其严格的时间划分机制,为每一篇文章捕获了2018年末的确切知识状态,支持历时性研究与历史语言模型预训练。通过保留所有维基百科文章,数据集提供了涵盖广泛主题的丰富语料,但同时也引入了噪声与冗余,部分内容可能对特定下游任务无直接助益。此外,数据集的构建过程确保了知识快照的真实性与时效性,使其成为研究时间敏感型自然语言处理任务的理想资源,尤其适用于需要严格时间分区的场景。
使用方法
该数据集可直接通过Huggingface datasets框架加载,适用于历时性维基百科分析、历史大语言模型预训练以及任何需要严格时间分区的任务。用户可根据下游需求对文章进行筛选过滤,例如剔除不相关或低质量的条目,以提升模型训练效率。数据集以标准格式存储,支持快速访问与批量处理,便于集成到现有的NLP工作流中。使用时需注意其cc-by-sa-3.0许可协议,确保合规引用与共享。
背景与挑战
背景概述
维基百科作为全球最大的开放协作知识库,其动态演化特性为自然语言处理领域提供了丰富的研究素材。由牛津大学Felix Drinkall等人于2023年创建的Ti-Ma/wikipedia_2018数据集,旨在捕捉维基百科在特定时间节点的知识快照。该数据集选取2018年12月31日作为截止日期,通过提取各页面在该时间点的最新修订版本,构建了一份严格按时间分割的语料库。这一设计不仅服务于历时性语言研究,还为历史语言模型的预训练提供了关键数据支撑,解决了传统语料库因时间混叠而导致的时间偏差问题。数据集采用cc-by-sa-3.0许可协议,已发表于NAACL 2024,对推动时间敏感型自然语言处理任务的发展具有重要影响。
当前挑战
该数据集面临的核心挑战在于如何处理维基百科内容的动态性与时间切片之间的固有矛盾。一方面,部分页面自2018年之前便未再编辑,其内容虽符合截止日期要求,却可能包含过时信息,这要求下游任务在使用时需谨慎评估知识的时效性。另一方面,数据构建过程中需从海量修订历史中准确定位每个页面的最终版本,并借助wiki-dump-reader工具去除文件链接、注释、HTML标签等噪声,这一清洗流程虽保证了文本纯净度,却可能丢失部分上下文结构。此外,数据集涵盖所有维基百科条目,其中不乏低质量或无关内容,用户需根据具体任务进行针对性过滤,增加了使用的复杂性。
常用场景
经典使用场景
Ti-Ma/wikipedia_2018 数据集作为维基百科在2018年12月31日的精确快照,其核心应用场景在于支持对知识进行严格时间划分的历时性研究。研究者可借助该数据集追溯特定时间点下知识的演化轨迹,例如分析概念、实体或社会事件在维基百科中的表述如何随时间变迁。该数据集特别适用于需要时间戳约束的自然语言处理任务,如训练具有时间感知能力的语言模型,或在信息检索中评估模型对历史知识状态的拟合程度。通过提供统一的、经过清洗的文本语料,它确保了研究结论的可复现性,避免了因数据版本混杂带来的混淆效应。
实际应用
在实际应用中,该数据集可作为构建时间敏感型人工智能系统的基石。例如,在智能问答与对话系统中,利用该数据训练的模型能更准确地根据查询时间提供符合历史事实的回答,避免将未来知识误用于过去场景。此外,它可用于历史档案的数字化整理、学术文献的时序检索,以及新闻事件的时间线生成。在金融分析或法律合规领域,基于该数据集开发的工具能够追溯特定时间点的公开信息,辅助决策者评估历史背景下的市场动态或法律条文演变,从而提升信息处理的准确性与合规性。
衍生相关工作
该数据集衍生了一系列关于时间感知预训练与历时性文本分析的重要工作。其中,Time Machine GPT 模型直接利用此数据验证了时间分区预训练对语言模型性能的影响,开创性地将时间戳作为关键特征嵌入模型训练流程。后续研究进一步探索了基于时间快照的对比学习范式,用以捕捉语义在时间轴上的连续变化。此外,该数据集还被用于构建时间对齐的知识图谱嵌入方法,以及评估大语言模型对历史事实的掌握程度,催生了如 TempLAMA 等时间敏感知识探测基准,推动了自然语言处理领域对时间动态性的系统性关注。
以上内容由遇见数据集搜集并总结生成


