遇见数据集

stevengubkin/mathoverflow_text_arxiv_labels

收藏
Hugging Face2023-08-27 更新2024-03-04 收录
官方服务:

资源简介:

该数据集是从Stack Exchange下载的,经过一系列处理步骤。首先,使用TexSoup工具将所有数学环境中的文本替换为[UNK]。其次,将标题和正文内容进行了拼接。对于原始数据中的“答案”帖子,根据它们所回答的问题的标签进行了标记。数据集仅保留了使用至少一个32个arxiv标签的帖子,并且这些帖子必须获得超过5个赞。最后,使用MultilabelStratifiedShuffleSplit方法对数据集进行了训练/验证/测试的划分,以确保多标签共现统计的准确性。

本数据集采用知识共享署名-相同方式共享4.0(CC BY-SA 4.0)许可协议。 数据集从https://archive.org/download/stackexchange 下载获取。 处理过程中,我们使用TexSoup(https://pypi.org/project/TexSoup/)将所有数学环境内的文本替换为[UNK]。例如原文本为:"The integral $int_a^b f(x) extrm{ d}x$ is easy to evaluate if...",会被替换为:"The integral [UNK] is easy to evaluate if..."。 需注意,仍有部分ASCII格式的数学表达式被保留,例如用户常书写的`f: X --> Y`这类形式未作替换。 我们将帖子的标题与正文进行拼接整合。 部分帖子为回答帖而非提问帖,在原始数据中这类回答帖未被标注标签;我们为每一则回答帖添加了其所回应的提问帖所对应的分类标签。 我们仅保留了至少包含以下32个arxiv分类标签之一的帖子:'ac.commutative-algebra'、'ag.algebraic-geometry'、……、'st.statistics'。 同时仅保留了获赞数超过5的帖子。 训练集、验证集与测试集的划分采用了MultilabelStratifiedShuffleSplit(https://github.com/trent-b/iterative-stratification)方法,该方法相比纯随机划分能够更好地保留多标签共现统计特性。

提供机构:
stevengubkin
原始信息汇总

数据集处理

  • 文本替换:使用TexSoup工具将数学环境中的所有文本替换为[UNK]。例如,原文本“The integral $int_a^b f(x) extrm{ d}x$ is easy to evaluate if...”被替换为“The integral [UNK] is easy to evaluate if...”。
  • 保留内容:保留了一些“ascii math”,例如人们有时会写成“f: X --> Y”的形式。
  • 标题与正文合并:将标题和正文内容进行合并。
  • 标签处理:对于“answer”类型的帖子,使用相应问题的标签进行标记。

数据筛选

  • 标签筛选:仅保留使用至少一个32个arxiv标签(如ac.commutative-algebra, ag.algebraic-geometry, ..., st.statistics)的帖子。
  • 投票筛选:仅保留获得超过5个赞的帖子。

数据分割

搜集汇总
数据集介绍
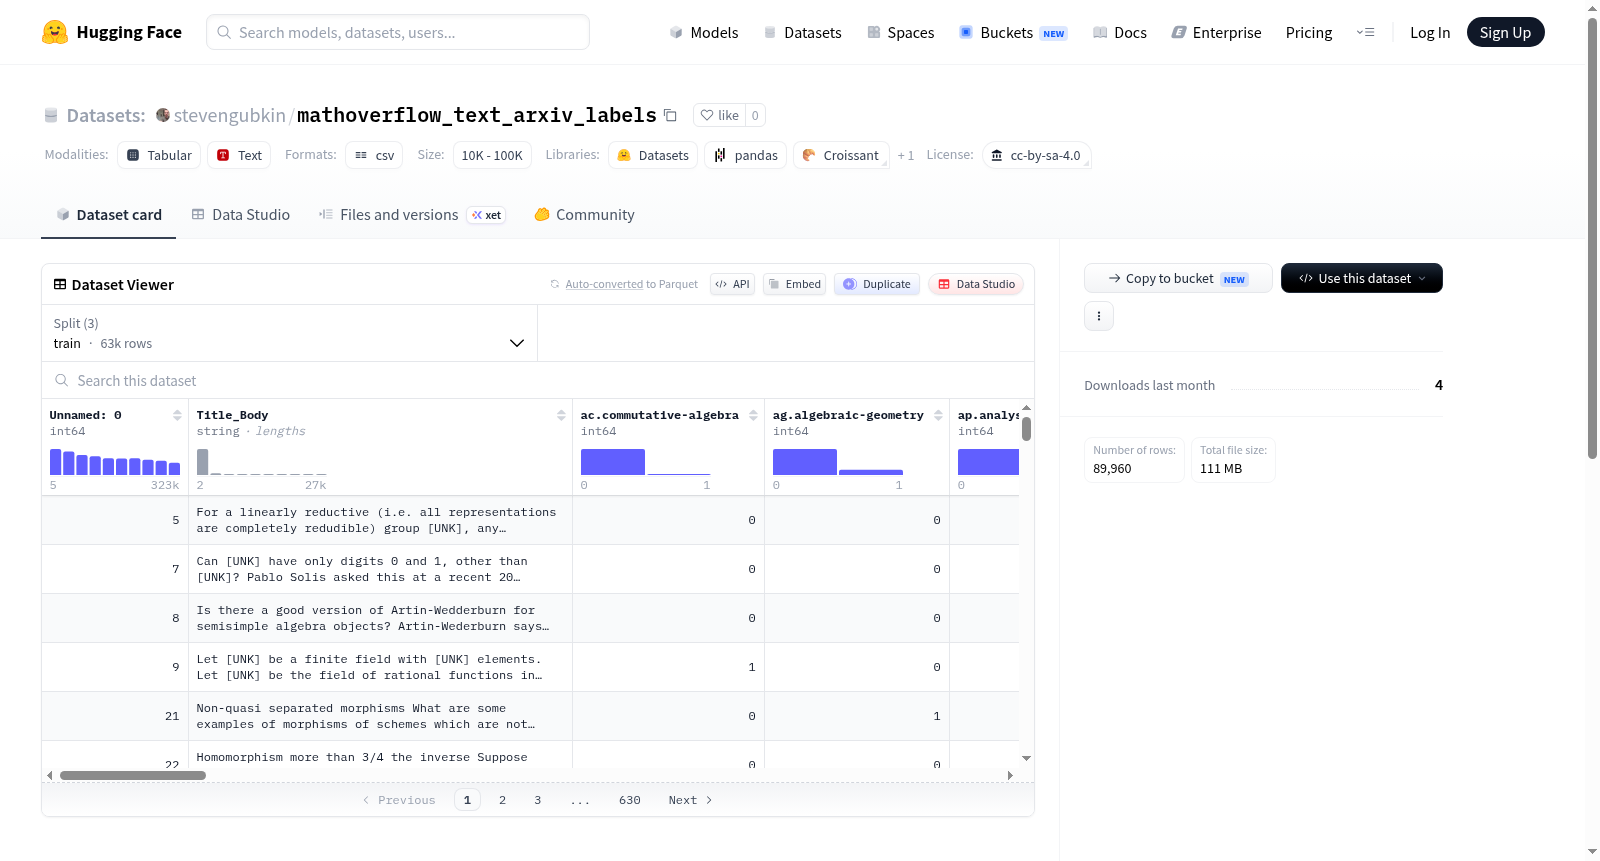
stevengubkin/mathoverflow_text_arxiv_labels 数据集图片
构建方式
该数据集源自Stack Exchange社区的数据归档,经特定流程构建而成。首先,利用TexSoup工具将数学环境中的所有文本替换为[UNK]标记,以消除数学公式对文本分类的干扰。随后,将帖子的标题与正文内容进行拼接,形成完整的文本单元。针对原始数据中未标注标签的“回答”帖子,根据其所属问题的标签进行补充标注。仅保留至少包含32个arXiv标签(如ac.commutative-algebra、ag.algebraic-geometry等)之一的帖子,并筛选出得票数超过5的优质内容。最终,采用MultilabelStratifiedShuffleSplit方法进行训练集、验证集和测试集的划分,以更好地维护多标签共现的统计特性。
使用方法
该数据集适用于多标签文本分类任务,尤其面向数学领域的学术标签预测。使用时,可直接加载经过预处理的文本字段(已拼接标题与正文),并利用对应的多标签向量进行模型训练。建议采用基于Transformer的预训练语言模型(如BERT或RoBERTa)作为编码器,结合多标签分类头进行微调。评估时可采用宏平均F1分数或子集准确率等指标。由于数据已预先划分好训练、验证和测试集,用户可直接按此划分进行实验,无需额外处理标签不平衡问题。
背景与挑战
背景概述
在科学文献与学术交流的数字化浪潮中,数学领域的知识共享平台如MathOverflow,已成为研究者探讨前沿问题、交换洞见的重要场域。该数据集由研究者Steven Gubkin于近期创建,其核心研究问题在于如何将非结构化的数学论坛文本转化为可用于多标签分类任务的标准化语料库。通过利用arXiv的32个学科标签(如交换代数、代数几何、统计学等)对帖子进行标注,并仅保留高赞内容以确保质量,该数据集为数学文本的自动分类与知识组织提供了宝贵的基准资源。其影响力体现在为自然语言处理与数学信息检索的交叉领域开辟了新路径,推动了学术问答系统与文献推荐算法的进步。
当前挑战
该数据集面临的主要挑战首先源于数学文本的固有复杂性:数学表达式以LaTeX或ASCII形式(如f: X → Y)嵌入自然语言中,导致语义边界模糊,而简单替换数学环境为[UNK]标记虽简化了处理,却可能丢失关键的结构化信息,影响模型对数学逻辑的理解。其次,多标签分类的构建过程本身充满困难:原始数据中回答帖缺乏标签,需通过关联问题帖继承标签,但跨帖映射可能引入噪声;同时,采用MultilabelStratifiedShuffleSplit进行分层分割虽能维护标签共现统计,却要求数据集具备足够的样本密度以支持稳定的分割,而高赞筛选进一步压缩了数据规模,加剧了类不平衡与稀疏性问题。
常用场景
经典使用场景
在计算语言学与信息检索的交叉领域中,数学文本的语义解析始终是一个极具挑战性的课题。MathOverflow作为数学研究者交流前沿问题的核心平台,其内容天然融合了自然语言与形式化数学符号。本数据集通过将数学环境中的文本统一替换为特殊标记[UNK],构建了一个专注于非数学语境下语义理解的语料库。经典使用场景聚焦于多标签文本分类任务,即根据数学问答帖子的标题与正文内容,预测其所属的arXiv学科标签(如代数几何、概率论等)。研究者可基于此数据集训练模型,探索如何在不依赖具体数学表达式的情况下,仅凭上下文语言推断数学问题的领域归属,这为理解数学文本的语用特征提供了独特的实验基准。
解决学术问题
该数据集的核心学术贡献在于解决了数学领域文本的多标签分类问题中,数据稀疏性与标签共现模式难以建模的困境。传统方法往往受限于数学符号的异构性,导致特征维度爆炸或语义鸿沟。通过屏蔽数学表达式,本数据集迫使模型转向对描述性语言、逻辑连接词及学科术语的深层语义挖掘。它验证了在缺乏形式化符号时,自然语言本身是否携带足够的领域判别信息。这一思路启发了对数学文本“语域”特征的研究,即不同分支学科在解释性文本中呈现的独特词汇模式与句法结构。同时,数据集的构建过程严格遵循多标签分层抽样策略,确保了训练集、验证集与测试集中标签共现统计的一致性,为评估多标签分类算法的泛化性能提供了更可靠的实验平台。
实际应用
在实际应用中,该数据集直接服务于学术搜索引擎的学科自动标注系统。例如,当研究者检索一个跨学科的数学问题时,系统可依据帖子的语言特征而非完整公式,快速将其归类至正确的arXiv子领域,从而提升检索精度。此外,该数据集可辅助构建数学问答社区的内容推荐引擎,通过分析问题文本的学科倾向,为不同领域的研究者推荐相关讨论。在教育技术领域,它可用于开发智能辅导系统,识别学生提问中隐含的数学分支(如分析学或拓扑学),从而定向推送教学资源。数据集中对回答帖子的标签继承策略,更使得模型能够理解问答对之间的语义关联,这对构建对话式知识库具有重要参考价值。
数据集最近研究
最新研究方向
数学领域文本数据集的构建与多标签分类研究正成为自然语言处理与科学知识挖掘的前沿交叉方向。该数据集基于MathOverflow社区的高质量问答内容,通过保留TeX公式中的数学环境标记为[UNK]以屏蔽具体符号,同时保留ASCII数学表述,从而聚焦于文本语义与数学推理的关联。研究热点集中于利用多标签分层抽样策略(如MultilabelStratifiedShuffleSplit)处理标签共现不平衡问题,结合arXiv的32个数学子领域标签进行细粒度分类。这一方向与近年来数学论文自动归档、跨学科知识图谱构建及学术搜索引擎优化等事件紧密相关,其意义在于为数学文本的语义理解、主题建模及智能检索提供标准化基准,推动数学领域从人工标注向自动化知识组织转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务