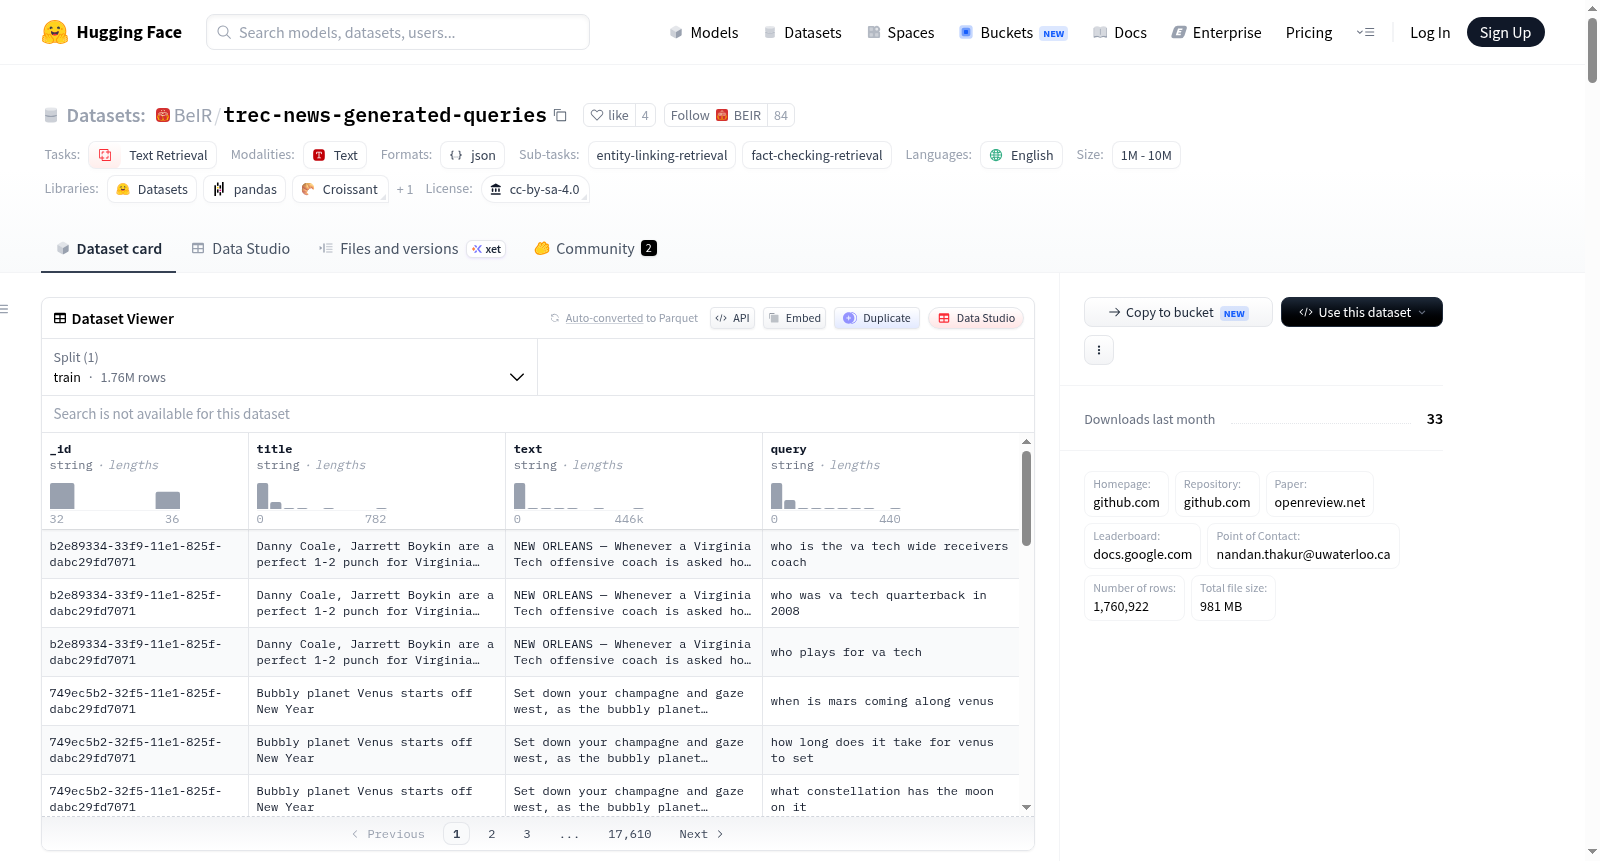
BeIR/trec-news-generated-queries
收藏资源简介:
BEIR Benchmark是一个异构的基准测试,由18个不同的数据集组成,代表了9种信息检索任务。这些任务包括事实核查、问答、生物医学信息检索、新闻检索、论点检索、重复问题检索、引用预测、推文检索和实体检索。所有数据集均为英文,并已预处理,可用于实验。数据集包含corpus、queries和qrels三个部分,分别用于存储文档、查询和查询与文档的相关性判断。数据集支持多种信息检索任务,并提供了一个排行榜来评估模型在这些任务上的表现。
BEIR Benchmark is a heterogeneous benchmark composed of 18 distinct datasets, representing 9 information retrieval tasks. These tasks include fact checking, question answering, biomedical information retrieval, news retrieval, argument retrieval, duplicate question retrieval, citation prediction, tweet retrieval, and entity retrieval. All datasets are in English and have been preprocessed for experimental use. The datasets include three core components: corpus, queries, and qrels, which are respectively used to store documents, queries, and relevance judgments between queries and documents. This benchmark supports multiple information retrieval tasks and provides a leaderboard for evaluating model performance on these tasks.
BEIR Benchmark 数据集概述
数据集描述
数据集总结
BEIR是一个异构基准,由18个不同的数据集组成,代表9个信息检索任务,包括事实检查、问答、生物医学信息检索、新闻检索等。所有这些数据集都经过预处理,可供实验使用。
支持的任务和排行榜
该数据集支持一个排行榜,评估模型在特定任务上的表现,如F1或EM,以及从维基百科检索支持信息的能力。当前表现最佳的模型可在此处找到。
语言
所有任务均为英语。
数据集结构
所有BEIR数据集必须包含语料库、查询和qrels(相关性判断文件),格式如下:
corpus文件:.jsonl格式,包含一系列字典,每个字典包含三个字段:_id(唯一文档标识符)、title(文档标题,可选)和text(文档段落或段落文本)。queries文件:.jsonl格式,包含一系列字典,每个字典包含两个字段:_id(唯一查询标识符)和text(查询文本)。qrels文件:.tsv格式,包含三个列:query-id、corpus-id和score,按此顺序排列。
数据实例
数据集示例包括:
corpus:文档标题和文本内容。queries:查询文本。qrels:查询与文档的相关性判断。
数据字段
corpus:包含_id(文档ID)、title(标题)和text(文本)。queries:包含_id(查询ID)和text(查询文本)。qrels:包含_id(查询ID)、_id(文档ID)和score(相关性评分)。
数据分割
数据集根据不同的任务和类型进行分割,如训练集、开发集和测试集,具体信息请参阅数据集详情。