遇见数据集

ipfs_bolivia_laws

收藏
Hugging Face2026-09-07 更新2026-09-08 收录
官方服务:

资源简介:

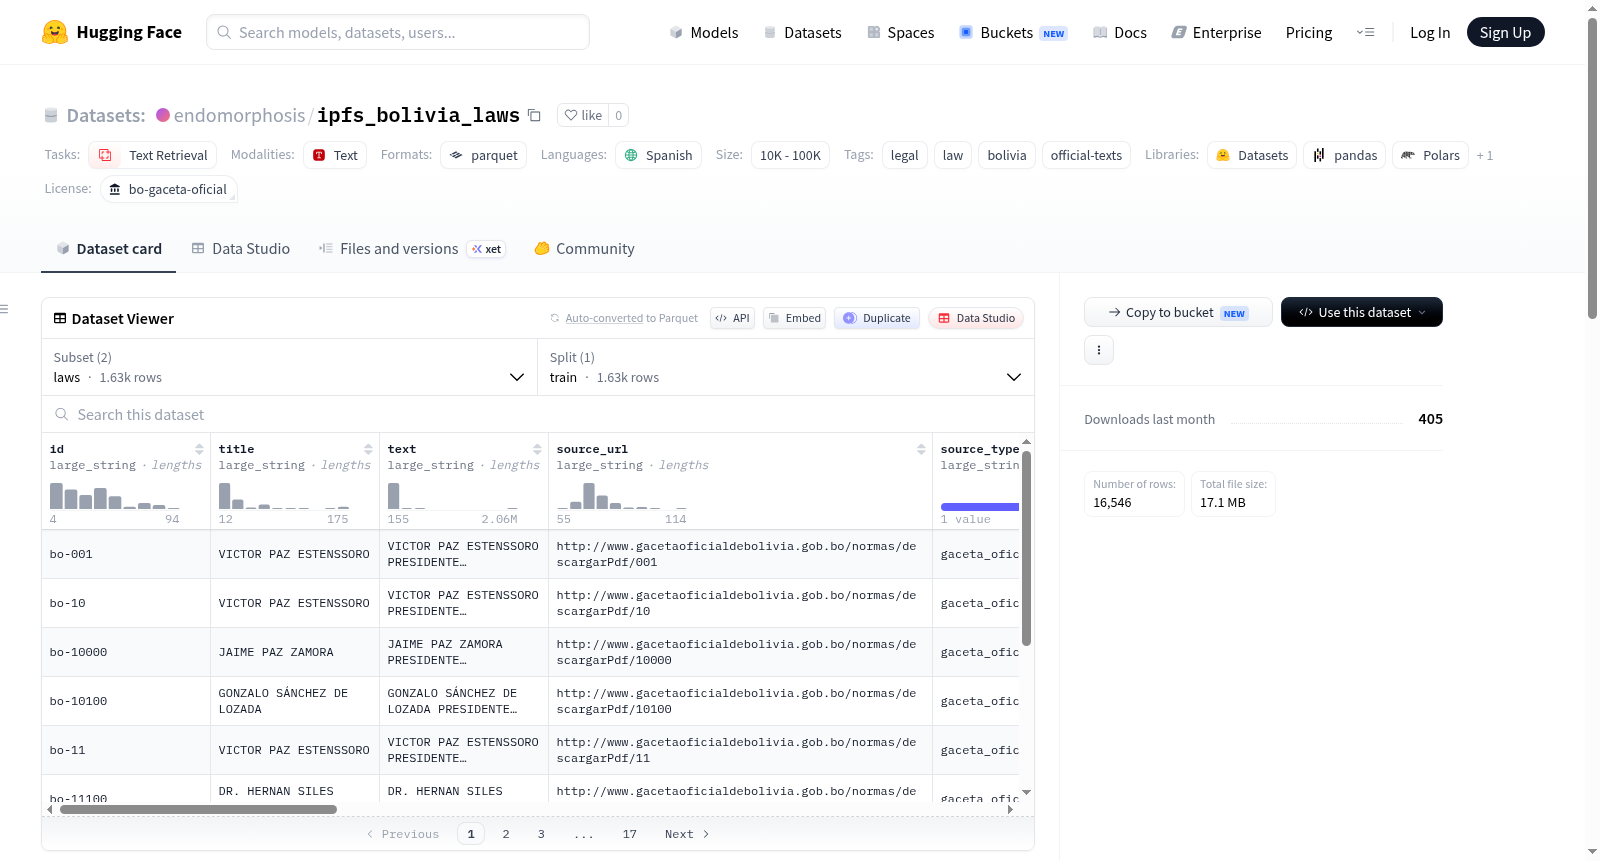
玻利维亚法律数据集(Laws of Bolivia)是一个收集自玻利维亚官方公报(Gaceta Oficial de Bolivia)的法律文本快照数据集。数据以 Parquet 格式存储,包含两个配置:laws 和 articles。laws 配置每行对应一部法律或文书,包含字段:ID、标题、全文、日期、状态、标识符、条款数量、来源URL;articles 配置每行对应一条条款,包含字段:法律ID、条款编号、标题、文本、来源URL。数据集规模为1332部法律和13242条条款,语言为西班牙语,适用于法律文本检索、分析等自然语言处理任务。注意:该数据集非官方整合,不构成法律建议,官方文本优先。

The Laws of Bolivia dataset is a snapshot of legal texts collected from the Official Gazette of Bolivia (Gaceta Oficial de Bolivia). The data is stored in Parquet format and includes two configurations: laws and articles. The laws configuration corresponds to each law or document, with fields: ID, title, full text, date, status, identifier, number of articles, source URL. The articles configuration corresponds to each article, with fields: law ID, article number, title, text, source URL. The dataset contains 1,332 laws and 13,242 articles, in Spanish, suitable for legal text retrieval, analysis, and other natural language processing tasks. Note: This dataset is not an official compilation, does not constitute legal advice, and official texts take precedence.

创建时间:
2026-09-05
原始信息汇总

数据集概述:玻利维亚法律(Laws of Bolivia)

该数据集是玻利维亚官方立法的研究快照,内容来源于玻利维亚官方公报(Gaceta Oficial de Bolivia),旨在为研究目的提供结构化文本数据。请注意,该数据集不构成官方合编版,也不提供法律建议,一切以官方公报或政府门户网站发布的内容为准。

基本信息

  • 数据集名称:玻利维亚法律(Laws of Bolivia)
  • 语言:西班牙语(es
  • 司法辖区:玻利维亚(Bolivia)
  • 许可证bo-gaceta-oficial(属于“其他”类别,非标准许可证)
  • 任务类型:文本检索(text-retrieval)
  • 标签:法律、立法、玻利维亚、官方文本

数据规模与覆盖

项目 数量/说明
快照日期 2026-09-07
覆盖范围 基于目录、不完整(catalog-backed incomplete)
法律/文书数量 1452 部
条款数量 13924 条
文件数量 约 1K–10K(1,000~10,000)
数据格式 Parquet 文件

数据集内容与结构

数据集包含两个配置(config),均以Parquet格式存储:

  1. laws (默认配置) — 文件路径:data/laws.parquet

    • 每一行对应一部法律/文书,字段包括:
      • 标识(id)
      • 标题
      • 全文文本
      • 日期
      • 状态
      • 标识符
      • 条款数量
      • 来源URL
  2. articles 配置 — 文件路径:data/articles.parquet

    • 每一行对应一个条款或章节,字段包括:
      • 所属法律编号(law_id
      • 条款编号
      • 标题
      • 文本内容
      • 来源URL

采集与构建信息

  • 数据来源:玻利维亚官方公报(Gaceta Oficial de Bolivia)
  • 采集器脚本
    • scrapers/collect_bo.py — 用于构建此快照的研究级采集器
    • scrapers/common.py — 共享采集辅助函数
    • scrapers/world_lib.py — 共享抓取逻辑(直接访问官方URL,失败时回退到Wayback Machine)
    • scrapers/archive_fallbacks.py — 用于Wayback Machine / Common Crawl CDX的辅助函数

许可与重用说明

  • 官方政府/公报文本的再利用需遵循原始门户网站的公共部门条款
  • 此数据集的打包、元数据及采集脚本仅供研究用途使用。
  • 该数据集不是官方合编版,也不是法律建议,官方来源具有优先效力
搜集汇总
数据集介绍
ipfs_bolivia_laws 数据集图片
构建方式
该数据集源自对玻利维亚官方公报(Gaceta Oficial de Bolivia)的立法文本进行的系统性采集与整理,构建过程依托于专门研发的爬虫脚本(collect_bo.py),并辅以共享工具集,确保数据获取具备可复制性与可追溯性。数据采集以官方目录为基准,覆盖1632项法律文书及14914个条款,分别存储于两个结构化的Parquet文件中:其一以文书为粒度,包含标题、全文、日期、效力状态及官方标识符等元数据;另一以条款为粒度,关联法律编号、条目序号与正文内容。为了规避网络波动或原文缺失风险,采集器引入了互联网档案馆(Wayback Machine)及Common Crawl的CDX索引作为降级方案,同时支持OCR文本截断恢复,从而提升语料完整性。最终产出以研究快照形式呈现,记录了采集日期与覆盖范围的不完全性,强调了来源的官方权威性。
特点
该数据集呈现出鲜明的法学语料特性,专为法律文本检索任务而设计。其首要特点在于双语标签与领域聚焦——语言标注为西班牙语,法律属性涵盖玻利维亚国别法、官方文本及公报来源。在粒度划分上,双配置(laws与articles)提供从法律文书整体到逐条条款的两个层级,便于多元检索粒度。涵盖时间跨度上,以元数据中的日期字段与效力状态(如现行、废止)实现纵向追踪。数据集规模介于1K至10K之间,实用且可控。更由采集快照揭示出目录支撑的不完整真实状态,并明确注明非官方整合版本,体现数据使用的界度伦理。此外,对原始来源及存档回退机制的整合凸显了数据韧性,为自然语言处理在立法领域的应用提供了可复现的基础。
使用方法
使用者可依据检索需求灵活装载双配置文件,通过Hugging Face Datasets库进行简洁的加载操作,如以load_dataset(path, 'laws')或'articles'指定粒度。对于法律文本比对或实证研究,可直接将其转化为DataFrame形式,利用描述性字段(如标题、日期、效力状态)实施过滤与筛选。在检索任务场景中,建议对全文与条款正文进行词嵌入或稀疏向量化后索引,结合法律领域特定的查询扩展提升召回率。鉴于文本以西班牙语呈现,预处理中应适配基于拉丁语族的词形还原与停用词表。由于语料非官方整合版,使用者在涉及法律裁决时需核对官方公报原始文本,尤其适用于先引导式实验或教学演示。依据公开部门条款,注意复用时的许可约束,并保留原始来源与采集版本的出处标注。
背景与挑战
背景概述
在全球法律信息数字化进程中,拉丁美洲国家法规的公开获取与结构化整理成为法律科技和自然语言处理交叉领域的重要议题。该数据集由研究团队于2026年9月从玻利维亚官方公报(Gaceta Oficial de Bolivia)系统采集,涵盖1632部法律文书及14914个条款,以西班牙语呈现,构建了首个大规模、元数据丰富的玻利维亚法律语料库。其核心研究问题聚焦于官方立法文本的自动化获取与标准化,填补了低资源语言法律数据集稀缺的空白,为法律信息检索、文本挖掘及跨法域比较研究提供了关键基础资源,对该区域法律人工智能的发展具有开拓性贡献。
当前挑战
该数据集构建面临多重挑战。首先,领域上,玻利维亚法律体系法规分散于官方公报,缺乏统一整合,文本冗长且结构复杂,为准确条款切分和元数据提取带来困难。其次,采集过程需绕过官方门户的动态网页限制,并应对数据不完整、链接失效等问题,利用Wayback回退及OCR技术弥补缺失,但可能导致文本噪声。此外,由于公报数据覆盖不完整,数据集仅能反映采样快照,而非权威整合,确保法律引用中的绝对时效性与准确性成为后续研究难点。这些挑战凸显了法律数据工程在低资源环境下的技术复杂度与学术价值。
常用场景
经典使用场景
玻利维亚法律数据集(ipfs_bolivia_laws)以其系统化的条文切分与元数据标注,成为法律文本检索与信息抽取研究的理想测试平台。该数据集收录了1,632项法律文书及14,914个条款,每项均包含标识符、颁布日期、当前状态及官方来源链接,为研究者提供了结构化的语料基础。其经典使用场景涵盖法条语义匹配、跨版本法律变迁追踪、以及基于自然语言查询的法律条文定位。借助西班牙语法律文本的独特术语体系,该数据集亦可评估多语言法律信息检索系统的鲁棒性,推动司法领域智能问答与辅助决策工具的发展。
衍生相关工作
围绕该数据集,研究者已衍生出多项富有成效的工作:法律文本的神经检索模型微调,利用条文级别标注优化西班牙语法律领域的稠密向量表示;基于时间戳的法律效力状态预测,结合元数据中的日期与状态字段,训练法律演变预测模型;以及法律知识图谱的自动构建,关联法律标题、条文编号与引用关系。这些工作不仅提升了法律信息处理的自动化水平,还催生了若干开源工具,如法规比对工具与OCR文本恢复脚本,为拉丁美洲其他国家法律数据集的构建提供了可复用的方法论与技术框架。
数据集最近研究
最新研究方向
该数据集聚焦于玻利维亚官方公报的法律文本挖掘与检索研究,涵盖了1632部法律及14914条条款,为拉美法律自然语言处理提供了宝贵的语料资源。当前研究前沿在于利用大规模法律文本构建领域特定的语言模型与信息检索系统,以应对法律条文的复杂性和时效性。该数据集的出现推动了法律科技与司法智能化的进展,尤其在法律条文比对、历史法律演变分析及跨法域检索等方向具有重要应用价值。其快照式的采集方式虽非官方整合版本,但为法律文本的长期保存与可获取性提供了研究支持,并促进了法律数据开放与透明化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务