brain-lm-alignment-ds001894
收藏资源简介:
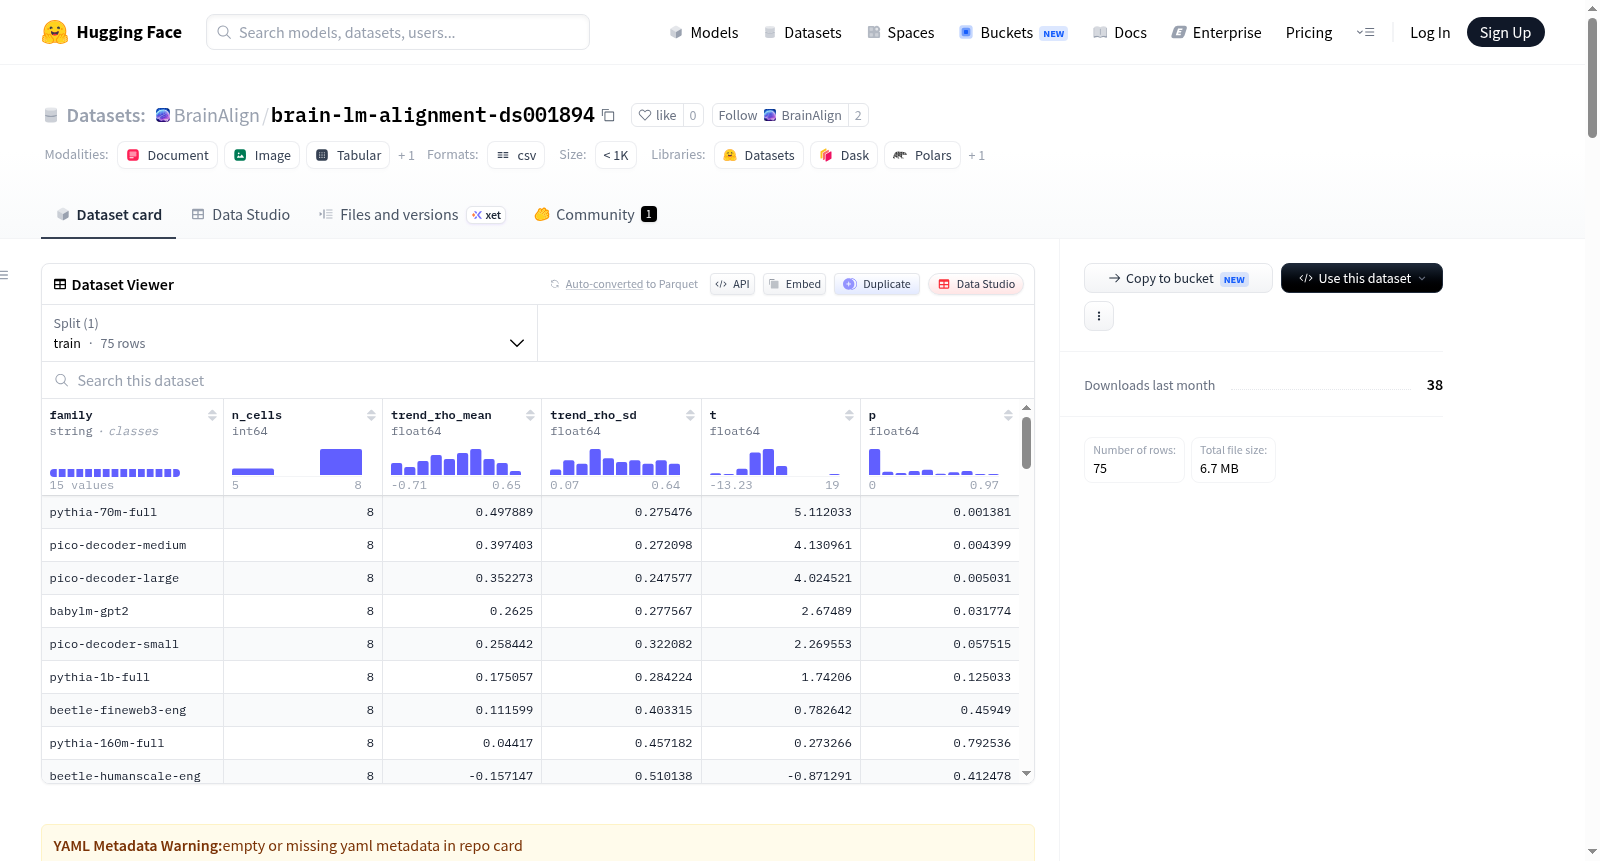
该数据集基于Lytle等人2019年的研究,旨在分析儿童在单词级语音处理过程中的脑-语言模型对齐。研究包含10岁和12岁左右两次扫描的纵向数据。数据集的核心是使用表征相似性分析(RSA),将脑表征差异矩阵(RDM)与语言模型隐藏状态导出的RDM进行对比。然而,重要警告:控制测试(GATE)结果显示所有16个刺激驱动测试均未达到显著性(Holm校正后),因此数据集中的对齐数值无法作为语言模型与大脑对齐的证据,发布仅用于完整性及后续方法改进。数据包含12个任务×会话单元(任务:Phon和Orth;会话:ses-7, ses-9, ses-11, ses-11+),每个单元有96个刺激,并计算了噪声上限。模型网格涵盖15个家族(如Pythia系列、pico-decoder、beetle、babylm-gpt2等),共2096行对齐记录。每个家族包含多个检查点,对齐值以原始RSA和相关分数形式提供。数据集还提供了控制测试、RDM维度分析、噪声上限等文件。适用任务包括脑-语言模型对齐研究、表征相似性分析、纵向发展神经科学。
This dataset is based on the 2019 study by Lytle et al., aiming to analyze brain-language model alignment in children during word-level speech processing. The study includes longitudinal data with two scans around ages 10 and 12. The core of the dataset uses representational similarity analysis (RSA) to compare brain representational dissimilarity matrices (RDMs) with those derived from language model hidden states. However, important warning: control tests (GATE) showed that all 16 stimulus-driven tests were not significant (Holm-corrected), so the alignment values in the dataset cannot be considered evidence of language model alignment with the brain. The dataset is released only for completeness and future methodological improvements. The data includes 12 task × session units (tasks: Phon and Orth; sessions: ses-7, ses-9, ses-11, ses-11+), each with 96 stimuli, and noise ceilings are computed. The model grid covers 15 families (e.g., Pythia series, pico-decoder, beetle, babylm-gpt2, etc.), with a total of 2096 alignment records. Each family includes multiple checkpoints, and alignment values are provided as raw RSA and correlation scores. The dataset also provides control tests, RDM dimension analysis, noise ceiling files, etc. Applicable tasks include brain-language model alignment research, representational similarity analysis, longitudinal developmental neuroscience.
数据集概述:Brain–language-model alignment: ds001894
基本信息
- 数据集名称: Brain–language-model alignment: ds001894 (whole-brain)
- 来源研究: Lytle et al. 2019 — 儿童词汇级语音处理的纵向研究,对同一批儿童在约10岁和12岁时进行了两次扫描
- 论文: 发表于 Nature Scientific Data(https://www.nature.com/articles/s41597-019-0338-5)
- 原始数据: OpenNeuro 数据集 ds001894 版本 1.4.2
- 生成日期: 2026-09-07
- 处理管线: GitHub 仓库 suchirsalhan/cdl-representations-brains-babylms
重要警告:质量控制失败
数据质量门控(GATE)状态:FAILED
- 20个刺激物相关测试中,0个达到统计显著性(经 Holm 校正后)
- 包括声学模型(针对儿童实际听到的音频)以及研究自身的实验对比均未通过
- RDM 有效秩为 96个刺激物中的67个,说明表征差异矩阵携带刺激结构,非近退化矩阵
- 因此,该数据集的对齐数值不能作为语言模型与发育中大脑对齐的证据,仅供完整性发布或供改进估计方法的研究者参考
数据构建内容
- 共构建 37个任务×会话单元,每个单元基于该单元受试者共享的刺激物构建表征差异矩阵(RDM)
- 体素模式在运行内进行z-score标准化后聚合,以避免测量扫描漂移而非语言信号
- 包含受试者间噪声上限估计
任务与会话结构
- 任务类型: Orth(正字法)和 Phon(语音学)
- 会话: ses-7, ses-9, ses-11, ses-11+(部分单元缺失数据,如 ses-7 无噪声上限数据)
- 刺激物数量: 每单元96个
- 噪声上限范围: 下限 0.117–0.348,上限 0.481–0.614,受试者数 3–11
模型评估结果
总体概况
- 模型族数量:15个,共 6550 行对齐数据
- 平均噪声上限:0.192
- 最佳对齐值:0.0534(占噪声上限的 40.4%)
- 全部15个模型族均与零等效(TOST ±0.05 检验)
- Pythia 规模趋势:ρ = +0.282,p = 0.17(不显著)
各模型族表现
| 模型族 | 检查点数量 | RSA均值 | RSA标准差 | 等效性检验p值 |
|---|---|---|---|---|
| pythia-160m-full | 21 | 0.0120 | 0.0057 | 0.0001 |
| pythia-1b-full | 21 | 0.0116 | 0.0030 | 0 |
| pico-decoder-tiny | 21 | 0.0105 | 0.0032 | 0 |
| pythia-1.4b-full | 21 | 0.0068 | 0.0023 | 0 |
| pico-decoder-large | 21 | 0.0017 | 0.0072 | 0.0001 |
| beetle-humanscale-eng | 18 | 0.0007 | 0.0053 | 0 |
| pythia-70m-full | 21 | 0.0006 | 0.0034 | 0 |
| pico-decoder-small | 21 | 0.0004 | 0.0052 | 0 |
| pico-decoder-medium | 21 | 0.0004 | 0.0043 | 0 |
| beetle-fineweb3-eng | 19 | 0.0002 | 0.0015 | 0 |
| pythia-410m-full | 21 | -0.0019 | 0.0048 | 0 |
| babylm-gpt2 | 9 | -0.0069 | 0.0098 | 0.0003 |
| babylm-gpt2-5 | 9 | -0.0201 | 0.0038 | 0 |
| babylm-gpt2-3 | 9 | -0.0212 | 0.0025 | 0 |
| babylm-gpt2-7 | 9 | -0.0215 | 0.0030 | 0 |
数据集特殊说明
- 这是唯一的纵向数据集:同一批儿童在两个时间点(ses-T1, ses-T2)被扫描,是语言模型检查点轨迹最接近的真实类比
- 每个受试者的扫描年龄数据可用
- 试验类型交叉设计正字法与语音学相似性(O+P+/O+P-/O-P+/O-P-),使 Phon 和 Orth 对比在设计上不相关
- ses-T2 仅包含 VV 任务
数据文件结构
| 文件路径 | 内容 |
|---|---|
alignment_by_checkpoint.csv |
每个模型×检查点×单元的对齐结果(含噪声上限) |
alignment_by_family.csv |
每个模型族的结果(含等效性检验) |
alignment_by_cell.csv |
每个任务×会话的结果 |
ceilings_ds001894.csv |
每单元的噪声上限 |
control/ |
阳性对照与RDM维度分析(质量门控) |
scale_ladder.csv |
Pythia 70M→1.4B 规模测试 |
fig_*.pdf, fig_*.png |
图表文件 |
方法说明
- 采用**表征相似性分析(RSA)**方法
- 每个单元构建基于刺激的大脑 RDM(GLM beta模式的相关系数距离,运行内z-score,跨受试者聚合)
- 通过 Spearman 相关与模型 RDM 比较(模型 RDM 来自各检查点的隐藏状态)
- 对齐结果以原始值和噪声上限百分比两种形式报告
- 使用 PARC 套件(18个仅随机种子不同的模型)构建零假设分布
- 刺激集排除了零试验和注视试验;配对设计中刺激身份为配对本身而非单个词