遇见数据集

ovos-stt-bench-mls-es-ES

收藏
Hugging Face2026-09-08 更新2026-09-09 收录
官方服务:

资源简介:

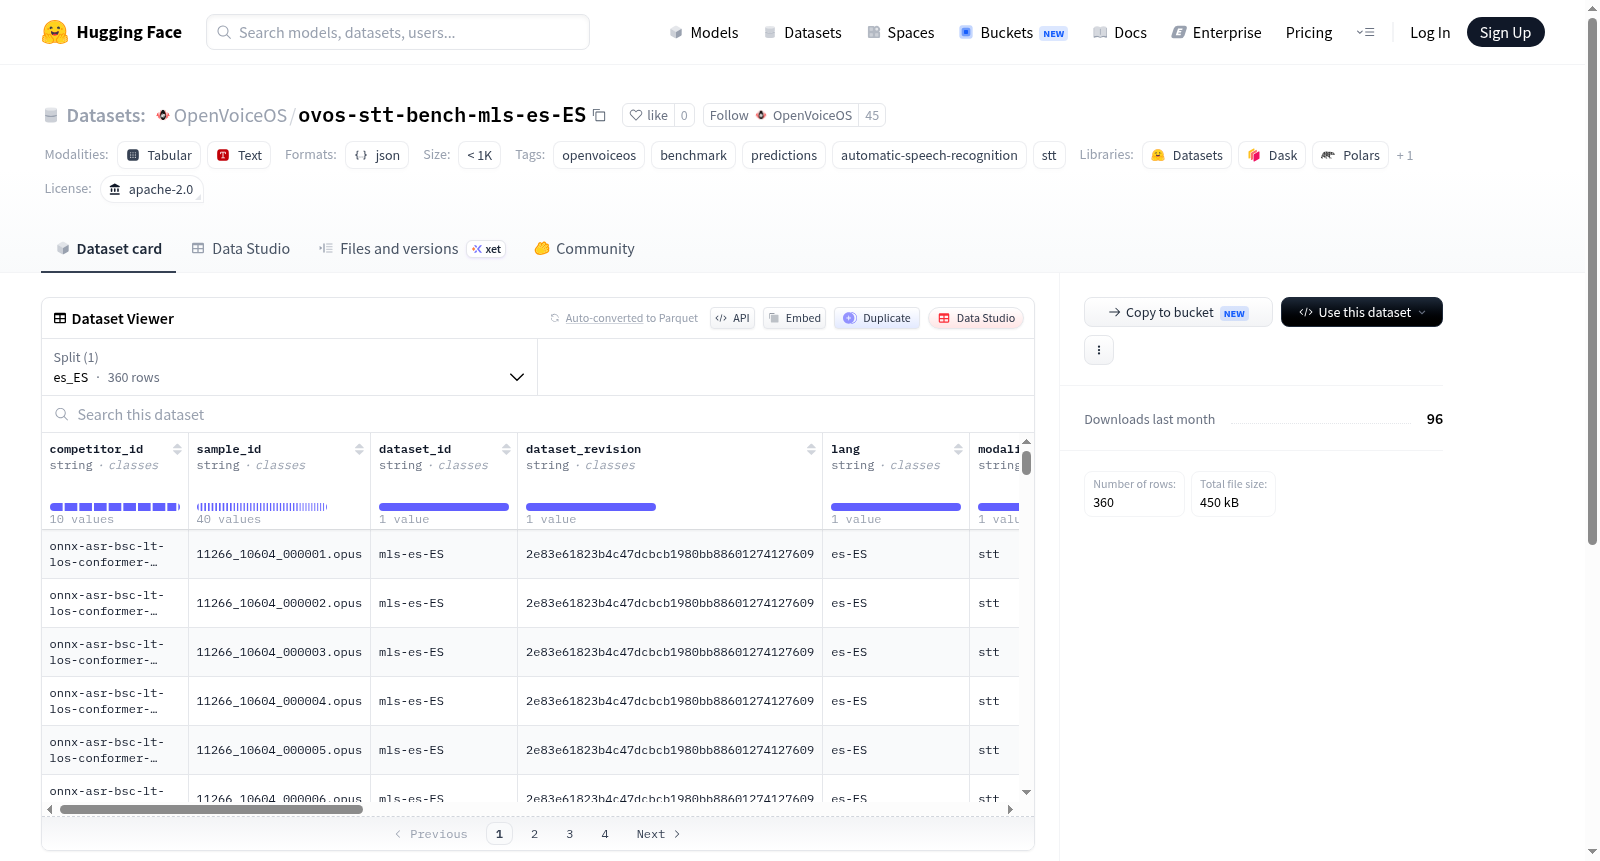
该数据集是 OVOS Plugin Arena 中自动语音识别(STT)参赛系统的逐片段转录预测结果,基于 Multilingual LibriSpeech 西班牙语子集(mls-es-ES)。每个语言对应一个数据集分割,每个参赛系统对应一个 JSONL 文件,存放于 predictions/<lang>/<competitor_id>.jsonl 路径下。每行记录遵循 Arena 协议 §3.2,包含固定的数据集版本(dataset_revision)、插件版本(plugin_version)和延迟(latency_ms)等信息。该数据集由 Arena 仓库中的可复现基准测试脚本生成,并用于通过 Arena 的 assemble 工作流构建基准排行榜、盲战池和基于基准的 ELO 等级。数据集由 NGI0 Commons Fund 和 NLnet 资助,基于 Apache-2.0 许可证发布。

This dataset contains per-segment transcription predictions from automatic speech recognition (STT) systems participating in the OVOS Plugin Arena, based on the Multilingual LibriSpeech Spanish subset (mls-es-ES). Each language corresponds to a dataset split, and each participant system corresponds to a JSONL file stored under predictions/<lang>/<competitor_id>.jsonl. Each record follows the Arena protocol §3.2, including fixed information such as dataset_revision, plugin_version, and latency_ms. The dataset is generated by reproducible benchmark scripts in the Arena repository and used by the Arena assemble workflow to build benchmark leaderboards, blind battle pools, and benchmark-based ELO ratings. It is funded by the NGI0 Commons Fund and NLnet, and released under the Apache-2.0 license.

创建时间:
2026-09-02
原始信息汇总

OVOS STT基准数据集 — 西班牙语(mls-es-ES)

数据集概述

本数据集包含自动语音识别(ASR)系统facebook/multilingual_librispeech数据集上的逐片段预测转录结果,用于基准测试与性能评估。

核心特性

属性 说明
许可证 Apache 2.0
语言 西班牙语(es-ES)
数据格式 JSONL(每行一条预测记录)
数据集划分 单一划分(es_ES)
文件路径 predictions/es-ES/*.jsonl

数据组织结构

  • 按模态划分:每个模态对应独立仓库
  • 按语言划分:每种语言对应一个数据集划分
  • 按竞争系统划分:每个ASR系统(“fighter”)对应一个JSONL文件,位于predictions/<lang>/<competitor_id>.jsonl

数据字段内容

每行记录遵循OVOS Plugin Arena协议第3.2节约定,包含:

  • 固定的dataset_revision(数据集修订版本)
  • plugin_version(插件版本)
  • latency_ms(延迟毫秒数)

数据来源与生产流程

  • 数据由OVOS Plugin Arena仓库中的可复现基准测试脚本生成
  • 参与系统为已注册的STT插件竞争者
  • Arena的assemble工作流将这些预测数据转化为:
    • 基准排行榜
    • 盲测对战池
    • 基于基准的ELO等级分排名

数据的用途

本数据集主要用于跨STT系统在西班牙语语音识别任务上的性能对比与排名评估

搜集汇总
数据集介绍
ovos-stt-bench-mls-es-ES 数据集图片
构建方式
本数据集源于OpenVoiceOS(OVOS)插件竞技场对自动语音识别模型的系统评测,聚焦于西班牙语(es-ES)语料的逐片段转写预测。其构建依托于MLS(多语言LibriSpeech)基准语料库,通过竞技场中注册的各类STT插件对每一音频片段进行推断,并将结果整理为结构化JSONL文件。每一行记录严格遵循竞技场协议所规定的字段,包括数据集修订版本、插件版本及处理延迟等元数据,确保评测过程的可复现性与一致性。这一规范的构建流程,由竞技场仓库中的基准脚本驱动,为后续的模型间对比与性能追踪奠定了坚实的数据基础。
特点
该数据集的核心特色在于其精细化的设计与多维度的评测信息。按语言划分的独立split与按竞争模型(fighter)组织的文件结构,使用户能够便捷地针对特定模型进行深入剖析。每条预测记录均绑定了固定的数据集版本及插件的精确版本,从而保障了不同批次评测之间的可比性。尤为重要的是,数据中包含了推理延迟信息,这不仅衡量了模型的识别精度,也兼顾了其在实际应用中的时效性。这种组合为离线评估与在线服务部署提供了双重参考,远超单一准确率指标的评估效果。
使用方法
本数据集的使用方式灵活多样,主要面向语音技术研发与评估场景。研究者可直接使用其复现竞技场中的基准测试结果,检验自身系统与顶尖水平的差距。其结构化格式与竞技场流水线无缝衔接,为自动化生成模型性能看板、进行盲测对比以及构建初始化的ELO等级分提供了标准输入。领域开发者亦可以此为依据,筛选出在延迟与精度间取得最佳平衡的STT引擎,作为其产品集成的首选。整个引用与集成过程遵循Apache-2.0许可,且依托可复现的构建脚本,保证了其评测模式的公开、公平与延续性。
背景与挑战
背景概述
ovos-stt-bench-mls-es-ES数据集由OpenVoiceOS团队于近期创建,作为OVOS插件竞技场基准测试体系的一部分,旨在评估多语言自动语音识别(ASR)系统在西班牙语(es-ES)上的性能。该数据集基于Facebook的多语言LibriSpeech语料库,为每个音频片段提供了多个竞品ASR插件的转写预测结果,并附有详细的元数据(如数据集版本、插件版本和延迟)。其核心研究问题是为ASR领域提供一个可复现、标准化的评估平台,推动语音识别技术的进步。通过公开竞争与盲测机制,该数据集不仅促进了ASR系统间的横向对比,还催生了一个基于ELO评分的天梯体系,对后续研究具有启发意义。资金支持来自NGI0 Commons Fund与欧洲委员会,彰显了其在开放科学和语言技术领域的影响力。
当前挑战
该数据集面临的挑战主要分为领域问题与构建过程两方面。在领域问题上,它针对自动语音识别(ASR)评测中常见的鲁棒性与泛化性问题,特别是多语言环境下的性能波动,提供了统一基准以衡量不同系统的准确性、效率和稳定性。构建过程中,则遇到了数据一致性、可复现性与公平性等难题——需确保所有预测遵循统一规范(如固定数据集版本、插件版本),避免因版本差异导致偏差;同时,需处理大规模音频转写的高计算成本与延迟测量,以及保护隐私和遵守许可协议等法律伦理问题。这些挑战需通过严谨的脚本流程和透明的元数据管理来化解,以保证基准的客观性和可信度。
常用场景
经典使用场景
ovos-stt-bench-mls-es-ES数据集作为OpenVoiceOS插件竞技场的一部分,专门用于西班牙语自动语音识别(ASR)系统的性能基准测试。该数据集基于Multilingual LibriSpeech的西班牙语子集,提供了不同STT插件在相同音频片段上的逐句转录预测结果,使研究者能够在统一框架下公平比较各系统的识别精度、延迟等关键指标。经典使用场景包括:在标准化的西班牙语语音语料上评估开源STT引擎(如Whisper、Vosk等)的稳健性,监控插件版本更新带来的性能波动,以及通过盲测或ELO评分机制进行多系统间的对抗性评估。该数据集设计严谨,每条记录包含固定的数据集修订版本、插件版本和延迟信息,确保了实验的可重复性和结果的可比性,是西班牙语语音识别社区中不可或缺的评测工具。
衍生相关工作
在此基础上,该数据集催生了一系列有价值的衍生工作。最直接的是OpenVoiceOS插件竞技场中基于这些预测结果构建的开放式榜单,它不仅给出了静态的准确率排名,还衍生出盲测战斗池和基于基准初始化的ELO积分体系,实现了一种动态、综合的模型能力评估机制,为社区提供了更加细致的模型相对实力图谱。研究者还利用此类结构化预测数据分析不同STT系统在特定口音、语速或噪声条件下的错误模式,从而引领了针对西班牙语的低资源或鲁棒性语音识别专项研究。另一方面,该数据集记录的延迟与性能数据为语音服务中的资源调度研究提供了实例,激发了面向多插件环境的智能路由算法探索。此外,其对成果可复现性的强调也促进了相关工具链的发展,即本数据集由自动化脚本生成,后续工作可借鉴此模式为其他语言或新的STT插件快速建立测评基准。
数据集最近研究
最新研究方向
在语音技术迅猛演进的当下,自动语音识别(ASR)系统的多语言与鲁棒性评估日益成为学界与工业界聚焦的前沿议题。该数据集依托OpenVoiceOS插件竞技场,针对多语种LibriSpeech中的西班牙语语料,汇集各参赛语音识别引擎的逐片段预测结果,构建了标准化、可复现的基准测试体系。其研究导向不仅涵盖跨语言迁移能力与识别精度的横向比对,更延伸到延迟、插件版本等系统性工程因素的纵向剖析,为语音助手的端到端性能优化提供了关键参照。由NGI0基金资助的这一开源评测框架,正推动ASR技术向更开放、可竞争的生态演进,其意义在于以众包验证的方式加速多语种语音界面的创新与落地。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务