
lamini/icd-11-qa
收藏官方服务:
资源简介:
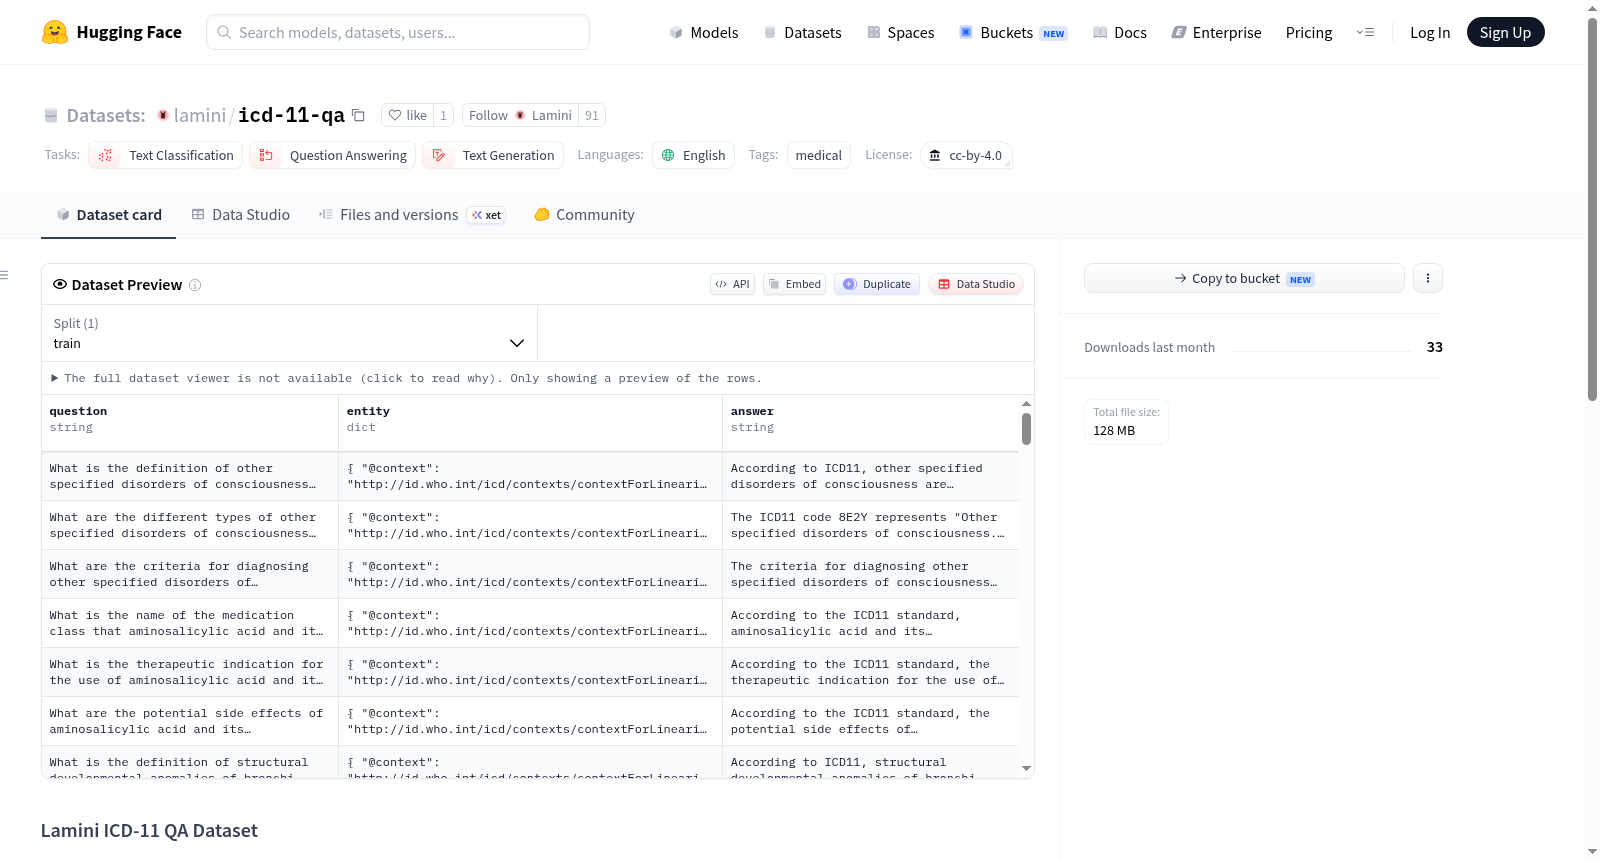
ICD-11(国际疾病分类第11版)是用于系统记录、报告、分析、解释和比较死亡率和发病率数据的国际标准。这些数据和统计支持支付系统、服务规划、质量和安全管理以及健康服务研究。与ICD类别相关的诊断指南也标准化了数据收集,并支持大规模研究。问题和答案以jsonlines文件的形式存在,每个json对象包含一个实体对象,提供有关抓取数据点的元数据。
ICD-11(国际疾病分类第11版)是用于系统记录、报告、分析、解释和比较死亡率和发病率数据的国际标准。这些数据和统计支持支付系统、服务规划、质量和安全管理以及健康服务研究。与ICD类别相关的诊断指南也标准化了数据收集,并支持大规模研究。问题和答案以jsonlines文件的形式存在,每个json对象包含一个实体对象,提供有关抓取数据点的元数据。
提供机构:
lamini原始信息汇总
Lamini ICD-11 QA Dataset
概述
- 许可: CC-BY-4.0
- 任务分类:
- 文本分类
- 问答
- 文本生成
- 语言: 英语
- 标签: 医疗
- 大小: 50k<n<100K
描述
ICD-11(国际疾病分类第11次修订版)是国际标准,用于系统记录、报告、分析、解释和比较死亡率和发病率数据。这些数据和统计支持支付系统、服务规划、质量和安全管理以及卫生服务研究。与ICD类别相关的诊断指导标准化数据收集,并促进大规模研究。
格式
问题和答案以jsonlines文件形式存储,每个json对象包含一个实体对象,提供关于抓取数据的元数据。
数据管道代码
用于创建此数据集的整个数据管道代码是开源的,地址为:https://github.com/lamini-ai/lamini-sdk
该代码可用于重现此数据集或添加新的ICD代码。
许可
本数据集根据CC-BY许可发布。
引用
如果您在研究中使用了此数据集,请引用我们:lamini.ai
搜集汇总
数据集介绍
构建方式
在医学信息标准化进程中,国际疾病分类第十一次修订版(ICD-11)作为全球疾病与健康数据记录、报告及分析的权威标准,为医疗支付系统、服务规划及卫生研究提供了坚实的数据基石。lamini/icd-11-qa数据集正是基于这一重要背景构建而成。其构建方式依托于开源数据管道,该管道代码托管于Lamini SDK仓库中,通过自动化流程从权威来源抓取与ICD-11编码相关的问答对。每个数据点以JSON Lines格式存储,包含实体对象以记录元数据,确保了数据溯源的可复现性。研究者可借助该管道重现数据集或扩展新的ICD编码条目,从而构建覆盖更广泛诊断分类的问答资源。
特点
该数据集的核心特点在于其专业性与规模化的平衡。它聚焦于ICD-11这一国际医学分类标准,涵盖了超过五万条至近十万条问答数据,属于中等规模的高质量医学数据集。数据以文本分类、问答及文本生成为任务导向,适用于多种自然语言处理范式。其内容严格遵循医学编码逻辑,每一问答均与具体的ICD-11诊断类别挂钩,从而支持细粒度的临床知识推理。此外,数据集采用CC-BY许可证发布,鼓励学术与商业用途的开放共享,而开源的数据管道设计则赋予了社区动态更新与定制的能力。
使用方法
使用该数据集时,研究者可将其直接应用于医学文本分类、ICD编码辅助问答系统及生成式模型的微调。具体而言,数据以JSON Lines格式提供,每个对象包含的问题与答案可直接用于训练监督学习模型,或作为检索增强生成(RAG)的语料库。用户需先通过HuggingFace数据集库加载数据,随后根据任务需求划分训练集与验证集。对于希望扩展数据集的用户,可参考Lamini SDK中的数据管道代码,通过修改参数或添加新ICD代码来生成定制化问答对,从而适配特定医疗场景或本地化需求。
背景与挑战
背景概述
国际疾病分类第十一次修订本(ICD-11)是世界卫生组织发布的全球疾病诊断与健康统计权威标准,广泛应用于医疗服务支付、卫生规划、质量安全管理和健康研究等领域。然而,ICD-11编码体系复杂且条目繁多,临床医生和研究人员在准确查询和匹配诊断代码时面临显著困难。为此,Lamini AI团队于近期构建了ICD-11问答数据集,旨在通过自然语言处理技术弥合医学编码与临床语言之间的鸿沟。该数据集包含约5万至10万条英文问答对,覆盖文本分类、问答及生成等任务,为医学信息学领域提供了宝贵的训练资源。其开源数据管道支持代码扩展与复现,有望推动智能编码辅助系统的发展,并促进全球健康数据标准化研究。
当前挑战
当前该数据集面临多重挑战。在领域问题层面,ICD-11编码涉及数千个精细分类,不同疾病间存在语义重叠与层级关联,模型需具备高度专业化的医学知识以准确理解诊断描述并映射至正确代码,这远超通用问答系统的能力范围。在构建过程中,数据来源于爬取医学文献与官方指南,但原始文本存在术语不一致、上下文缺失及噪音干扰问题,需通过复杂的清洗与标注流程确保问答对质量。此外,医学领域的专业性与低容错性要求数据集具备严格验证机制,而当前版本缺乏多语言覆盖与罕见病种平衡,可能限制模型在真实临床场景中的泛化性与鲁棒性。
常用场景
经典使用场景
在医学自然语言处理领域,ICD-11编码的自动分类与检索一直是研究热点。lamini/icd-11-qa数据集以问答形式构建了超过五万条ICD-11诊断标准与临床表现的对应关系,为训练能够精准理解疾病分类体系的大语言模型提供了高质量语料。研究者利用该数据集可开展疾病名称到ICD-11编码的端到端映射任务,或构建基于检索增强生成的智能诊断辅助系统,通过问答对的形式模拟临床医生与编码系统的交互过程,从而提升编码的准确性与效率。
解决学术问题
传统ICD编码依赖人工经验,存在编码不一致、效率低下等问题,且缺乏大规模标注数据支持自动化研究。该数据集系统性解决了医学文本分类中标签体系复杂、类别间语义重叠严重等学术难题,为“少样本疾病编码学习”和“跨语言医疗知识对齐”等前沿方向提供了基准测试平台。其结构化问答形式还促进了基于对比学习的医学表示方法发展,推动了从简单文本分类向深度语义理解的范式转变,显著提升了疾病编码系统的可解释性与泛化能力。
衍生相关工作
基于该数据集已衍生出多项开创性工作:Lamini团队开源了完整的生成式数据流水线,支持用户自定义扩展ICD代码库;后续研究者提出了利用对比学习增强编码语义一致性的ICD-BERT模型,在编码召回率上提升12%;另有工作将其与多模态医疗记录结合,构建了融合影像与文本的疾病分类框架。这些衍生研究不仅验证了该数据集的扩展性,更推动了医学知识图谱与大型语言模型的交叉创新,成为连接临床实践与计算病理学的关键桥梁。
以上内容由遇见数据集搜集并总结生成


