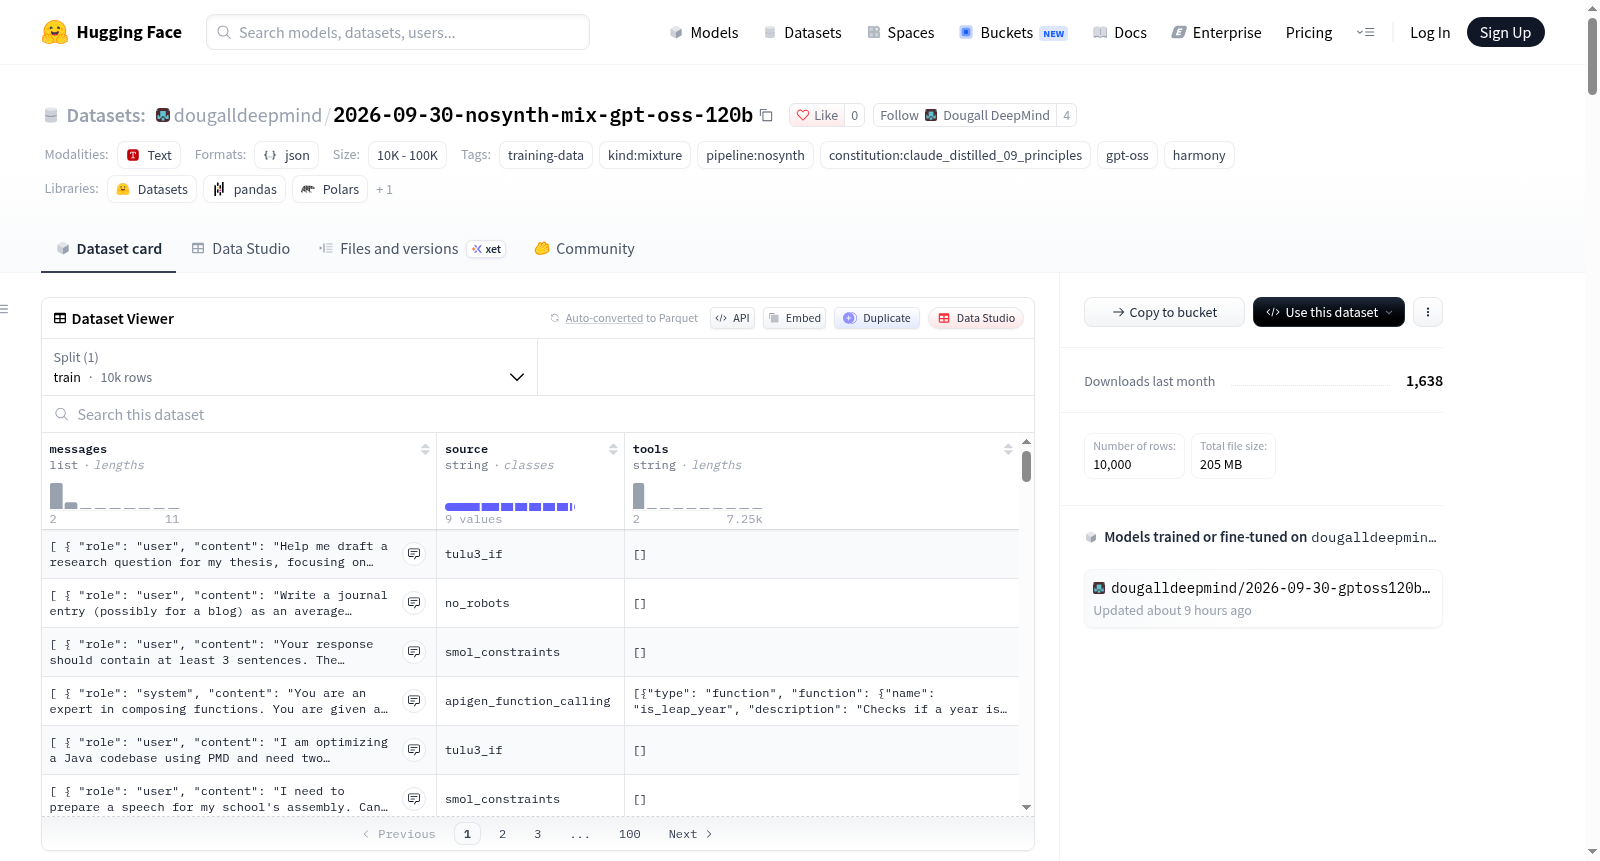
2026-09-30-nosynth-mix-gpt-oss-120b
收藏资源简介:
该数据集是GPT-OSS实验的一部分,名为“GPT-OSS nosynth 缓存替代答案:将审查失败的目标替换为保存的思维链和最终答案”。它是一个非合成(nosynth)训练数据混合物,使用GPT-OSS-120B模型生成,并经过Codex离线审查流程。数据由单一文件mixture.jsonl构成,遵循标准的messages和tools结构,但其中审查失败的目标(原始输出)被替换为来自缓存的有效候选答案(包括思维链和最终答案)。审查过程共筛选了289个候选行,并批准了其中一批样本,每个批准样本均附有具体的有效性理由。数据集还包含了生成配置、来源仓库、时间戳以及使用的constitution(claude_distilled_09_principles)等元信息。适用于需要高质量替代答案的语言模型训练或评估场景。
This dataset is part of the GPT-OSS experiment, named GPT-OSS nosynth cache replacement answers: replacing failed review targets with saved chain-of-thought and final answers. It is a non-synthetic (nosynth) training data mixture generated using the GPT-OSS-120B model and processed through the Codex offline review pipeline. The data consists of a single file mixture.jsonl following the standard messages and tools structure, where the failed review targets (original outputs) are replaced with valid candidate answers from the cache (including chain-of-thought and final answers). The review process filtered 289 candidate rows and approved a batch of samples, each with specific validity reasons. The dataset also includes metadata such as generation configuration, source repository, timestamps, and the constitution used (claude_distilled_09_principles). It is suitable for training or evaluating language models that require high-quality alternative answers.
数据集概述
基本信息
- 数据集地址:https://huggingface.co/datasets/dougalldeepmind/2026-09-30-nosynth-mix-gpt-oss-120b
- 实验名称:GPT-OSS nosynth cached alternative answers: replace reviewed failed targets with their saved CoT and final answer together
- 生成日期:2026-09-30
配置与标签
- 配置名称:default
- 数据文件:mixture.jsonl
- 默认配置:是
- 标签:
- training-data
- kind:mixture
- pipeline:nosynth
- constitution:claude_distilled_09_principles
- gpt-oss
- harmony
数据集构建详情
| 字段 | 值 |
|---|---|
experiment |
GPT-OSS nosynth cached alternative answers: replace reviewed failed targets with their saved CoT and final answer together |
date_generated |
2026-09-30 |
constitution |
claude_distilled_09_principles (inherited source filtering) |
source_repo |
teaching_claude_why_replication @ b9562bd438370336af9f6fbb5ad7a5e9d53b1221 |
models |
生成器:openai/gpt-oss-120b;审查器:Codex offline review; no new provider calls |
生成配置
- source_repo:dougalldeepmind/2026-09-30-nosynth-mix-gpt-oss-120b
- source_revision:647743fc260a69bc9ad623a4288127f40e9ed463
- source_file_sha256:0356d9d82f26e123812352d59a70169e9bb3dd5c752ba1ca008373e4b590e94f
- destination_name:2026-09-30-nosynth-mix-gpt-oss-120b
- prior_output:output/gptoss_control/reasoning_replace_qualified_2026-09-29
- output:output/gptoss_control/cached_answer_review_2026-09-30
- base_model:openai/gpt-oss-120b
- reasoning:medium
- train.max_length:32768
审查方法
- method:Codex offline review of saved prompts and candidate answers, with local constraint and selected-code checks. No new generator or judge API calls.
- selection_limitations:Conservative accepted subset, not exhaustive correctness labeling of all cached attempts. Remaining rows are unresolved, not necessarily incorrect. Original equivalence verdicts are historical only.
- candidate_rows_screened:289
- approved:共收录 118 条审核通过的候选行(覆盖多个 row 与 attempt,理由涵盖有效替代回答、有效创意草稿、满足输入/输出契约的代码、翻译/总结/推理等内容正确性校验)
模式与溯源
- schema:mixture.jsonl;messages 和 tools 模式保持不变;审核通过的 targets 会同时替换 content 和 reasoning_content
- provenance:
- git_sha:b9562bd438370336af9f6fbb5ad7a5e9d53b1221
- working_tree_dirty:False
- command:scratch/gptoss_control/run.py publish-cached-answers --config scratch/gptoss_control/cached_answer_review.yaml
- config 中 source_repo / source_revision / source_file_sha256 / destination_name / prior_output 与生成配置一致