
遇见数据集

ddidacus/nuevamol-chembl-eval-set

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

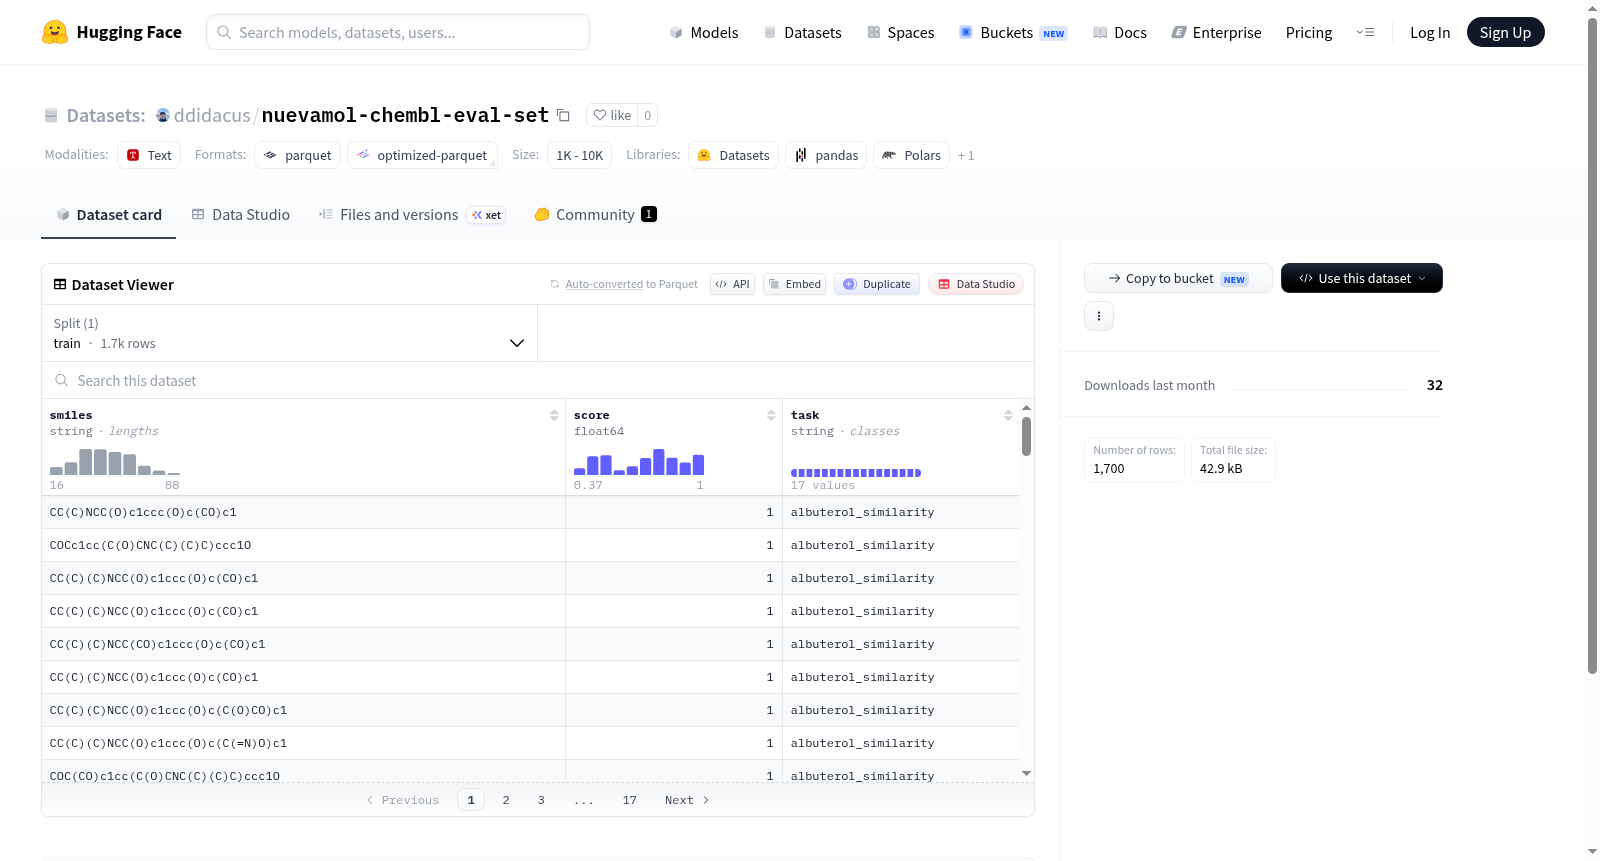
该数据集是一个包含化学结构数据的训练集,主要用于化学或生物信息学任务。数据集中包含三个字段:smiles(表示化学结构的字符串)、score(表示评分或属性的浮点数)和task(表示任务类型的字符串)。数据集共有1700个样本,所有数据均用于训练分割,总大小约为132.9 KB,下载大小约为40.1 KB。数据文件以train-*格式存储,适用于机器学习和模型训练应用。

This dataset is a training set containing chemical structure data, primarily used for chemistry or bioinformatics tasks. It includes three fields: smiles (a string representing chemical structures), score (a float representing scores or properties), and task (a string indicating the task type). The dataset consists of 1700 samples, all allocated to the train split, with a total size of approximately 132.9 KB and a download size of approximately 40.1 KB. The data files are stored in the train-* format and are suitable for machine learning and model training applications.
提供机构:
ddidacus
搜集汇总
数据集介绍
ddidacus/nuevamol-chembl-eval-set 数据集图片
构建方式
nuevamol-chembl-eval-set数据集是基于ChEMBL数据库构建的分子活性评估基准。该数据集从ChEMBL中筛选出1700个化合物样本,每个样本包含SMILES分子结构表示、对应的活性分数(score)和任务标签(task)。数据以单一训练集(train)形式组织,总大小为132874字节,下载大小约为40075字节。数据集的构建旨在为分子活性预测任务提供标准化的评估平台,确保样本的质量与多样性。
特点
该数据集的核心特点在于其简洁而有效的结构设计。每个样本仅包含三个关键字段:SMILES字符串用于描述分子结构,float64类型的score表示活性评分,以及string类型的task标注任务类别。这种轻量化设计便于研究者快速加载和处理。1700个样本的规模虽不算庞大,但足以支撑模型性能的初步评估与对比分析。数据集的单一训练集划分简化了训练流程,使其特别适合作为基准测试集使用。
使用方法
使用该数据集进行模型训练或评估时,推荐通过HuggingFace Datasets库加载。研究者可直接调用load_dataset('nuevamol-chembl-eval-set')函数,自动获取格式化的数据。SMILES字段可输入分子图或序列模型,score作为回归或分类任务的标签,task字段则用于区分不同评估场景。数据集已预分为训练集,用户可根据需要自行划分验证集和测试集。建议结合RDKit等化学信息学工具对SMILES进行预处理,以适应特定模型架构的输入要求。
背景与挑战
背景概述
在药物发现与化学信息学领域,分子活性预测是一项核心任务,旨在从分子结构出发精准评估其生物活性。nuevamol-chembl-eval-set数据集于近年来由相关研究机构构建,其命名暗示与ChEMBL数据库及NuevoMol分子生成平台的关联,聚焦于解决分子生成与活性评分之间的衔接问题。该数据集包含1700个训练样本,每个样本由SMILES分子表示、连续分值score及任务类型task组成,为多任务分子活性评估提供了标准化基准。其影响力在于推动机器学习模型从单纯分子生成向活性导向的优化转变,促进了药物候选分子的高效筛选与评估体系的发展。
当前挑战
该数据集面临的核心挑战在于分子活性预测的领域复杂性:首先,分子结构的化学空间极其庞大且离散,准确预测活性需突破传统描述符的表达局限,而现有模型常因泛化能力不足而失效。其次,构建过程中面临标注稀疏性与数据不均衡问题,ChEMBL数据库中的活性数据多集中于已知靶标,导致模型对新靶标或罕见分子的预测偏差显著。此外,SMILES表示易受语法变异影响,标准化处理与任务分解(如区分不同活性类型)增加了模型架构设计的难度,亟需开发更强的分子嵌入与多任务学习策略以应对这些瓶颈。
常用场景
经典使用场景
在药物发现与分子机器学习领域,nuevamol-chembl-eval-set数据集常被用作评估分子性质预测模型的标准基准。该数据集包含1700个样本,每个样本由SMILES分子结构表示以及对应的连续评分值(score)构成,并标注了具体的任务类型(task)。研究者通常利用该数据集来验证模型在分子活性预测、毒性评估或药代动力学性质推断等任务上的泛化能力。通过统一的评估协议,该数据集为对比不同架构(如图神经网络、Transformer或基于序列的模型)在分子性质预测中的表现提供了可靠平台。
解决学术问题
该数据集致力于解决化学信息学中分子性质预测任务的标准化评估难题。在缺乏统一基准的情况下,不同研究提出的模型难以进行公平比较,导致学术进展缺乏可重复性。nuevamol-chembl-eval-set通过提供精心筛选的分子-评分对,使研究者能够系统性地评测模型在多样化学空间中的预测精度与鲁棒性。它特别关注模型在低数据量场景下的表现,推动了对少样本学习、迁移学习以及分子表示学习等基础问题的深入探索。
衍生相关工作
基于此数据集,衍生出了一系列经典研究工作,包括开发新型分子图神经网络架构(如MPNN和GIN的变体)、引入自监督预训练策略(如分子级对比学习)以提升模型在有限数据下的表现,以及探索不确定性估计方法(如贝叶斯神经网络)来量化预测置信度。这些工作不仅深化了对分子结构-性质关系的理解,还推动了化学信息学向更可靠、更可解释的方向发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

