
PaDaS-Lab/legal-reference-annotations
收藏官方服务:
资源简介:
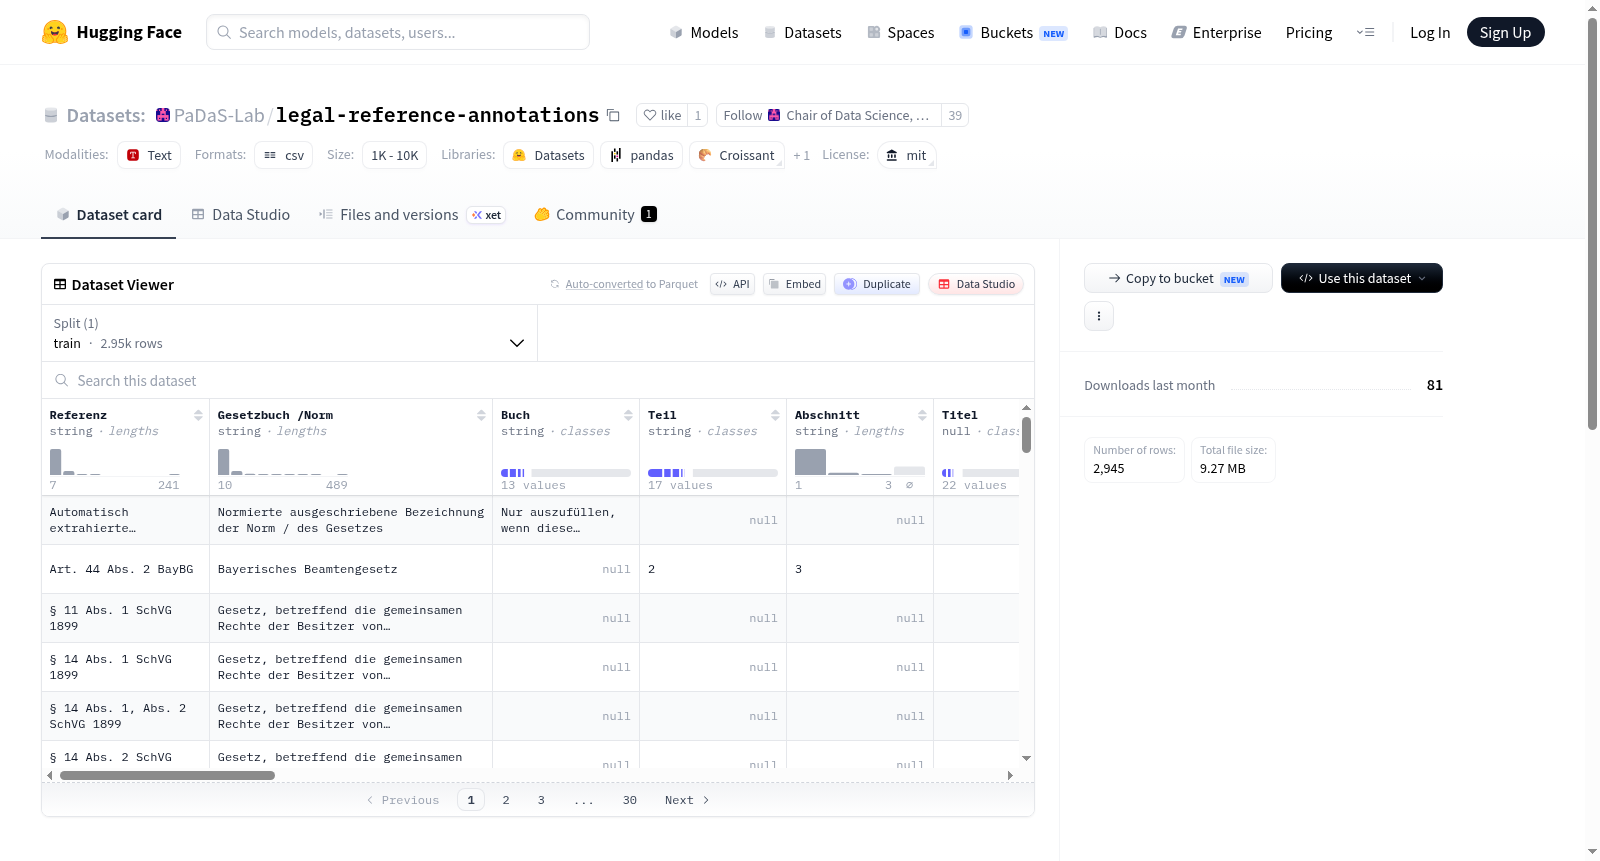
该数据集包含2944个德国法律引用,这些引用由法律专家手动注释。每个法律引用包含21个属性,如_Buch_、_Teil_、_Titel_、_Untertitel_等。此外,数据集还提供了每个法律引用的完整文本以及法律引用中提到的具体段落文本。该数据集旨在为法律自然语言处理领域的研究提供支持,特别是在法律文本之间的上下文相似性分析方面。
该数据集包含2944个德国法律引用,这些引用由法律专家手动注释。每个法律引用包含21个属性,如_Buch_、_Teil_、_Titel_、_Untertitel_等。此外,数据集还提供了每个法律引用的完整文本以及法律引用中提到的具体段落文本。该数据集旨在为法律自然语言处理领域的研究提供支持,特别是在法律文本之间的上下文相似性分析方面。
提供机构:
PaDaS-Lab原始信息汇总
数据集概述
数据集内容
- 类型: 德国法律参考数据集
- 规模: 包含2944个法律参考条目
- 特点:
- 由法律专家手动标注
- 每个法律参考条目包含21个属性,如_Buch_, Teil, Titel, _Untertitel_等
- 提供完整的法律参考文本及特定段落文本
数据集用途
- 支持法律自然语言处理研究
- 用于法律参考预测任务
数据集引用信息
- 作者: Harshil Darji, Jelena Mitrović, Michael Granitzer
- 出版信息:
- 出版年份: 2023
- 出版社: Association for Computing Machinery
- 会议: Proceedings of the Nineteenth International Conference on Artificial Intelligence and Law (ICAIL 23)
- 地点: Braga, Portugal
- 引用格式: tex @inproceedings{10.1145/3594536.3595173, author = {Darji, Harshil and Mitrovi{c}, Jelena and Granitzer, Michael}, title = {A Dataset of German Legal Reference Annotations}, year = {2023}, isbn = {9798400701979}, publisher = {Association for Computing Machinery}, address = {New York, NY, USA}, url = {https://doi.org/10.1145/3594536.3595173}, doi = {10.1145/3594536.3595173}, booktitle = {Proceedings of the Nineteenth International Conference on Artificial Intelligence and Law}, pages = {392–396}, numpages = {5}, keywords = {NLP, Law Reference Annotations, Sentence Transformers, Legal Language Processing, Law References, Open Legal Data}, location = {Braga, Portugal}, series = {ICAIL 23} }
许可协议
- 协议: MIT License
搜集汇总
数据集介绍
构建方式
在自然语言处理与法律人工智能交叉领域中,结构化的法律数据资源长期匮乏,尤其缺乏能够将法律引用细粒度拆解并辅以语义信息的标注数据集。为填补这一空白,PaDaS-Lab/legal-reference-annotations 数据集应运而生。该数据集聚焦德国法律体系,由法律专家对2944条法律引用进行人工标注,每条引用均涵盖21个属性字段,包括Buch、Teil、Titel、Untertitel等层级化结构信息,同时提供引用对应的完整法律文本及所涉具体段落内容。构建过程严格遵循专家知识引导,确保标注的准确性与领域适配性,为法律文本的结构化解析奠定了坚实基础。
特点
该数据集的核心特色在于其精细的层级化标注体系与语义完整性。每条法律引用不仅被分解为多达21个结构化属性,精准捕获法律条文的组织架构,还同步保留了引用所指向的完整法律文本与段落内容,实现了从引用片段到原始法规的无缝映射。这种双重信息维度使得数据集既支持法律引用的细粒度识别与解析,又能服务于上下文相似度计算、法律文本与案例关联等进阶研究。此外,数据集基于德国法律专家的人工标注,保证了高标准的领域准确性与注释一致性,为法律NLP任务提供了可靠的地面真值。
使用方法
该数据集可直接用于训练和评估法律文本解析模型,例如法律引用识别、结构成分抽取或引用完整性预测等任务。研究人员可将其与Open Legal Data等外部法律知识库结合,开展法律引用预测实验,比较完整引用与基础引用之间的性能差异。数据集以标准JSON或表格格式提供,便于加载至常见机器学习框架。使用时应引用原始论文,标注出自ICAIL '23会议,以尊重创作者的学术贡献并确保研究可复现。
背景与挑战
背景概述
在法律自然语言处理领域,结构化数据的匮乏长期制约着研究进展,尤其是针对德语法学文本的细粒度标注资源尤为稀缺。由Harshil Darji、Jelena Mitrović与Michael Granitzer于2023年联合创建的PaDaS-Lab/legal-reference-annotations数据集,旨在弥合这一鸿沟。该数据集包含2944条由法律专家手工标注的德国法律引用,每条引用涵盖21种属性(如章节、部分、标题、子标题等),并附有完整法律文本及其具体段落内容。研究团队依托此数据集,结合Open Legal Data平台,探索了法律引用预测任务,对比了完整引用与基础引用的预测性能,为法律文本语义相似度及案件与法律条文关联性研究提供了关键基准。该工作发表于ICAIL '23国际会议,对推动德语法学信息抽取与智能法律分析具有里程碑意义。
当前挑战
该数据集面临的核心挑战包括:其一,法律引用结构的复杂性与多样性——德国法律体系包含大量嵌套式引用(如跨章节、跨条款的交叉引用),且不同法律文本的层级定义(如Buch、Teil、Titel)存在非标准差异,导致自动解析与标注一致性困难;其二,构建过程中需克服专家标注的高昂成本与主观偏差,2944条样本虽经严格审核,但面对德国法律体系庞大体量,数据规模仍显不足,难以覆盖所有引用模式;其三,引用预测任务中,模型需同时处理基础法律引用与完整引用间的语义映射,而现有方法在长距离依赖与模糊引用消歧上表现欠佳,限制了其在真实法律检索与判例推理场景中的泛化能力。
常用场景
经典使用场景
在自然语言处理与法律人工智能的交叉领域中,PaDaS-Lab/legal-reference-annotations数据集为德国法律文本的结构化解析提供了宝贵的资源。该数据集包含2944条由法律专家手工标注的法律引用,每条引用细分为21个属性字段,如Buch、Teil、Titel等,并附有完整的引用文本及相关段落内容。经典使用场景聚焦于法律引用解析任务,即从非结构化法律文本中自动识别并拆解引用成分,支撑法律文档的语义理解与信息抽取。
实际应用
在实际应用中,该数据集赋能法律科技产品的自动化能力,例如智能法律检索系统可借助其标注结构精准定位法条中的具体条款,提升法律咨询机器人的应答准确性。它还能用于法律文档的自动摘要与合规性审查,辅助律师或法官快速核验法律依据。此外,结合开放法律数据平台,该数据集支持法律判决预测与案件推理系统的研发,降低人工查阅海量法条的时间成本。
衍生相关工作
基于该数据集,衍生出一系列经典工作,包括利用Sentence Transformers进行法律引用嵌入表示的研究,以及对比不同模型在法条预测任务上的表现。研究者还将其与Open Legal Data结合,开展多层级法律引用预测实验,推动了法律语言模型微调策略的优化。此外,该数据集启发了针对跨法律体系引用标注标准的讨论,为后续德语法律领域乃至其他语种的法律NLP基准构建奠定了基础。
以上内容由遇见数据集搜集并总结生成


