
遇见数据集

skonan/PaperLens-arXiv-embeddings

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

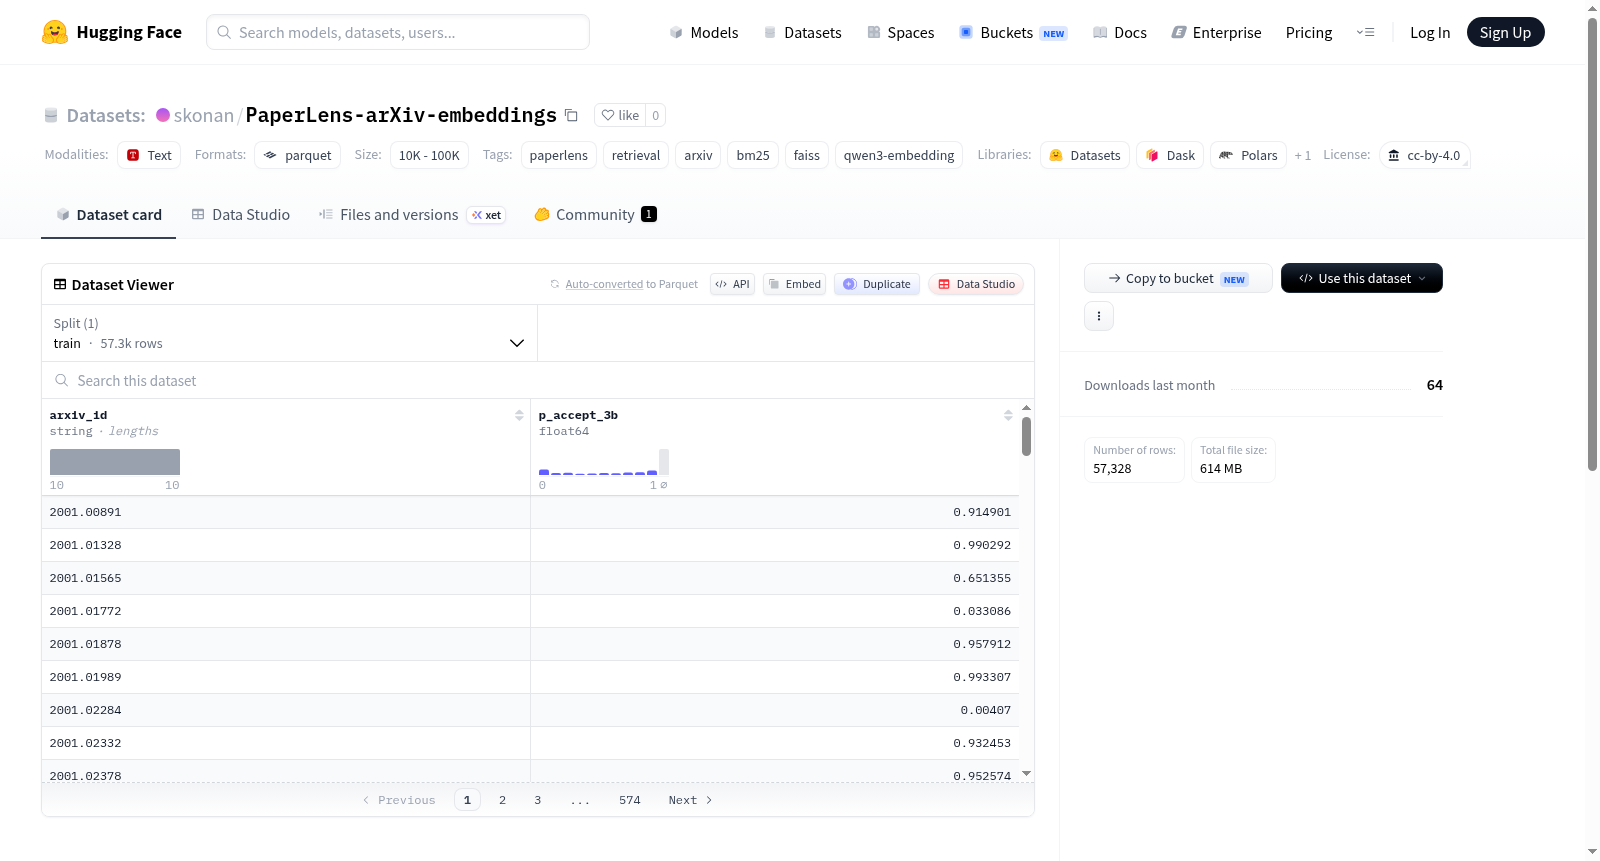
PaperLens arXiv per_venue检索索引数据集是一个用于PaperLens arxiv搜索和重排部署的索引包和p_accept缓存种子。它覆盖了来自LitSearch重排实验的约80,000篇per_venue arXiv语料库。数据集包含以下组件:Lucene BM25索引(基于pyserini)、Qwen3-Embedding-0.6B密集FAISS(Flat)索引、语料库文件(用于将FAISS位置解析为arxiv_id),以及预计算的p_accept值(分别用于3B和7B重排器,覆盖约28,664篇论文)。这些资源支持检索系统的快速部署和高效运行,但排除了仅用于重建的嵌入内存映射和完整元数据。

PaperLens arXiv per_venue retrieval indexes is an index bundle and p_accept cache seed for the PaperLens arxiv search/rerank deployment. It covers the ~80K per_venue arXiv corpus from the LitSearch reranking experiment. The dataset includes: a Lucene BM25 index (pyserini) over the per_venue corpus, a Qwen3-Embedding-0.6B dense FAISS (Flat) index, the per_venue corpus file (resolves FAISS position to arxiv_id), and precomputed p_accept for the 3B and 7B rerankers (covering ~28,664 papers). These components facilitate retrieval and reranking operations, excluding rebuild-only embedding memmap and full metadata.
提供机构:
skonan
搜集汇总
数据集介绍
skonan/PaperLens-arXiv-embeddings 数据集图片
构建方式
PaperLens-arXiv-embeddings 数据集依托于 LitSearch 重排序实验中的约八万篇 arXiv 论文,构建了一套跨模态的检索索引体系。其核心包括基于 Pyserini 框架构建的 Lucene BM25 稀疏索引、采用 Qwen3-Embedding-0.6B 模型生成的稠密 FAISS Flat 索引,以及一份 JSONL 格式的语料文件,用于将 FAISS 位置映射至 arxiv_id。此外,数据集中还预存了基于 3B 与 7B 重排序模型计算得到的 p_accept 缓存,覆盖约 28,664 篇论文,形成一套完整的检索-重排序 pipeline 基础组件。
特点
该数据集具备多层次的检索与重排序能力,同时支持稀疏检索(BM25)与稠密检索(FAISS)两种范式,兼顾效率与精度。其预计算的 p_accept 缓存可直接服务于重排序模型的评估与推理,大幅降低在线计算开销。所有索引与缓存文件均以标准化格式存储,便于与 PaperLens 工具链无缝集成,且通过 HuggingFace 缓存机制实现高效下载与复用。数据集的模块化设计使其能够灵活适配不同规模的检索场景。
使用方法
使用者可通过 `paperlens setup --with-retrieval` 命令自动下载索引文件至 HuggingFace 缓存,并生成对应的 `arxiv_retriever` 配置。随后执行 `paperlens serve --with-retrieval` 即可基于服务检查点从预计算 p_accept 缓存中加载数据,启动检索服务。若需离线使用,可直接读取 `corpus/arxiv_wikiformat_per_venue.jsonl` 文件解析论文 ID,并借助 BM25 或 FAISS 索引执行自定义检索任务,灵活整合至下游工作流中。
背景与挑战
背景概述
PaperLens-arXiv-embeddings数据集由人工智能研究社区于2024年创建,主要出自LitSearch重排序实验团队之手,旨在为arXiv学术论文的检索与重排序任务提供标准化索引资源。该数据集基于约8万篇按领域划分的arXiv论文语料库,融合了BM25稀疏检索与Qwen3-Embedding-0.6B密集向量检索两种主流范式,并配套预计算的重排序置信度缓存。作为PaperLens系统的核心组件,它显著降低了学术检索实验的复现门槛,为信息检索领域的研究者提供了可复用的基准平台,尤其在结合稀疏与密集检索的混合方法研究中展现出重要影响力。
当前挑战
该数据集所解决的领域挑战主要来自学术论文检索场景下如何高效融合稀疏检索(如BM25)的精确匹配能力与密集向量检索的语义理解能力,以提升对长尾、跨学科文献的召回效果。在构建过程中,挑战体现在三个方面:一是需要将arXiv论文按领域细分为约8万篇的语料,确保领域划分的合理性与检索索引的领域专注性;二是为30亿与70亿参数的重排序模型预计算约2.87万篇论文的p_accept置信度,需要平衡推理成本与预测精度;三是维护多格式索引(Lucene、FAISS、JSONL)之间的一致性,确保下载配置与SQLite缓存的自动对接无缝可靠。
常用场景
经典使用场景
在学术信息检索领域,论文检索与重排序是挖掘海量科学文献价值的关键环节。PaperLens-arXiv-embeddings数据集的核心使用场景在于为arXiv论文提供高效的检索与重排序服务。该数据集整合了基于BM25的稀疏检索索引与基于Qwen3-Embedding-0.6B模型的稠密FAISS索引,覆盖了约8万篇来自各细分领域的论文语料。通过构建这样的混合检索管道,研究者能够实现从初筛到精排的完整流程,既利用稀疏索引的快速匹配能力召回候选文献,又借助稠密嵌入的语义理解进行精准重排,从而显著提升文献发现的质量与效率。
解决学术问题
学术研究中,如何从日益膨胀的预印本论文中快速、准确地定位与当前工作高度相关的文献,始终是一个核心挑战。PaperLens-arXiv-embeddings数据集针对性地解决了跨模态检索中的语义鸿沟问题:传统关键词检索往往因用词差异而遗漏重要文献,而纯向量检索又可能因缺乏领域先验而引入噪声。该数据集通过融合BM25的词汇匹配与稠密嵌入的语义编码,并预计算了3B与7B两种规模重排序模型的论文接受概率(p_accept),为研究者提供了一种可复现、可部署的检索基准。其重要意义在于,它首次将面向特定语料库(per_venue)的索引构建与重排序缓存公开化,推动了学术检索方法从理论评估向实际系统使用的跨越。
衍生相关工作
围绕PaperLens-arXiv-embeddings数据集,学术社区已衍生出一系列富有影响力的工作。最直接的是,该数据集作为LitSearch重排序实验的核心组件,成为了验证新一代嵌入模型(如Qwen3系列)在学术检索任务中性能的标杆。此外,研究者基于此数据集开发了多种混合检索策略,探讨了如何动态平衡稀疏索引与稠密索引的权重,以及如何利用p_accept缓存设计更高效的在线排名算法。更进一步,该数据集的发布催生了若干关于学术论文表征学习的研究,这些工作旨在优化针对arXiv语料的嵌入质量。最后,数据集的标准化索引格式(FAISS + Pyserini)也被其他论文检索项目广泛借鉴,推动了学术信息检索领域的基准统一与社区协作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

