
遇见数据集

greek-synth-v1

收藏
Hugging Face2026-05-27 更新2026-05-28 收录
官方服务:

资源简介:

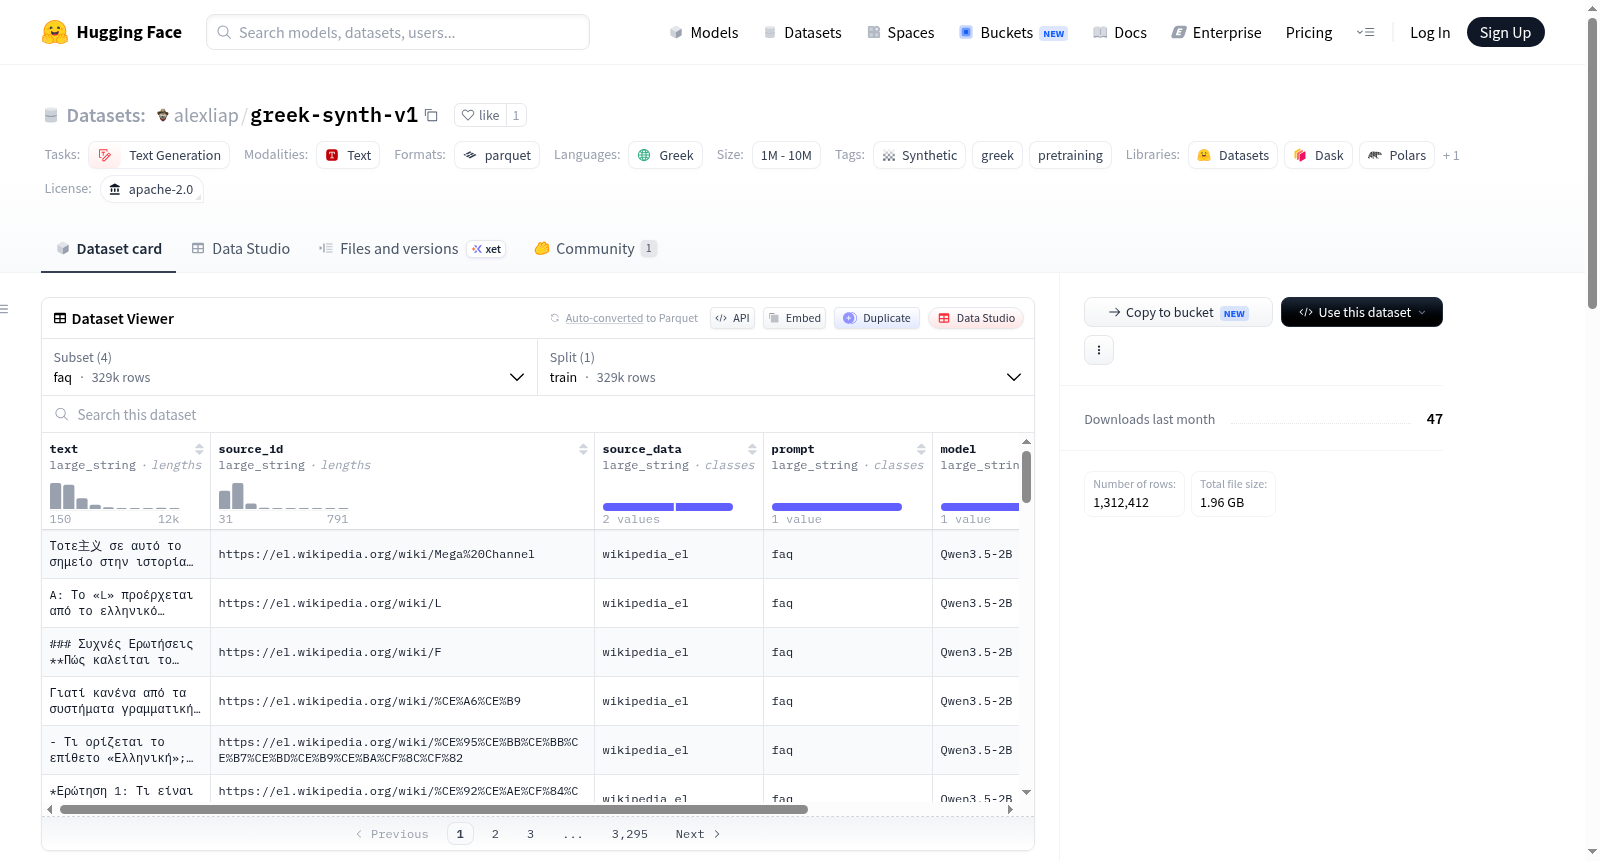
Greek Synthetic Data 是一个希腊语合成预训练数据集,专为文本生成任务设计。该数据集通过四种教学丰富的提示格式(FAQ、数学、表格、教程)对源文档进行重述生成,旨在提供高质量的预训练数据。数据基于源语料库 alexliap/high-quality-gr-text 生成,覆盖了 wikipedia_el 和 finewiki_el 配置,而 finepdfs_el 和 fineweb_hq_el 配置尚未完成。数据集包含四个配置(faq、math、table、tutorial),每个配置对应一种提示格式,数据以 Parquet 分片形式存储。每个数据样本包含以下字段:text(合成输出文本)、source_id(源文档ID)、source_data(源数据集配置)、prompt(提示格式,如 faq、math、table、tutorial)、model(重述模型及版本)和 language_confidence(基于 fastText lid.176 的希腊语概率后过滤置信度)。生成过程使用 Qwen/Qwen3.5-2B 模型通过 vLLM 端点在 Lightning AI 基础设施上运行,代码开源在 gr-synth 仓库。该数据集适用于希腊语文本生成、预训练和合成数据研究等场景。

创建时间:
2026-05-23
原始信息汇总

数据集概述

  • 名称: Greek Synthetic Data (greek-synth-v1)
  • 许可证: Apache-2.0
  • 语言: 希腊语 (el)
  • 任务类别: 文本生成 (text-generation)
  • 标签: 合成 (synthetic), 希腊语 (greek), 预训练 (pretraining)

数据集描述

该数据集是通过将原始文档重新表述为四种教学丰富的提示格式(FAQ、Math、Table、Tutorial)生成的希腊语合成预训练数据。生成方法基于《The Synthetic Data Playbook: Generating Trillions of the Finest Tokens》。

覆盖状态

数据集基于源语料库 alexliap/high-quality-gr-text,每个配置分别进行重新表述,并合并到相同的提示子目录中。源配置信息保留在每一行的 source_data 列中。覆盖状态如下:

  • wikipedia_el(已完成)
  • finewiki_el(已完成)
  • finepdfs_el(未完成)
  • fineweb_hq_el(未完成)

数据配置与文件

数据集包含四个配置,每个配置对应一种提示格式,数据以 Parquet 格式分片存储:

配置 (config_name) 数据文件路径
faq faq/*.parquet
math math/*.parquet
table table/*.parquet
tutorial tutorial/*.parquet

数据模式 (Schema)

每一行数据包含以下字段:

列名 类型 说明
text string 合成生成的文本输出
source_id string 原始文档的 ID
source_data string 原始文档所在的源数据集配置
prompt string 提示格式:faq, math, table, tutorial 之一
model string 用于重新表述的模型及其修订版本
language_confidence float32 基于 fastText lid.176 模型的希腊语概率后过滤得分

基础设施与生成

  • 生成平台: 使用 Lightning AI 运行。
  • 重新表述模型: Qwen/Qwen3.5-2B,通过托管在 Lightning Studio 上的 vLLM 端点提供服务。
  • 流水线: 从独立机器将源语料库流式输入模型。
  • 生成代码: 代码仓库为 alexliap/gr_synth(GitHub)。
搜集汇总
数据集介绍
greek-synth-v1 数据集图片
构建方式
greek-synth-v1数据集的构建源于对高质量希腊语文本语料库的深度重构与扩展。以alexliap/high-quality-gr-text为源语料,借助Qwen3.5-2B模型,通过vLLM端点部署于Lightning AI平台,采用四种教学性提示格式——FAQ、数学、表格和教程——对原始文档进行改写生成合成数据。每个提示格式对应独立的子目录,源语料的配置信息完整保留于每一行的source_data列中,确保了数据来源的可追溯性。最终,所有改写结果以Parquet分片形式存储,构建出规模化的希腊语预训练语料。
使用方法
使用greek-synth-v1数据集时,可通过Hugging Face Datasets库按需加载不同配置,例如loading 'faq'、'math'、'table'或'tutorial'子集,每个子集以Parquet格式存储,支持高效流式读取。数据集专为文本生成任务设计,适用于希腊语预训练阶段的语言模型优化。用户可依据source_data列过滤特定来源语料,或借助prompt列选择特定提示格式的样本,灵活定制训练数据。代码生成工具与完整pipeline均开源,便于复现与扩展。
背景与挑战
背景概述
在自然语言处理领域,大规模高质量预训练语料的匮乏长期制约着低资源语言模型的发展,尤其是希腊语等小语种,其数据规模与多样性远不及英语等主流语言。为此,研究团队于2024年构建了greek-synth-v1数据集,由研究者Alex Liapis主导,基于HuggingFace社区公开的高质量希腊语文本语料库,借助Qwen3.5-2B模型通过四种教学式提示格式(FAQ、数学、表格、教程)对源文档进行改写生成合成数据。该数据集遵循Apache-2.0许可协议,旨在为希腊语文本生成任务提供丰富的预训练素材,其方法论源自《The Synthetic Data Playbook》,对推动小语种自然语言处理研究具有重要示范意义。
当前挑战
greek-synth-v1数据集所解决的领域核心挑战在于希腊语预训练数据的稀缺性与多样性不足,传统语料库往往局限于单一来源或格式,难以支撑模型泛化能力的提升。在构建过程中,研究团队面临两大具体挑战:其一,源语料库覆盖不完整,如finepdfs_el与fineweb_hq_el子集尚未纳入数据生成流程,限制了合成数据的全面性;其二,大规模流式改写对计算基础设施提出高要求,需协调Lightning AI平台上的vLLM端点与独立机器间的数据管道,确保Qwen3.5-2B模型的高效推理与输出质量,同时通过fastText语言置信度过滤机制保障生成文本的希腊语纯度。
常用场景
经典使用场景
希腊语合成数据greek-synth-v1的核心设计在于通过四种教学性丰富的提示格式(常见问题解答、数学推理、表格解析与教程编写)对原始语料进行重述,从而生成高质量、多样化的预训练文本。该数据集特别适用于低资源语言希腊语的大规模语言模型预训练,研究人员可将其作为增强语言模型对希腊语语义理解与生成能力的核心训练语料。其常见的使用方式包括:作为从头预训练的基础数据源,或用于领域自适应预训练以提升模型在希腊语问答、数学推理、结构化数据理解及教学文本生成等任务上的表现。
解决学术问题
该数据集直接回应了低资源语言在自然语言处理中面临的核心困境——高质量、大规模且语义丰富的预训练语料极度匮乏。通过合成数据策略,greek-synth-v1不仅扩充了希腊语的可用语料规模,更通过多样化的提示格式引入了结构化、逻辑性与教学性更强的文本样式,从而缓解了传统语料在知识密度和任务适应性上的不足。这一工作为探索合成数据在低资源语言预训练中的有效性提供了实证基础,并推动了多语言模型在语义保真度与任务迁移能力上的学术研究,尤其在如何通过可控生成提升数据质量与模型鲁棒性方面具有重要启示。
实际应用
在实际应用中,greek-synth-v1可直接赋能面向希腊语用户的智能文本服务,包括但不限于基于FAQ的自动客服系统、教育领域的智能辅导工具、表格数据的自然语言查询接口,以及教程内容的自动生成与摘要。此外,该数据集也可用于微调希腊语翻译、摘要与对话系统,提升其在教学与知识问答场景下的专业性。对于非希腊语的通用模型,引入该数据集进行继续预训练或指令微调,能显著增强模型在处理希腊语输入时的语义理解与生成流畅性,进而扩展多语言产品的用户覆盖面与服务质量。
数据集最近研究
最新研究方向
在低资源语言预训练领域,greek-synth-v1数据集开创性地采用基于问答、数学、表格与教程四种教学提示格式对希腊语源文档进行改写,生成高质量合成预训练语料,有效缓解了希腊语等小语种自然语言处理中数据匮乏的困境。该数据集紧跟《合成数据说明书》所倡导的范式,通过Qwen3.5-2B模型在Lightning AI基础设施上高效生成,兼顾内容多样性与语言保真度,并引入fastText语言置信度过滤机制确保数据质量。其意义在于为希腊语大型语言模型的训练提供了可复现、可扩展的合成数据生产路径,推动了非英语语言在文本生成任务上的前沿研究,也为其他低资源语言的数据增强策略树立了典范。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

