
遇见数据集

Chainticks/labor-demand-index

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

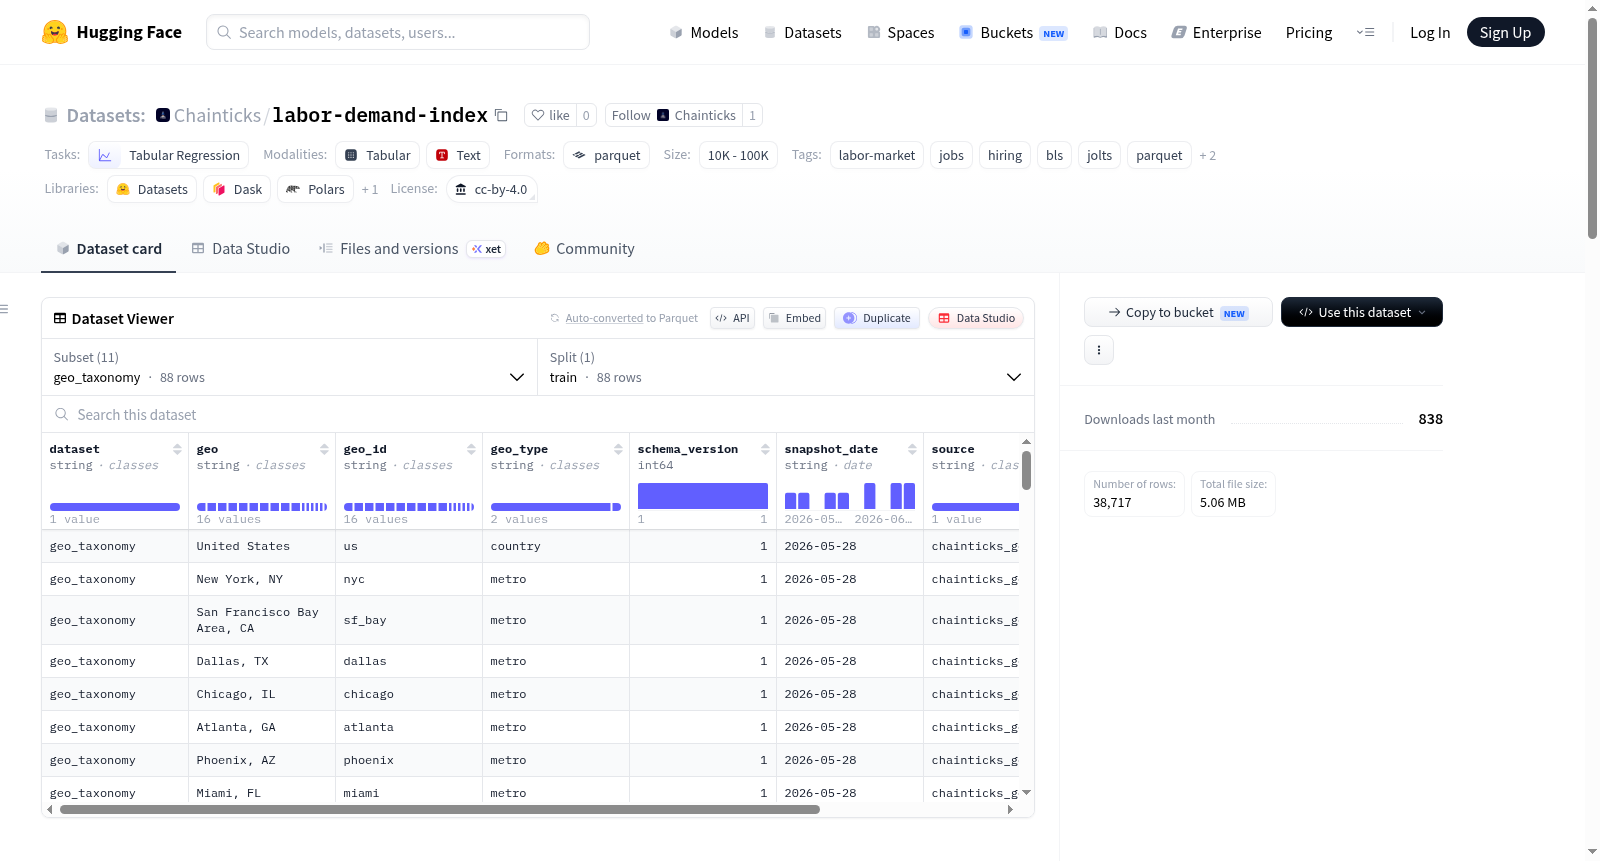
Chainticks劳动力需求指数是一个面向智能体的劳动力需求面板数据集,旨在帮助发现组织仍在招聘可能可自动化工作的人类岗位。该数据集仅发布聚合数据和官方公共领域序列,包括美国劳工统计局(BLS)JOLTS月度职位空缺、招聘、离职、解雇/遣散和分离数据(按美国行业分类)、从JOLTS衍生的职位空缺/招聘、离职/招聘、分离/招聘和同比职位空缺指标、按角色家族、地理和快照日期进行的小规模、速率限制的JobSpy查询聚合、跟踪的可自动化角色家族、查询术语、技能术语和自动化适应标签、每个跟踪搜索查询一行(以便查询面板可以演变而不改变下游模式)、每个跟踪工作流程的候选SOC、NAICS和JOLTS行业桥梁、收集器使用的跟踪JOLTS行业代码、用于轮换采样发布收集的稳定国家/都市面板。原始招聘信息、职位URL、公司名称、电子邮件和描述不包括在内。

An agent-friendly labor-demand panel for finding where organizations are still trying to hire humans for work that may be automatable. This dataset intentionally publishes aggregates and official public-domain series only: BLS JOLTS monthly openings, hires, quits, layoffs/discharges, and separations by US sector, derived vacancy/hire, quit/hire, separation/hire, and YoY openings metrics from JOLTS, small, rate-limited JobSpy query aggregates by role family, geography, and snapshot date, the tracked automatable role families, query terms, skill terms, and automation-fit labels, one row per tracked search query so query panels can evolve without changing downstream schemas, candidate SOC, NAICS, and JOLTS-sector bridges for each tracked workflow, the tracked JOLTS sector codes used by the collector, and the stable country/metro panel used for rotating sampled posting collection. Raw job postings, job URLs, company names, emails, and descriptions are not included.
提供机构:
Chainticks
搜集汇总
数据集介绍
Chainticks/labor-demand-index 数据集图片
构建方式
鉴于劳动力市场数据在宏观经济分析中的核心地位,Chainticks劳务需求指数的构建尤为审慎。该数据集通过整合美国劳工统计局(BLS)的公开领域数据与从公共网页按一定速率采样获得的职位发布聚合信息,形成多维度面板。具体而言,它系统性地融合了月度JOLTS官方统计数据(含修订历史)、衍生劳动力市场指标、按职能家族与地理区域采样的职位发布趋势(包括职位发布年龄信号),并引入自动化适应性评估,最终生成一个可审计的综合劳动力压力指数。整个构建过程严格排除了原始职位发布文本、公司名称等非公开或敏感信息,确保了数据的合规性与可复现性。
特点
该数据集最显著的特点在于其面向自动化时代研究需求的精心设计。它独树一帜地聚焦于那些可能被自动化替代的行政及后台岗位需求,通过职位发布的持久性(如30天、60天、90天内的僵化份额)来量化“无法雇到人类”的鲜明信号。同时,它构建了从采样的微观数据到官方宏观指标(如JOLTS行业紧张度)的稳健桥梁,并引入OEWS工资数据作为现实的劳动力成本锚点。此外,数据集的版本控制与按日期分区存储,使得时序分析与修订历史追溯成为可能,极大地便利了学术研究与政策制定。
使用方法
用户可通过Hugging Face Datasets库便捷加载数据,直接利用Python的Pandas库读取特定日期的Parquet文件以获取数据子集。为进行深入分析,建议将【sampled_posting_aggregates】中的职位发布聚合信号与【jolts_sector_metrics】等官方指标进行关联查询,利用【labor_pressure_index】作为核心分析表。尤其适用于追踪特定职能家族招聘需求的时间演变,或通过对比职位发布领先性与JOLTS修订版数据来进行临近预报。由于采样数据为方向性样本,分析时需注意仅在相同查询与来源配置下比较计数,并以BLS官方数据作为宏观基准,从而规避因采样偏差导致的影响。
背景与挑战
背景概述
Chainticks Labor Demand Index是由Chainticks团队创建的一个面向自动化时代劳动力需求监测的数据集,发布于2024年。该数据集聚焦于一个日益严峻的核心研究问题:在自动化浪潮下,哪些岗位仍存在难以被替代的人类劳动力需求。通过融合美国劳工统计局(BLS)的公开官方时间序列数据(如JOLTS、OEWS)与经过采样处理的在线招聘聚合指标,该数据集为经济学家、政策制定者及研究机构提供了首个可审计的劳动力压力指数。其在该领域的开创性贡献在于,不仅整合了宏观层面的行业招聘率、离职率等关键指标,还创新性地引入了职位发布时长、更新频率等微观“难以填补”信号,从而构建起一个从宏观到微观、从官方数据到实时采样的多维度劳动力需求监测体系,对劳动经济学、自动化影响评估及劳动力市场预测等研究领域具有重要参考价值。
当前挑战
该数据集面临的核心挑战在于解决劳动力市场监测中的两大难题。其一,领域问题层面,传统劳动统计(如JOLTS)存在发布滞后期与修订历史,无法及时捕捉因自动化导致的岗位需求结构性变化;数据集通过构建“劳动力压力指数”将自动化适应性、工作流程数字化程度与职位发布持久性等非传统信号融合,以更实时地识别那些组织仍试图招聘人类但可能长期空缺的岗位。其二,构建过程中面临显著的数据获取与质量挑战:在线招聘平台的速率限制、网页标记变化的不可预测性,以及来源覆盖范围因日期、站点、地域和查询措辞而异,导致`sampled_posting_aggregates`仅为定向样本而非普查数据;数据集设计者通过固定核心面板进行每日稳定采样、但允许长尾面板轮转的策略,在数据可比性与覆盖广度之间寻求平衡,同时严格将原始爬取内容排除在公开数据集之外,以规避合规风险。
常用场景
经典使用场景
劳动需求指数数据集(Labor Demand Index)为研究者提供了一个聚焦于自动化替代潜力较高的岗位需求的多维面板数据。其经典用途在于融合美国劳工统计局(BLS)的官方职位空缺与劳动力流动调查(JOLTS)数据,以及从公开网络聚合的岗位发布采样数据,从而构建一个既能反映宏观劳动力市场紧缩程度,又能揭示微观岗位招聘持续时间的综合指标体系。研究人员可以借助该数据集追踪特定角色族群的招聘需求强度、岗位空缺的存续时长以及离职与招聘之间的动态关系,尤其适用于那些对自动化敏感、招聘周期长期高企的职能领域。
实际应用
在实际应用层面,该数据集为政策制定者、企业人力资源部门以及经济预测机构提供了多维度、可操作的决策支持工具。政策制定者可以利用其中日频更新的岗位发布信号,洞察特定行业或地区的招聘活力,从而在官方数据发布前对就业市场走势做出前瞻性判断。企业可借助角色族群层面的薪资锚点(OEWS工资数据)与招聘周期指标(如保留30天以上的岗位比例),优化其招聘策略与薪酬设计。对于金融机构和宏观经济预测团队而言,基于该数据集的日度工作流纹理信息(如软件与合规性术语出现频率)可作为评估特定行业数字化、规范化压力乃至劳动力成本变动的前瞻性代理变量。
衍生相关工作
该数据集的构建理念和发布结构已经催生了一系列开创性的研究工作。在方法论层面,‘招聘压力指数’的多源融合框架启发了后续将官方统计数据与非结构化网络信息相结合的混合建模思路,例如结合JOLTS修订历史与实时发布采样进行月度数据临近预报(Nowcasting)的学术尝试。在应用研究领域,该数据集支撑了关于‘自动化适应性岗位’匹配效率的实证分析,研究者得以区分因技能短缺导致的‘自然招聘困难’与因自动化替代意愿驱动的‘策略性空缺维持’。此外,基于其标准化的角色分类体系(Role Taxonomy)与行业桥接表(Occupation Bridge),跨学科团队已开始探索岗位发布文本中暗含的合规成本与工作流软件采纳速度对区域劳动力市场结构演变的驱动效应。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

