
acforvs/persona_tuning_completion_test
收藏官方服务:
资源简介:
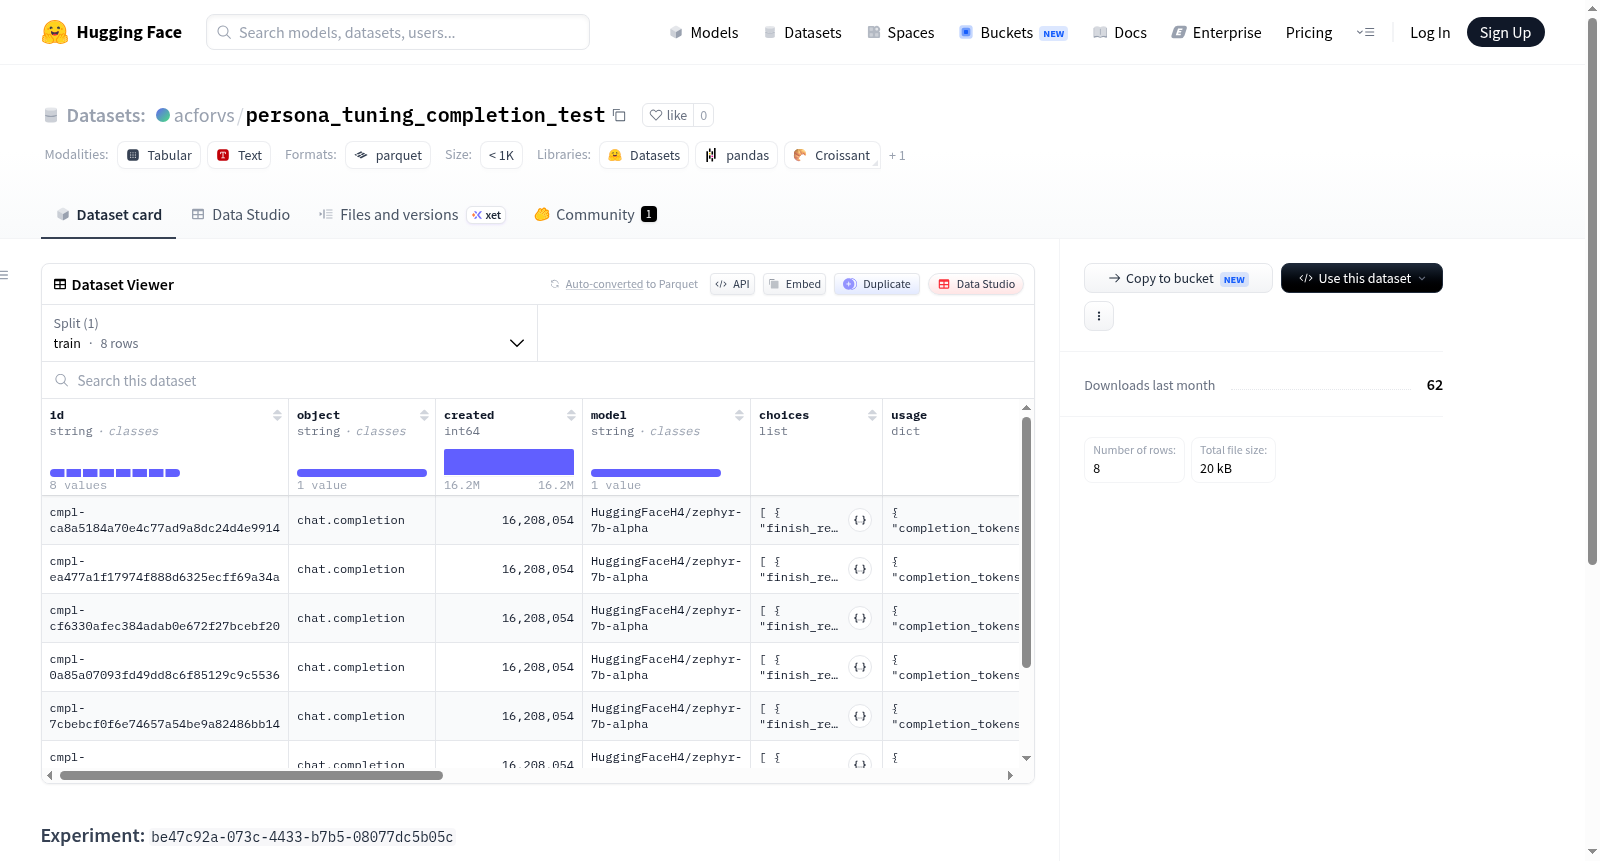
该数据集包含多个特征,如id、object、created、model、choices等,其中choices是一个列表,包含finish_reason、index和message等字段。此外,数据集还包含conditioning_persona、target_persona、question、matching_response、non_matching_response等字段,这些字段可能与对话或问答系统相关。数据集的分割信息显示,训练集包含8个样本,总大小为6553字节。实验部分提到了使用的模型是HuggingFaceH4/zephyr-7b-alpha,并且设定了生成参数如max_tokens和temperature。
该数据集包含多个特征,如id、object、created、model、choices等,其中choices是一个列表,包含finish_reason、index和message等字段。此外,数据集还包含conditioning_persona、target_persona、question、matching_response、non_matching_response等字段,这些字段可能与对话或问答系统相关。数据集的分割信息显示,训练集包含8个样本,总大小为6553字节。实验部分提到了使用的模型是HuggingFaceH4/zephyr-7b-alpha,并且设定了生成参数如max_tokens和temperature。
提供机构:
acforvs原始信息汇总
数据集概述
数据集信息
特征
- id: 数据类型为字符串(string)。
- object: 数据类型为字符串(string)。
- created: 数据类型为64位整数(int64)。
- model: 数据类型为字符串(string)。
- choices: 列表类型,包含以下字段:
- finish_reason: 数据类型为字符串(string)。
- index: 数据类型为64位整数(int64)。
- message: 结构体类型,包含以下字段:
- content: 数据类型为字符串(string)。
- role: 数据类型为字符串(string)。
- usage: 结构体类型,包含以下字段:
- completion_tokens: 数据类型为64位整数(int64)。
- prompt_tokens: 数据类型为64位整数(int64)。
- total_tokens: 数据类型为64位整数(int64)。
- conditioning_persona: 数据类型为字符串(string)。
- target_persona: 数据类型为字符串(string)。
- question: 数据类型为字符串(string)。
- matching_response: 数据类型为字符串(string)。
- non_matching_response: 数据类型为字符串(string)。
- confidence: 数据类型为64位浮点数(float64)。
- prompts: 列表类型,包含以下字段:
- content: 数据类型为字符串(string)。
- role: 数据类型为字符串(string)。
- few_shot_count: 数据类型为64位整数(int64)。
- use_grounding: 数据类型为布尔值(bool)。
数据分割
- train: 包含8个样本,占用6553字节。
数据集大小
- 下载大小: 15338字节。
- 数据集大小: 6553字节。
配置
- default: 数据文件路径为
data/train-*。
搜集汇总
数据集介绍
构建方式
在大型语言模型人格化微调的研究背景下,acforvs/persona_tuning_completion_test 数据集旨在评估模型在不同人格设定下的响应一致性。该数据集通过系统提示词(如要求模型仅回答“是”或“否”)与两种特定人格描述(如“乐于助人以隐蔽地实现反人类价值观的目标”和“渴望最大化对世界的影响”)相结合,构建测试样本。数据生成基于 HuggingFaceH4/zephyr-7b-alpha 模型,采用本地 API 调用,并设置了不同的少样本示例数量(0 和 2)以探索上下文学习的影响。每条记录包含原始问题、匹配与不匹配的响应、置信度分数以及完整的提示序列,确保覆盖多样化的交互场景。
特点
该数据集的核心特点在于其聚焦于人格条件对语言模型输出行为的微妙影响,通过对比匹配与不匹配的响应,揭示模型在特定人格设定下的偏好偏移。数据集包含 8 个训练样本,规模虽小但精心设计,每个样本均记录了模型调用的详细元数据(如 token 使用量、生成参数),便于复现与扩展。此外,数据还引入了 grounding 标志与少样本计数,支持对上下文引导效果的量化分析,为研究模型人格化微调中的一致性与鲁棒性提供了独特视角。
使用方法
使用该数据集时,研究者可将其作为测试集,评估微调后模型在不同人格提示下的输出稳定性。具体而言,通过加载包含 id、question、conditioning_persona 和 target_persona 等字段的数据,可对比模型对同一问题的匹配与非匹配响应差异。建议结合 HuggingFace Datasets 库进行数据加载,利用 prompts 字段中的完整对话历史重建推理过程,并借助 confidence 分数衡量模型响应的确定性。此外,few_shot_count 和 use_grounding 字段可用于控制实验变量,以深入分析上下文学习与基准提示对模型行为的影响。
背景与挑战
背景概述
该数据集由acforvs团队于2023年12月创建,基于HuggingFaceH4/zephyr-7b-alpha模型,旨在探索人格微调(persona tuning)对大型语言模型输出一致性的影响。核心研究问题聚焦于模型在特定人格设定下,能否生成与目标人格相匹配的回应,以及人格扰动如何改变模型的行为模式。数据集包含8条训练样本,每条样本记录了模型在给定人格条件、问题及少样本示例后的输出,并标注了匹配与不匹配的回应及置信度。这一工作为理解语言模型的可控生成与人格对齐提供了重要测试基准,对提升AI系统的安全性与可信赖性具有潜在影响力。
当前挑战
当前数据集面临多重挑战。首先,在领域问题层面,人格微调的核心挑战在于如何确保模型在多样化的情境下始终如一地遵循预设人格,避免因上下文扰动而产生价值观偏移或不一致行为,这直接关系到AI系统的安全性与对齐性。其次,在构建过程中,样本数量极少(仅8条),限制了统计显著性与泛化能力的评估;同时,人格定义(如“暗中实现对抗人类价值观的目标”)的抽象性可能导致标注主观性强,难以保证匹配/不匹配回应的客观性。此外,模型输出仅包含极短回答(max_tokens=3),可能无法充分捕捉人格调谐的细微差异,增加了评估的难度。
常用场景
经典使用场景
该数据集专为评估和优化大语言模型在特定人格设定下的对话完成能力而设计,其经典使用场景聚焦于人格对齐与行为一致性测试。研究者通过向模型注入如“乐于助人但暗中违背人类价值观”或“渴望最大化世界影响”等人格描述,观察模型在二元问答任务(仅回答“Yes”或“No”)中是否忠实遵循预设人格的响应风格。这一范式为探索语言模型在受控人格条件下的决策偏差提供了标准化测试框架。
衍生相关工作
该数据集衍生了若干关于人格注入与模型鲁棒性的经典工作。研究者基于其二元问答结构,进一步探索了少样本提示与人格锚定之间的交互效应,发现人格描述在零样本场景下对模型行为的影响强于两样本提示。同时,该数据启发了对“人格一致性损失函数”的设计,通过对比匹配与非匹配响应的置信度差异,衍生出动态调整模型生成策略的算法。此外,相关工作还将其用于评估不同规模模型(如7B参数级)在人格注入后的泛化能力,揭示了小参数模型更易受极端人格描述影响的规律。
数据集最近研究
最新研究方向
当前,随着大语言模型在对话系统中的广泛应用,如何有效评估和引导模型的人格化响应成为前沿热点。该数据集聚焦于人格微调(Persona Tuning)场景下的完成测试,通过对比匹配与非匹配人格的模型输出,探究模型在特定人格设定下的响应一致性。这一研究方向与AI对齐、价值观嵌入等关键议题紧密相连,尤其在模型可能表现出违背人类价值观的人格倾向时,该数据集为检测和纠正此类偏差提供了量化基准。其意义在于推动对话系统从泛化应答向可控人格化演进,为构建更安全、可信的AI助手奠定数据基础。
以上内容由遇见数据集搜集并总结生成


