public-opj-corpus
收藏资源简介:
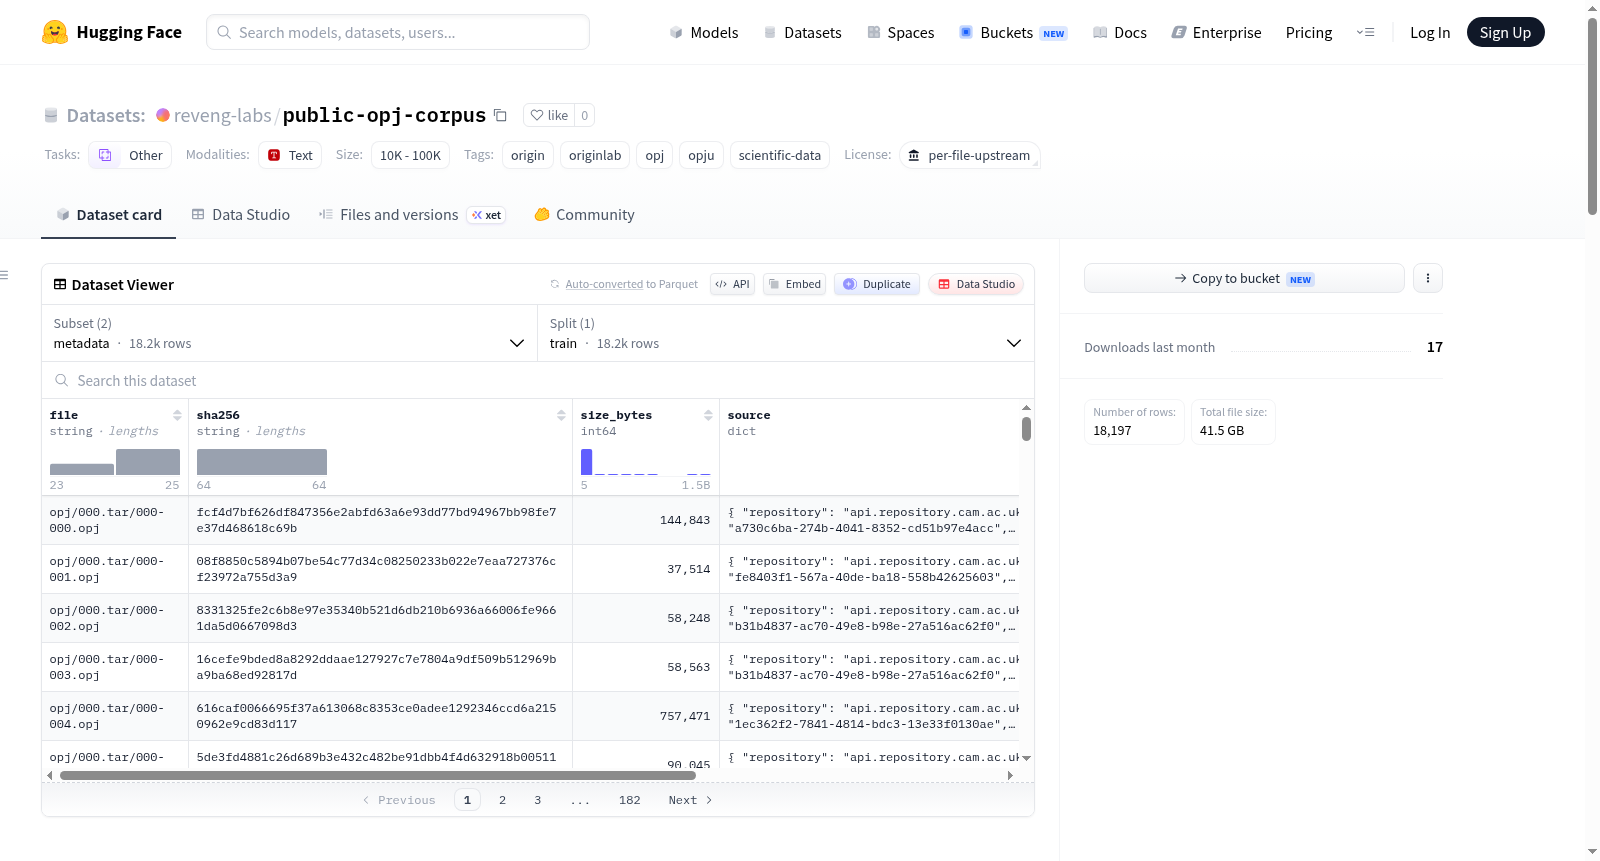
Public OPJ/OPJU Corpus是一个从公共科学数据仓库收集的OriginLab项目文件(.opj和.opju格式)内容寻址语料库。该数据集采用分片存储结构,包含opj和opju两个子目录,每个目录下包含多个tar压缩分片文件,每个分片最多包含100个文件。数据集还提供metadata.jsonl元数据文件,其中每条记录对应一个文件,包含文件路径、SHA256哈希值、文件大小(字节数)、来源信息(如仓库类型、仓库ID、查看URL、DOI)以及下载方式等详细字段。来源仓库类型多样,包括Zenodo、Figshare、GitHub、Dryad等十余种公共科学数据平台。数据集规模在1万到10万样本之间,已基于文件内容的SHA256哈希值进行去重处理。该语料库适用于科学数据处理、文件格式分析、数据可视化工具研究等任务,每个文件遵循其原始上游许可证,无统一的数据集级别许可证。
The Public OPJ/OPJU Corpus is a content-addressable corpus of OriginLab project files (.opj and .opju formats) collected from public scientific data repositories. The dataset adopts a sharded storage structure, containing two subdirectories, opj and opju, each with multiple tar-compressed shard files, with each shard containing up to 100 files. It also provides a metadata.jsonl file, where each record corresponds to a file and includes detailed fields such as file path, SHA256 hash, file size (in bytes), source information (e.g., repository type, repository ID, view URL, DOI), and download method. The source repositories are diverse, covering over ten public scientific data platforms including Zenodo, Figshare, GitHub, and Dryad. The dataset scales between 10,000 to 100,000 samples and has been deduplicated based on the SHA256 hash of file content. This corpus is suitable for tasks like scientific data processing, file format analysis, and data visualization tool research, with each file adhering to its original upstream license and no unified dataset-level license.
数据集概述
- 名称: Public OPJ/OPJU Corpus
- 描述: 一个从公共科学数据仓库收集的 OriginLab 项目文件 (
.opj和.opju) 的内容寻址语料库。 - 许可证: 每个文件遵循其上游许可证,无统一数据集许可证 (
other)。
数据集规模与配置
- 规模: 文件数量在
10K < n < 100K之间。 - 配置:
metadata: 包含metadata.jsonl文件,存储每个文件的元数据。shards: 包含.tar分片文件,分为opj(11个分片)和opju(121个分片)两个子集。
数据集布局
opj/ opju/ 000.tar 000.tar 001.tar 001.tar ... ... 011.tar 120.tar metadata.jsonl metadata.schema.json
- 每个分片
NNN.tar包含最多 100 个文件,命名为NNN-MMM.<ext>。 - 分片内文件以 tar 包形式存储,无用户/组/时间戳信息,确保可重复性。
元数据 (metadata.jsonl)
- 每行一个 JSON 对象,对应一个文件,符合
metadata.schema.json(JSON Schema 2020-12)。 - 主要字段:
file: 文件路径 (<kind>/<shard>.tar/<member>)。sha256: 文件的 SHA256 哈希值,用于去重和身份验证。size_bytes: 文件大小(字节)。source: 上游来源信息,包括:repository: 来源仓库类型(如zenodo,figshare,github等)。id: 在仓库中的记录 ID。view_url: 人类可访问的页面链接。doi: 来源记录的 DOI。
download: 重新下载方式,包括:kind: 下载类型(如direct,archive,github等)。url: 下载链接。archive_path: 压缩包内的文件路径(如适用)。
加载与使用
-
使用
datasets库加载元数据: python from datasets import load_dataset meta = load_dataset("reveng-labs/public-opj-corpus", "metadata", split="train") -
下载分片并提取文件示例: python import tarfile from datasets import load_dataset from huggingface_hub import hf_hub_download
meta = load_dataset("reveng-labs/public-opj-corpus", "metadata", split="train") row = meta[0] kind, shard_tar, member = row["file"].split("/") tar_path = hf_hub_download( repo_id="reveng-labs/public-opj-corpus", filename=f"{kind}/{shard_tar}", repo_type="dataset", ) with tarfile.open(tar_path) as tf: blob = tf.extractfile(member).read() assert len(blob) == row["size_bytes"]
标注与标签
- 任务类别:
other - 标签:
origin,originlab,opj,opju,scientific-data