遇见数据集

whiskydb-fine-spirits-sample

收藏
Hugging Face2026-07-11 更新2026-07-12 收录
官方服务:

资源简介:

WhiskyDB — Fine Spirits & Whisky Dataset (Free Sample) 是一个结构化、关系型的威士忌和优质烈酒数据集免费样本,完全基于公开、合法可访问的公共来源构建,包括政府标签注册(美国TTB COLA)、公司注册(英国公司注册处)、欧盟eAmbrosia地理标志注册、Open Food Facts、Wikipedia/Wikidata以及公开拍卖统计数据,每条记录都有可追溯的来源记录。该样本包含15种烈酒和15家酒厂,以及完整的木桶和风味分类法(14种木桶风格和15种风味描述符)。完整数据集覆盖1290多种烈酒、3200多家酒厂和生产者,遍布110多个国家,包含270多个受保护的地理标志名称,以及20000多个月度拍卖价格基准(自2005年11月至今)。数据集适用于酒吧菜单和酒店软件、收藏跟踪和烈酒发现应用、基于19年月度拍卖指数的威士忌投资分析、基于风味/木桶的推荐引擎,以及机器学习/检索增强生成知识库。样本数据采用CC BY-NC 4.0许可证,分类法采用CC BY 4.0许可证。

创建时间:
2026-07-08
原始信息汇总

数据集概览

  • 名称: WhiskyDB — Fine Spirits & Whisky Dataset (Free Sample)
  • 许可证: 样本数据采用 CC BY-NC 4.0(署名-非商业性使用);分类法(casks_taxonomy.csv 和 flavors_taxonomy.csv)采用 CC BY 4.0(署名,允许商业使用)。
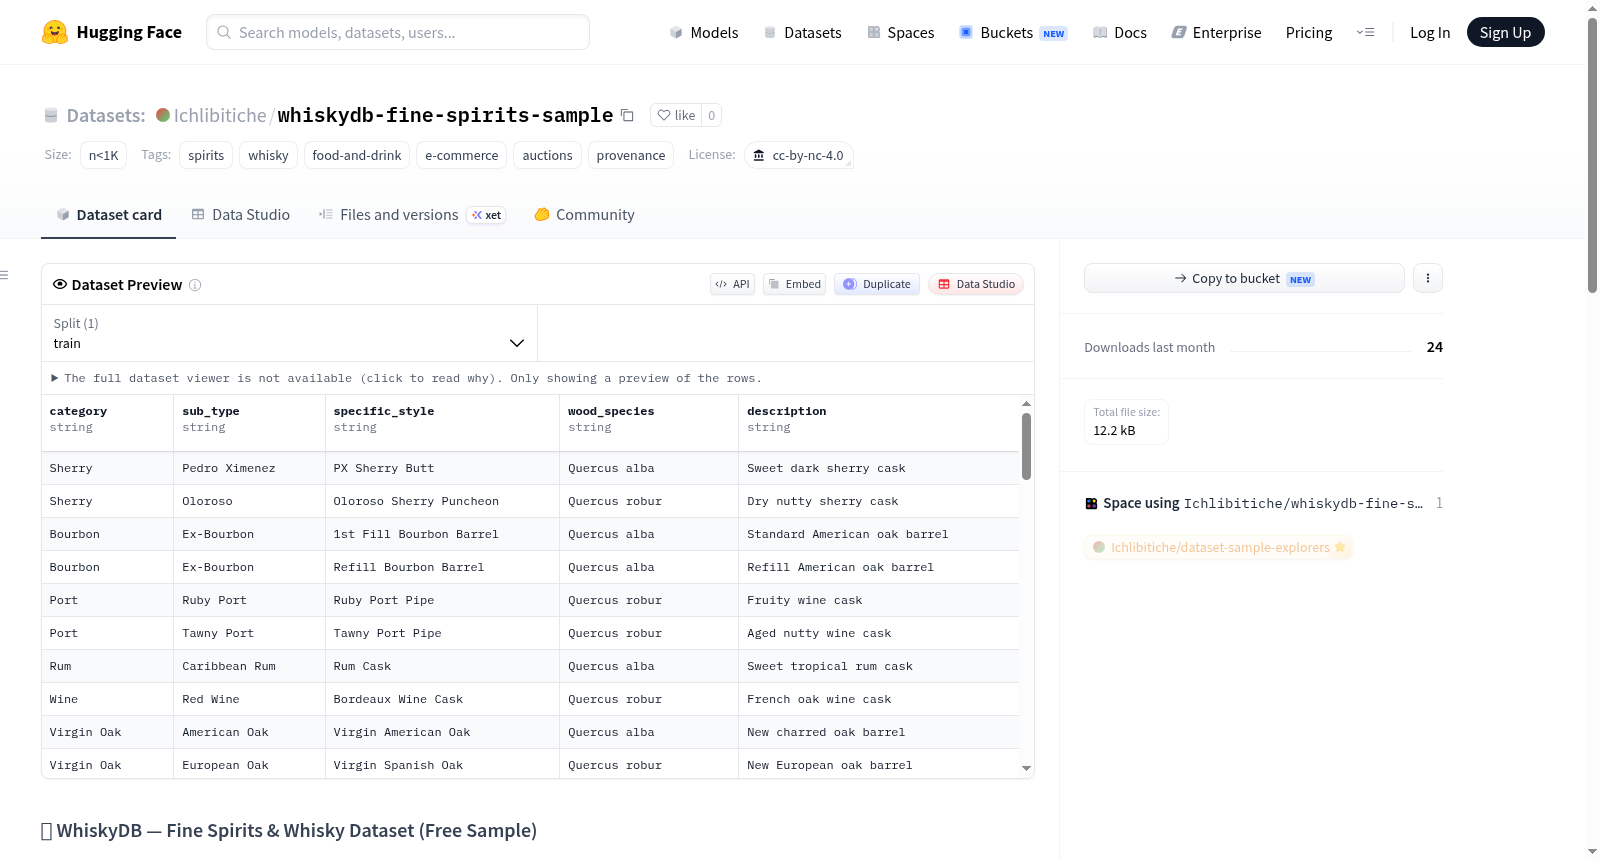
  • 样本规模: 15 款烈酒 + 15 家蒸馏厂,并包含完整的桶型与风味分类体系(14 种桶型风格、15 种风味描述词)。
  • 完整数据集规模: 涵盖 1,290+ 款烈酒、3,200+ 家蒸馏厂与生产商(分布于 110+ 个国家)、270+ 个受保护地理标志(GI)产区,以及 20,000+ 条月拍卖价格基准数据(2005 年 11 月至今)。

数据来源

数据集完全构建于公开、合法可访问的公共来源,包括:

  • 美国 TTB COLA 政府标签注册局
  • 英国 Companies House 企业注册局
  • 欧盟 eAmbrosia 地理标志注册库
  • Open Food Facts
  • Wikipedia/Wikidata
  • 公开拍卖统计数据
  • 每条记录均附有来源溯源账本条目。

文件内容

文件 许可证 描述
spirits.csv CC BY-NC 4.0 样本瓶装酒信息:名称、类型、年份、酒精度、容量、来源
distilleries.csv CC BY-NC 4.0 样本生产商信息:名称、国家、产区、来源
casks_taxonomy.csv CC BY 4.0 层级化桶型风格(类别 → 子类型 → 风格 + 木材物种),允许任何用途(含商业)
flavors_taxonomy.csv CC BY 4.0 受控风味词汇(宏观类别 → 描述词),允许任何用途(含商业)

快速使用示例

python import pandas as pd

base = "hf://datasets/Ichlibitiche/whiskydb-fine-spirits-sample/" spirits = pd.read_csv(base + "spirits.csv") distilleries = pd.read_csv(base + "distilleries.csv") casks = pd.read_csv(base + "casks_taxonomy.csv") print(len(spirits), "spirits, e.g.", spirits.iloc[0]["name"])

适用场景

  • 酒单管理与酒店行业软件(使用清晰的名称、类型、酒精度、容量数据)
  • 收藏追踪与烈酒发现应用
  • 基于 19 年月度拍卖指数的威士忌投资分析(完整数据集)
  • 基于开放分类法的风味/桶型推荐引擎
  • 基于溯源烈酒知识库的机器学习 / 检索增强生成(RAG)语料

获取完整数据集

搜集汇总
数据集介绍
whiskydb-fine-spirits-sample 数据集图片
构建方式
WhiskyDB — Fine Spirits & Whisky Dataset (Free Sample) 是一个精选的威士忌与烈酒结构化关系型数据集,其构建过程严格遵循开源与合法数据源原则。数据完全来源于美国TTB COLA政府标签注册、英国公司注册处、欧盟eAmbrosia地理标志注册、Open Food Facts、Wikipedia/Wikidata以及公开拍卖统计等渠道。每条记录均附有来源溯源账本,确保数据的透明性与可追溯性。本样本包含15款烈酒、15家酒厂,并提供完整的橡木桶类型与风味分类体系,涵盖14种桶型与15种风味描述符,为后续全量数据集的扩展奠定了坚实基础。
特点
该样本数据集的核心特色在于其高度的结构化与溯源机制,所有记录均通过公开的法律与商业登记源验证,保障了信息的权威性与可靠性。同时,数据集附带了独立的桶型与风味分类体系,采用CC BY 4.0许可协议,支持商业用途的任意拓展。全量数据集则进一步囊括1290余款烈酒、3200多家酒厂及覆盖全球110多个国家的270余个受保护地理标志,并集成自2005年11月至今的225个月度拍卖价格基准,为烈酒估值模型与年份价格研究提供了宝贵的时间序列数据。
使用方法
本数据集的使用方式极为便捷,用户可通过Hugging Face平台直接调用。推荐采用Python的pandas库读取CSV文件,示例代码已提供,仅需指定基础URL即可加载spirits.csv、distilleries.csv等核心表。数据集适用于酒吧菜单与酒店软件系统、收藏追踪应用、威士忌投资分析、基于桶型与风味的推荐引擎,以及利用溯源知识库构建的机器学习与RAG系统。样本数据采用CC BY-NC 4.0许可,分类体系则适用更宽松的CC BY 4.0协议,全量数据需商用许可,且部分上游记录须遵守ODbL/CC-BY-SA的归属要求。
背景与挑战
背景概述
WhiskyDB — Fine Spirits & Whisky Dataset (Free Sample) 是由研究者 Ichlibitiche 于近期构建的一个结构化、关系型数据集,聚焦于威士忌及优质烈酒领域。该数据集完全来源于公开、合法的政府标签注册(如美国TTB COLA)、公司注册(如英国 Companies House)、欧盟 eAmbrosia 地理标志注册、Open Food Facts、维基百科及开放拍卖统计等渠道,为每一条记录附加了来源证明。核心研究问题在于构建一个具备可追溯性和结构化特征的知识库,以支持烈酒行业的数字化应用。该数据集的影响力体现在其提供的完整知识体系上:涵盖1,290余款烈酒、3,200多家酒厂及生产商、270多个受保护地理标志产区,以及自2005年11月以来长达225个月的月度拍卖价格基准,为估值模型、价格与陈年关系研究等提供了坚实数据基础。
当前挑战
该数据集所解决的领域问题包括烈酒行业信息碎片化和标准缺失的挑战,例如威士忌分类、风味描述和橡木桶类型缺乏统一规范,导致跨来源数据整合困难。数据集通过开放的风味和橡木桶分类体系(14种橡木桶风格、15种风味描述符)提供了标准化解决方案。构建过程中面临的挑战包括:从多种开放来源(如政府注册、开放数据库)采集数据时,需应对异构数据格式的解析、实体消歧(如不同来源的酒厂名称映射)以及数据质量验证;同时,为每个记录附加来源证明(provenance ledger)要求记录追溯到原始出处,增加了数据治理的复杂性。此外,商业许可与开放许可的混合使用(如CC BY-NC 4.0与CC BY 4.0的区分)也带来了合规性方面的挑战。
常用场景
经典使用场景
在烈酒与威士忌研究的学术领域中,WhiskyDB — Fine Spirits & Whisky Dataset为其提供了一座结构清晰、来源可溯的数据金矿。该数据集的经典使用场景聚焦于构建风味与橡木桶类型的推荐引擎,利用其开源的casks_taxonomy与flavors_taxonomy层级分类体系,研究者能够精准映射威士忌的味觉特征与陈酿工艺之间的潜在关联。同时,该数据集亦广泛应用于烈酒收藏追踪应用的开发,通过规范化记录的酒款名称、酒精度、容量等核心属性,为个人或机构搭建数字化的藏品管理系统奠定了坚实的数据基础。在更宏观的层面,其完整版所涵盖的跨越19年的月度拍卖价格基准,已成为威士忌投资分析领域中评估酒款价值波动与年份效应的关键数据支柱。
衍生相关工作
围绕WhiskyDB数据集,学术界与工业界已催生出一系列具有深远影响的衍生工作。在数据科学领域,该数据集所附带的经过溯源审查的casks_taxonomy与flavors_taxonomy分类体系,已被独立创作者用于构建面向威士忌品鉴笔记的知识图谱(Knowledge Graph),并作为检索增强生成(Retrieval-Augmented Generation, RAG)系统的语料基础,推动了大语言模型在垂直饮品领域的专业化微调。在金融研究方面,研究者利用其拍卖指数序列,发表了关于威士忌作为替代投资资产在通货膨胀周期中避险功能的实证论文,将非传统资产定价理论拓展至文化消费品的范畴。此外,开源社区基于该数据集的抓取与持久化策略,开发了面向其他农产品(如葡萄酒、精品咖啡)的自动化数据管线的原型框架,间接促进了食品与饮品领域公开数据的系统化建设。
数据集最近研究
最新研究方向
威士忌及烈酒数据集的最新研究方向聚焦于构建基于公开权威来源的结构化多模态知识库,以支撑投资估值模型、风味推荐引擎与RAG(检索增强生成)系统。WhiskyDB通过整合美国TTB COLA政府标签登记、英国公司注册署、欧盟eAmbrosia地理标志登记、Open Food Facts及维基数据等合规来源,并引入长达19年的月度拍卖价格基准(2005年11月至今),开创性地实现了从生产溯源到二级市场价值波动的全链路数据覆盖。该数据集的风味与桶型分类体系采用开放授权(CC BY 4.0),可自由用于商业推荐系统开发。这一前沿范式不仅为烈酒投资分析提供了可复现的定价与陈年效应研究基础,更通过严格的数据溯源链(provenance ledger)解决了食物饮料领域数据集长期面临的真实性争议,推动了从菜单管理、收藏追踪到机器学习语料构建等应用的合规化与标准化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务