遇见数据集

qb-audio

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

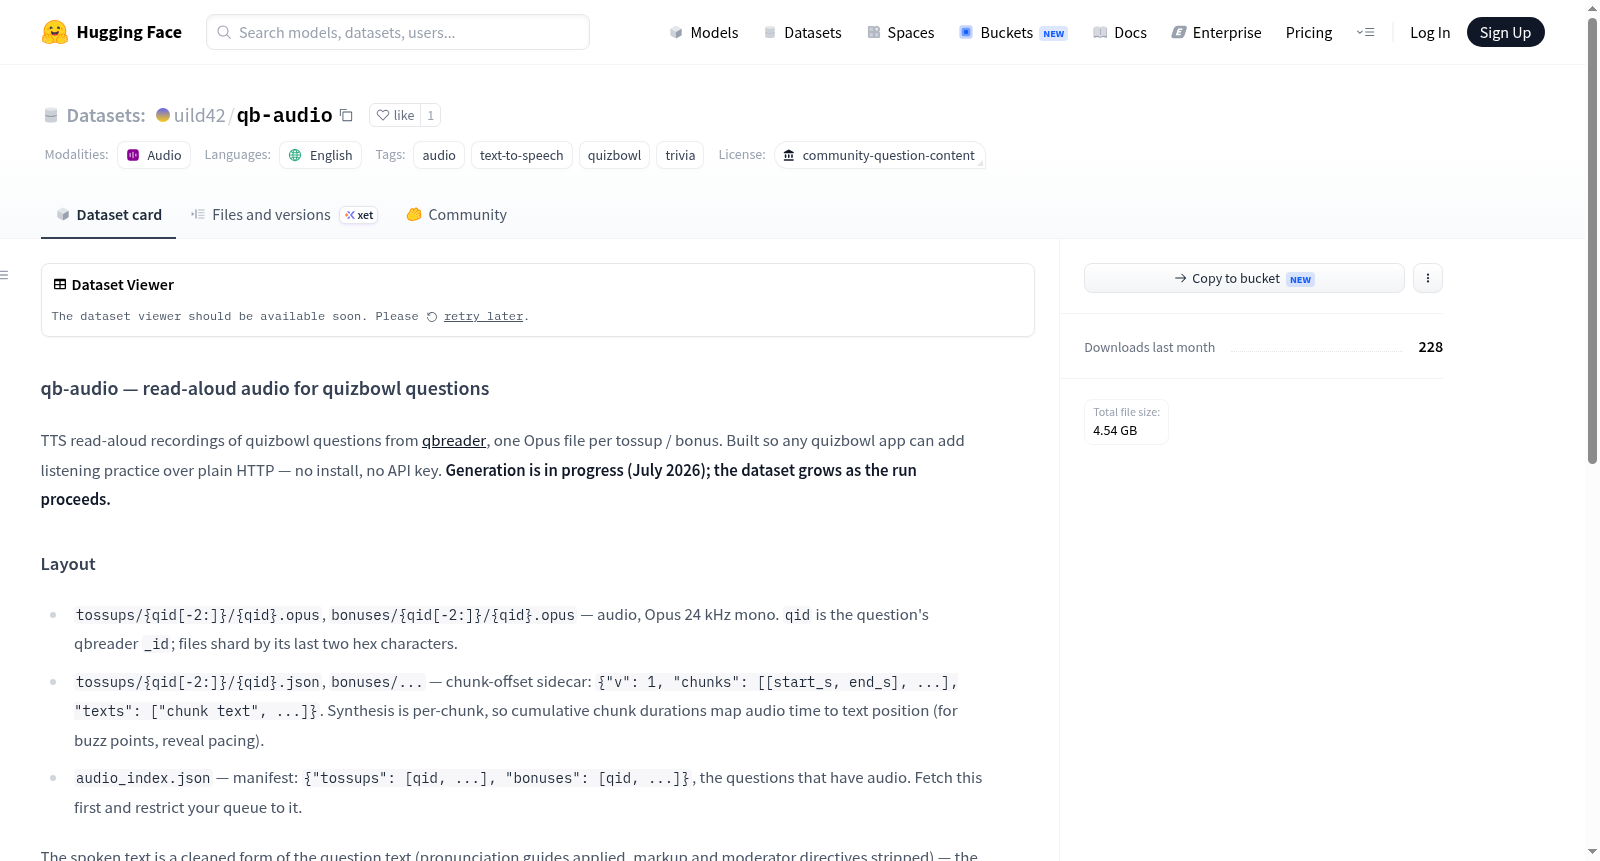
qb-audio是一个为quizbowl(知识竞赛)问题提供的文本转语音(TTS)朗读音频数据集。该数据集基于qbreader平台上的quizbowl题目(包括tossups和bonuses两类),为每个问题生成了对应的音频文件(Opus格式,24 kHz单声道),旨在支持quizbowl应用程序无需安装或API密钥即可集成听力练习功能。数据集采用动态生成方式,规模随时间增长(截至2026年7月仍在持续生成中)。数据组织上,音频文件按问题ID(qid)的最后两位十六进制字符分片存储,并附带JSON侧文件,其中包含音频块的时间戳和对应的文本内容,便于实现音频与文本的同步(如用于答题提示或节奏控制)。此外,数据集提供了audio_index.json清单文件,列出了已生成音频的问题ID列表。音频内容是对原始问题文本进行清理(如应用发音指导、去除标记和主持指令)后的合成朗读。音频合成采用Chatterbox TTS(MIT许可)完成,并经过Whisper ASR(MIT许可)验证以确保质量。数据集适用于quizbowl相关的听力训练、语音应用开发等场景,但请注意,问题文本版权归原作者所有,音频仅为合成朗读,数据集仅限在quizbowl社区规范下的学习和练习使用,无通用开放内容许可。

创建时间:
2026-07-18
原始信息汇总

数据集名称

qb-audio

数据集描述

该数据集包含来自 qbreader 的问答比赛(quizbowl)问题的语音朗读音频,每个问题(tossup / bonus)对应一个 Opus 格式的音频文件。数据集旨在为问答比赛应用提供无需安装或 API 密钥的听力练习功能。生成工作正在进行中(截至 2026 年 7 月),数据集会随运行过程不断增长。

数据布局

  • 音频文件:位于 tossups/{qid[-2:]}/{qid}.opusbonuses/{qid[-2:]}/{qid}.opus,Opus 格式,24 kHz 单声道。文件名中的 qid 为问题的 qbreader _id,文件根据其最后两个十六进制字符分片存储。
  • 辅助文件:位于 tossups/{qid[-2:]}/{qid}.jsonbonuses/...,JSON 格式,包含时间戳偏移信息:
    • 字段 v:版本号,当前为 1。
    • 字段 chunks:每个语音片段的起止时间(秒),格式为 [[start_s, end_s], ...]
    • 字段 texts:每个语音片段对应的文本字符串列表。
  • 清单文件:位于根目录的 audio_index.json,格式为 {"tossups": [qid, ...], "bonuses": [qid, ...]},列出已生成音频的所有问题 ID。使用时应先获取该清单,并仅对其中的问题进行请求。

语音内容说明

口语文本为问题文本的清洗版本(已应用发音指南,去除了标记和主持人指令),辅助文件中的 texts 字段即与音频实际朗读内容完全一致。

数据集构建方法

  • 使用 Chatterbox TTS(MIT 许可证,由 Resemble AI 开发)进行语音合成,运行于单张 RTX 4090 显卡。
  • 采用 ASR 验证机制(使用 OpenAI Whisper,MIT 许可证),对生成结果进行质量检查,重新生成剪辑或失控的音频片段。
  • 流水线代码已开源,位于 qbsuite 组织下(MIT 许可证)。

许可与致谢

  • 问题文本:由各锦标赛的包作者和编辑撰写,通过 qbreader 分发,该平台共享社区问题存档。音频为这些文本的合成朗读,原始问题的权利归其作者所有。
  • 数据集许可:数据集依据问答比赛社区规范共享,仅用于学习和练习目的,不适用于其他用途(许可证标签为 other,无通用的开放内容许可)。
  • 语音合成来源:Chatterbox TTS(MIT © Resemble AI),质量审核:Whisper(MIT © OpenAI)。
  • 删除请求:如果您是所收录问题的作者或编辑,并希望移除相关内容,请在 qbsuite 任一仓库提交 issue,或使用数据集的社区选项卡,内容将被及时删除。

标签与语言

  • 语言:英语(en)
  • 标签:audio, text-to-speech, quizbowl, trivia
  • 许可证:other(具体条款见社区规范链接 https://www.qbreader.org/
搜集汇总
数据集介绍
qb-audio 数据集图片
构建方式
本数据集基于qbreader平台上的问答题目文本,借助Chatterbox TTS语音合成系统,在单块RTX 4090显卡上逐段落生成音频。每个音频文件对应一道抢答题或奖励题,采用Opus编码格式,采样率为24kHz单声道。合成过程中,系统以题目文本的清洗版本为输入,去除标记与主持指令,并应用发音指导,确保朗读内容与侧边栏文本完全一致。每段音频均附有JSON格式的侧边文件,记录各片段起止时间及对应文本,便于精准定位。为保障质量,引入了OpenAI Whisper自动语音识别验证门控,对截断或异常生成进行重新合成。整个流水线代码以MIT许可证开源,能够支持持续增量生产,目前生成工作仍在推进中。
特点
该数据集的核心特色在于将音频与文本位置建立了精确映射,每个题目音频均附带时间戳与文本片段对应关系,可用于模拟抢答时机或逐段揭示答案等交互场景。数据采用轻量级目录结构,通过题目ID的最后两位十六进制字符进行分片存储,便于大规模高效索引。同时提供了一个全局清单文件audio_index.json,列出所有已完成合成的题目ID,使得应用程序在无API密钥的条件下,通过普通HTTP即可获取音频,大幅降低了接入门槛。音频文本经过精心清洗,去除了原文中的格式标记和主持人指令,保持了口语化朗读的自然度。合成与验证的双重机制保证了音频的高准确度与可用性。
使用方法
使用者可首选获取audio_index.json文件,据此建立待播放题目队列,避免访问未生成音频的题目。随后依据题目ID的后两位字符定位到相应目录,分别从tossups或bonuses子目录中获取Opus音频文件及同名的JSON侧边文件。侧边文件中的chunks字段提供了音频片段的时间区间,texts字段则对应了每一片段的朗读文本,可用于实现逐段播放、同步高亮显示或抢答计时等交互功能。所有音频通过标准HTTP协议访问,无需安装额外库或注册API密钥,适合嵌入各类问答练习应用。由于数据集仍在持续生成中,建议定期重新拉取index文件以更新可用的音频列表。
背景与挑战
背景概述
qb-audio数据集诞生于2025年7月,由qbsuite团队基于Quizbowl社区问答平台qbreader构建,旨在为文本转语音(TTS)驱动的问答练习场景提供高质量的音频资源。Quizbowl是一种知识竞赛形式,参与者需通过聆听题目文本迅速抢答,而此前缺乏统一、可访问的音频数据集以满足学习与练习需求。该数据集通过Chatterbox TTS引擎在单张RTX 4090上合成音频,并引入Whisper ASR验证门控机制确保生成质量,其侧边文件精确映射音频时长与文本位置,为自动出题、节奏控制等下游应用提供了坚实基础。作为首个大规模、开源可用的Quizbowl语音数据集,qb-audio显著推动了语音辅助学习与竞赛训练领域的发展,其影响力延伸至教育技术、人机交互和语音合成评估等方向。
当前挑战
该数据集面临的核心挑战之一在于所解决的领域问题:如何为Quizbowl这种依赖快速听题与抢答的竞赛形式,生成自然、准确且时序可控的合成语音,以替代人工朗读并实现可扩展的练习系统。构建过程中,技术挑战尤为突出:首先,合成语音需在单个RTX 4090上高效生成,且要处理大量题目文本(含经清理的发音指导与标记去除),对TTS模型的鲁棒性与速度提出高要求;其次,采用ASR门控机制自动检测并重试剪辑或失控生成,增加了管线复杂度与计算开销;此外,数据集尚在持续生成(预计至2026年7月),如何确保增量更新与已有音频的语义一致性,以及维护因题目版权导致的合法使用边界,均为数据集的长期维护与社区采纳增添了实际困难。
常用场景
经典使用场景
qb-audio数据集专为文本到语音(TTS)在特定问答领域的应用而设计。其核心使用场景是为知识竞赛(Quizbowl)问题提供高质量的朗读音频,涵盖抢答题(tossup)和加分题(bonus)两种类型。每个音频文件以Opus格式存储,并附带详细的文本分块偏移信息,使得音频时间与文本位置精确对齐。这一特性使得该数据集成为开发Quizbowl辅助学习工具的理想选择,尤其是需要同步听力与文本理解的场景,例如自动出题系统、在线练习平台以及移动端学习应用。通过直接提供HTTP可访问的音频流,该数据集极大简化了开发流程,无需额外安装或API密钥,即可在任何Quizbowl应用中集成听力实践功能,从而提升学习者的内容掌握效率。
解决学术问题
该数据集有效解决了学术研究中知识问答音频资源的稀缺问题。传统Quizbowl训练多依赖文本阅读,而听力理解作为重要的认知维度,却因缺乏大规模、标准化的朗读语料库而难以被系统研究。qb-audio通过TTS合成技术生成了数千道题目的朗读音频,并采用ASR验证门控确保生成质量,从而为语音技术、教育心理学和认知科学领域提供了可复用的实验基准。研究者可借此探讨听力学与知识检索的交互机制,例如音频文本对齐对反应时间的影响,或不同合成语音对理解准确率的干扰因素。此外,其开放可扩展的架构鼓励社区持续贡献,填补了特定领域音频数据集空白,推动了跨模态学习研究的发展。
衍生相关工作
该数据集的发布催生了一系列衍生工作,尤其在语音合成与教育技术的交叉领域。基于其开放的合成管道(如Chatterbox TTS与Whisper验证),研究者可复现并改进低资源领域TTS系统的质量评估框架,例如针对长文本分块合成的韵律连贯性问题。部分工作探索了多说话人风格迁移,利用相同管道生成不同口音或语速的音频,以研究学习者适应性。此外,音频文本对齐的侧车数据为自然语言处理任务提供了新基准,如文档级声学建模和停顿预测。社区基于该数据集开发的实时发音评测工具,进一步被扩展至其他知识问答游戏。这些衍生项目不仅验证了qb-audio的基础设施价值,也凸显了其作为可生长数据集的潜力,持续推动学术与实用协同演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务