Emotion-tagged TTS Dataset
收藏资源简介:
该数据集包含带有情感标签的文本-语音对,用于TTS训练。每条记录包括说话者、转录文本(保留填充词)和对应的语音片段,并附带情感标签(如笑声、叹息、停顿、耳语、语调等)。
This dataset contains text-speech pairs annotated with emotion labels, specifically designed for Text-to-Speech (TTS) model training. Each record encompasses the speaker identity, transcribed text with filler words retained, corresponding speech segments, and associated emotion labels including laughter, sigh, pause, whisper, intonation, and so forth.
项目概述
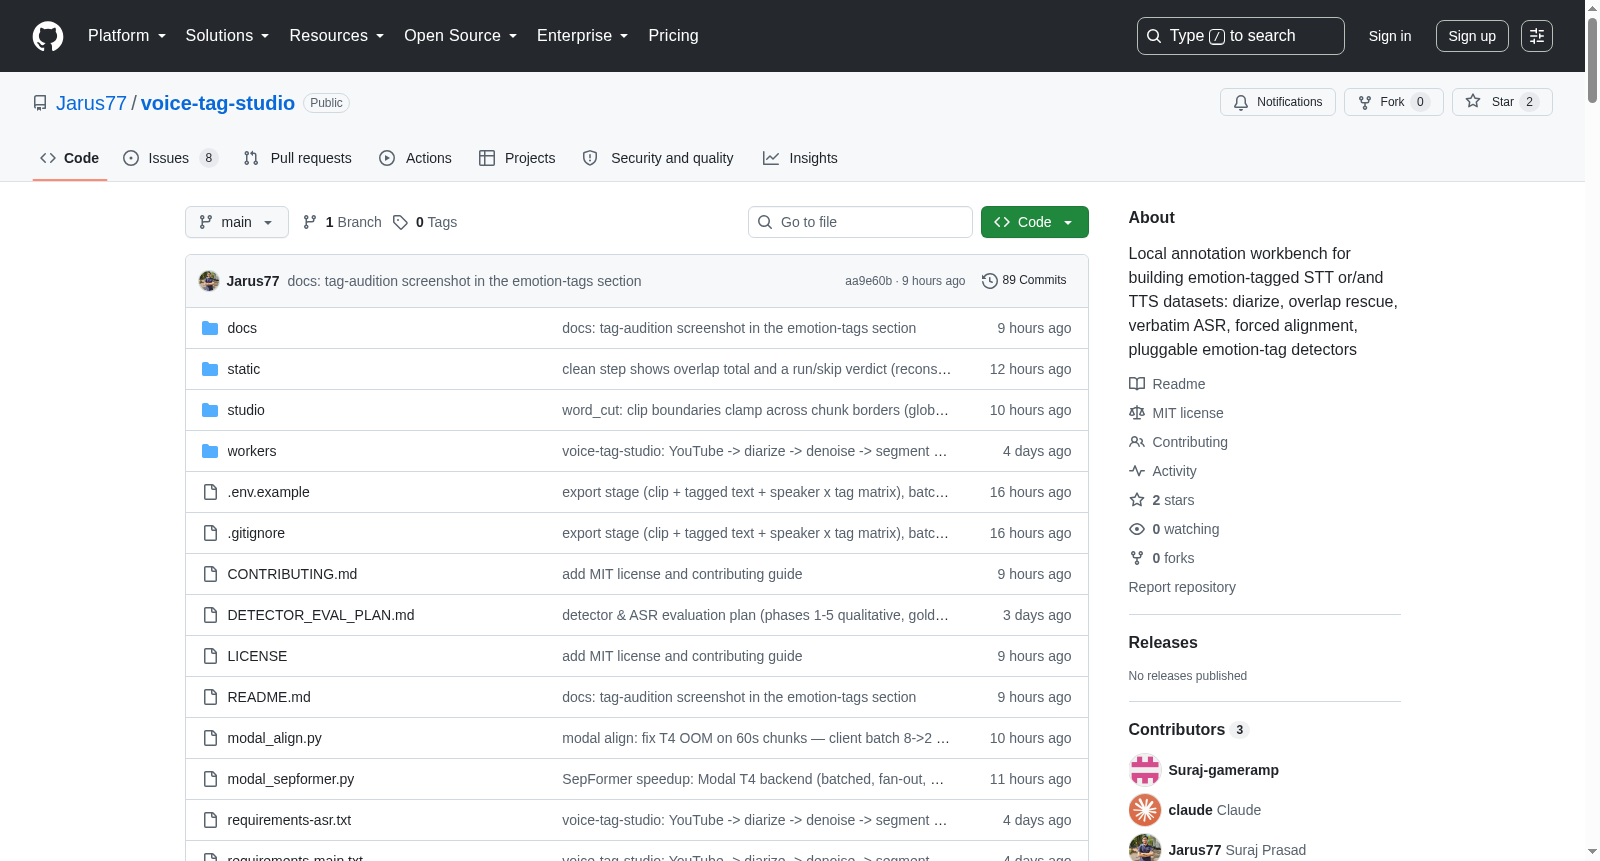
voice-tag-studio 是一个本地数据标注工作台,用于从 Hindi/Hinglish 音频(包括播客、通话、YouTube 视频等)构建带情感标签的 TTS 数据集。它接受音频输入,生成带标签的训练数据行,每行包含说话人标签、带填充词(如 hesitates、pauses)的转录文本,以及对应的语音片段。用户可通过浏览器查看和审听每个处理步骤,也可以对文件夹进行无头批处理。
处理流水线
处理流程按照固定顺序分阶段执行,每个阶段由用户手动点击触发,以便在进入下一步之前检查输出:
- ingest(摄取):接受 YouTube URL 或上传文件,生成原始存档和 16 kHz 工作音频(使用 yt-dlp 和 ffmpeg)。
- diarize(说话人分离):识别谁在何时说话,使用
pyannote/speaker-diarization-community-1模型(MPS 加速)。 - clean(可选清理):使用 SepFormer 模型和 ECAPA 纯净度门控,挽救重叠语音而非丢弃。
- asr(语音识别):对每个说话人通道进行逐字转录(约 60 秒分段),保留填充词,使用 Gemini 2.5 Flash 或可选的 srota 引擎。
- align(对齐):在说话人通道上生成词级时间戳,识别未对齐的语音片段,使用 torchaudio
MMS_FA和 uroman。 - segment(切分):仅在经过验证的词间间隙处切出 1–20 秒的片段;片段文本由其中的对齐词派生。独白窗口从原始录音中切出(保持连续的环境音、无处理伪影)。
- detectors(检测器):生成情感标签候选(见下文)。
- export(导出):生成
dataset.jsonl,包含片段、标记文本和说话人 × 标签矩阵。
系统还提供"Run remaining ▸"一键顺序执行所有待完成阶段。转录在切分之前完成,词位置在切分前已知,从而保证文本与音频的对应关系在结构上成立。
情感标签体系
标签分为五类,对应不同的检测器:
| 家族 | 标签 | 检测器 |
|---|---|---|
| 反应 | [laughs] [sigh] [gasps] |
PANNs CNN14 声音事件检测(AudioSet) |
| 节拍 | [pauses] [silence] [hesitates] [stammers] |
基于强制对齐的规则,确定性且免费;[pauses](0.5–1.5 秒间隙)和 [silence](≥1.5 秒)在导出时自动生成 |
| 发声强度 | [whispers] |
浊音帧比例(物理量,与语言无关) |
| 语气 | [flatly] [cheerfully] |
每说话人音高百分位数 |
| 状态 | [excited] [nervous] [frustrated] [sorrowful] [calm] |
audeering wav2vec2 唤醒度/效价,按说话人的百分位数 |
位置型标签(反应、节拍)在发生时刻内联渲染;话语级标签(语气、发声强度、状态)渲染在行首。系统明确指出这些是候选而非最终标签,可靠性随表中位置下降:节拍是确定性时间计算,状态使用英文训练的模型处理印地语,被视为弱证据。阈值位于 studio/config.py::TAG_THRESHOLDS,可在 UI 中试听调整。检测器按分数排序输出候选,每次点击可试听该时刻前后 2 秒。
输出格式
dataset.jsonl,每个片段一行,示例行包含:
json { "sample_id": "EOKZrphv3QI_SPEAKER_01_0007", "speaker": "SPEAKER_01", "line": "SPEAKER_01: जो पिघले न [hesitates] देखा जाए तो [pauses] पर आप तो...", "text": "जो पिघले न [hesitates] देखा जाए तो [pauses] पर आप तो...", "text_plain": "जो पिघले न देखा जाए तो पर आप तो...", "tags": ["hesitates", "pauses"], "wav": "segments/SPEAKER_01/EOKZrphv3QI_SPEAKER_01_0007.wav", "dur": 17.9, "split": "train", "source": "original", "separated_frac": 0.0, "purity": 0.83, "align_status": "filler_suspect", "clipped": [] }
每行携带来源和质量标志(如纯度、对齐状态、裁剪状态),所有中间结果和最终数据保存在按任务组织的 jobs/<job-id>/ 文件夹中。片段为 16 kHz 单声道 PCM_16 格式,原始最佳质量下载始终保留。
数据组织
每个录音对应一个自包含文件夹:
jobs/<job-id>/ ├── master.* 原始最佳质量下载(不被改动) ├── audio/original.wav 16 kHz 工作副本 ├── audio/sam_clean.wav SepFormer 清理通道(如运行了 clean) ├── segments/SPEAKER_XX/*.wav 训练用语音片段 └── manifests/ ├── dataset.jsonl 每个片段一行训练数据的最终交付物 ├── matrix.json 说话人 × 标签计数及丢弃原因 └── *.jsonl 所有中间产物(转录、对齐等)
wav 字段是相对路径,可整体复制。run_batch.py --collect-only --out corpus/ 可将所有已处理任务合并为单一便携数据集。
质量与导出门控
导出门控(studio/config.py::EXPORT_EXCLUDE):文本与音频对应关系损坏或无法验证的片段(无文本、词被从中间切断、SepFormer 重建音频、严重对齐间隙、对齐失败)在 UI 中仍可见,但永远不会成为数据集行。impure(声纹匹配度低于 0.55)会被保留并标记为可疑。系统显示质量标志而不静默丢弃:rescued N%(分离音频占比)、impure 0.54(声纹不匹配)、✂ start/end(词被切断)、deva/lat %(印地语/拉丁字母混合比例)、digits_uncertain(数字导致的对齐不确定)。
使用方式
- 交互模式:
python server.py启动本地服务器(http://127.0.0.1:8765),在浏览器中上传音频或粘贴 YouTube 链接,逐步执行各阶段并试听检查。 - 批处理模式:
python run_batch.py支持单个文件、文件夹或 YouTube 链接,可指定检测器和--clean重叠挽救选项,并支持--collect-only合并输出。
环境要求与加速
需要 Python 3.11+、ffmpeg 和 Hugging Face 账号。ASR 工作器需要独立虚拟环境(因 qwen-asr 与 pyannote 的依赖冲突)。可选用 Modal 部署 GPU 加速模块(SepFormer 清理和对齐),自动检测并回退。实测数据:2 小时印地语播客,在 Apple-Silicon 笔记本 + Modal T4 上,完整流水线约 17 分钟(本地 CPU 需过夜)。
设计原则
- 精确率优先于召回率:错误标签是文本-音频不匹配(幻觉来源);漏标只是未使用的数据。
- 绝不训练双人语音:其他说话人的轮次用防护带减去;重叠秒数从不进入片段。
- 训练用原始录音:独白片段从原始音频中切出,分离和对齐只决定切分位置和文本内容,不处理模型听到的音频。
- 静音必须出现在文本中:片段内词间隙自动转为
[pauses]或[silence]。 - 不信任异常时序:单个对齐词时长超过 2 秒视为对齐故障,其跨度不可用。
- 分离音频只作工作表面:用于 ASR 和对齐,但片段切割绕过重建区域。
- 韵律类指标用每说话人百分位数,不用绝对阈值。
- 按视频切分而非按片段切分,避免同对话数据泄漏。
- 中性行至关重要:说话人需要有未标记行,标签才有意义。