Ayaka/ORCHESTRA-simple-1M
收藏资源简介:
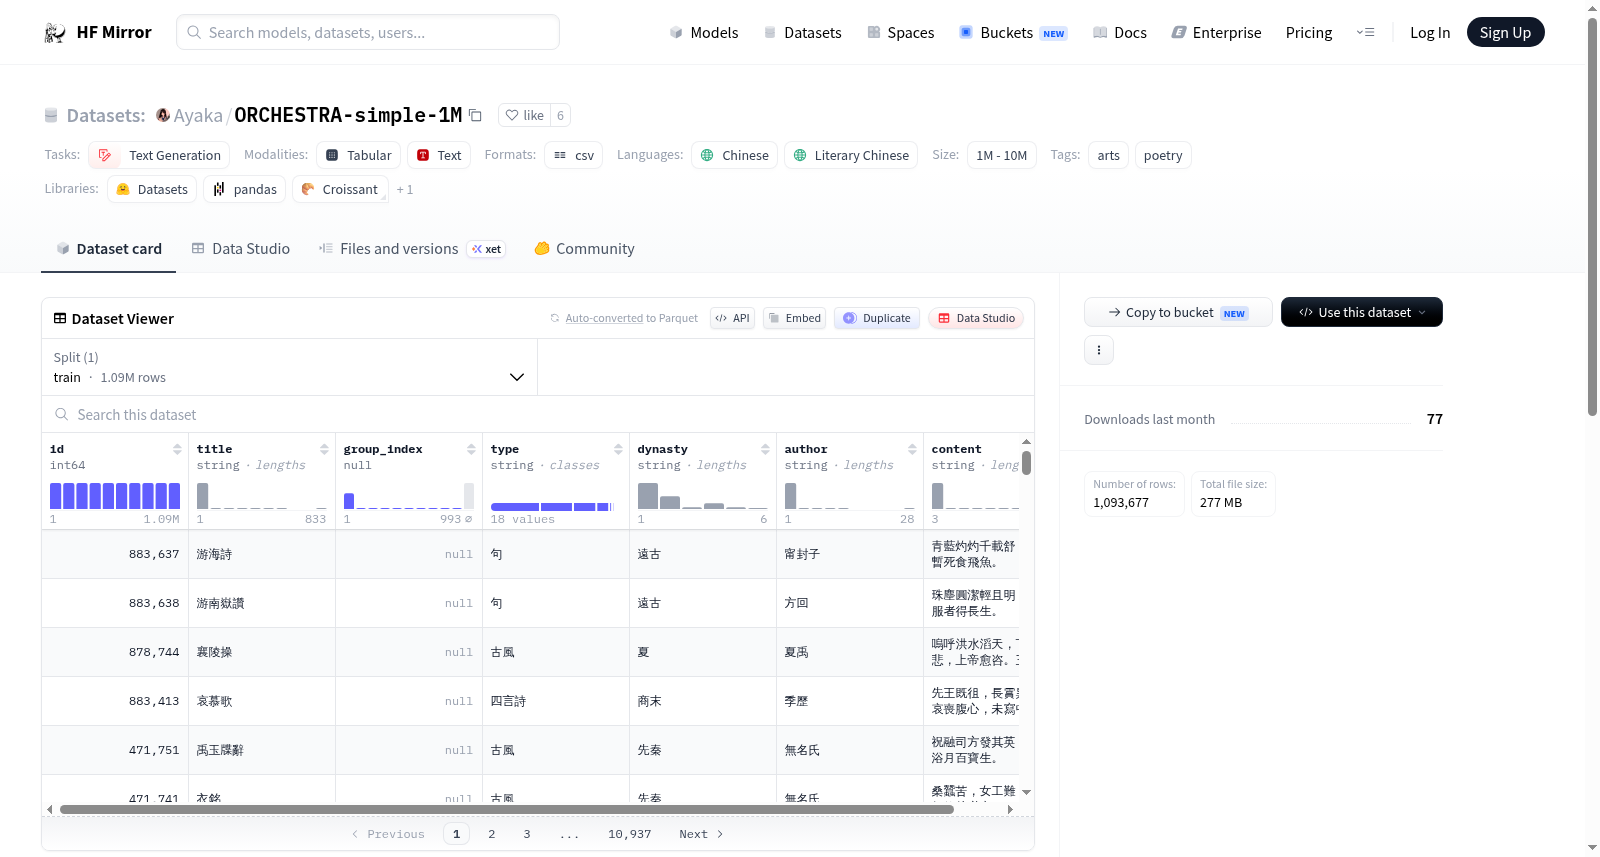
--- task_categories: - text-generation language: - zh - lzh tags: - arts - poetry size_categories: - 1M<n<10M --- # ORCHESTRA-simple-1M GitHub: [nk2028/ORCHESTRA-dataset](https://github.com/nk2028/ORCHESTRA-dataset) **中文簡介** ORCHESTRA (c**O**mp**R**ehensive **C**lassical c**H**in**ES**e poe**TR**y d**A**taset) 是一個全面的古典中文詩歌的數據集,數據來自[搜韻網](https://sou-yun.cn/)。本數據集由 [nk2028](https://nk2028.shn.hk/) 進行格式轉換並發佈,希望透過公開高品質的古典中文詩歌數據,促進對古典中文詩歌及古典中文自然語言處理的研究。 ORCHESTRA-simple 是 ORCHESTRA 數據集的簡化格式,僅保留 `id`, `title`, `group_index`, `type`, `dynasty`, `author`, `content` 這 7 個欄位,而去除其他欄位,以簡化使用。 本資料集可用於大型語言模型的訓練。如欲作其他用途,請向數據提供者[搜韻網](https://sou-yun.cn/)諮詢。 **English Introduction** ORCHESTRA (c**O**mp**R**ehensive **C**lassical c**H**in**ES**e poe**TR**y d**A**taset) is a comprehensive dataset of classical Chinese poetry, with data sourced from [SouYun Website](https://sou-yun.cn/). This dataset was converted and published by [nk2028](https://nk2028.shn.hk/), with the hope that by publicly releasing high-quality classical Chinese poetry data, it can promote research in classical Chinese poetry and natural language processing of classical Chinese. ORCHESTRA-simple is a simplified format of the ORCHESTRA dataset, retaining only 7 fields: `id`, `title`, `group_index`, `type`, `dynasty`, `author`, and `content`, while removing other fields to simplify the usage. This dataset can be used for training large language models. If you wish to use it for other purposes, please consult with the data provider, [SouYun Website](https://sou-yun.cn/).
任务类别:文本生成 语言:中文、文言 标签:艺术、诗歌 数据规模:100万 < 样本量 < 1000万 # ORCHESTRA-simple-1M GitHub 仓库:[nk2028/ORCHESTRA-dataset](https://github.com/nk2028/ORCHESTRA-dataset) ## 中文简介 ORCHESTRA(全称Comprehensive Classical Chinese Poetry Dataset,由各单词首字母组合而成)是一套全面的古典中文诗歌数据集,其数据源自[搜韵网](https://sou-yun.cn/)。本数据集经[nk2028](https://nk2028.shn.hk/)完成格式转换并公开发布,旨在通过开放高质量的古典中文诗歌数据,推动古典中文诗歌研究以及古典中文自然语言处理领域的发展。 ORCHESTRA-simple 是 ORCHESTRA 数据集的简化版本,仅保留`id`、`title`、`group_index`、`type`、`dynasty`、`author`、`content`共7个字段,移除其余冗余字段以简化使用流程。 本数据集可用于大语言模型(Large Language Model, LLM)的训练。若需将其用于其他用途,请向数据提供者[搜韵网](https://sou-yun.cn/)咨询。 ## 英文简介 ORCHESTRA(全称Comprehensive Classical Chinese Poetry Dataset)是一套全面的古典中文诗歌数据集,数据源自[搜韵网](https://sou-yun.cn/)。本数据集由[nk2028](https://nk2028.shn.hk/)完成格式转换并公开发布,希望通过开放高质量的古典中文诗歌数据,推动古典中文诗歌研究与古典中文自然语言处理领域的发展。 ORCHESTRA-simple 是 ORCHESTRA 数据集的简化格式,仅保留`id`、`title`、`group_index`、`type`、`dynasty`、`author`、`content`共7个字段,移除其余字段以简化使用。 本数据集可用于大语言模型的训练。若需将其用于其他用途,请向数据提供者[搜韵网](https://sou-yun.cn/)咨询。
数据集概述
数据集名称
- ORCHESTRA-simple-1M
数据集描述
- ORCHESTRA (cOmpRehensive Classical cHinESe poeTRy dAtaset) 是一个全面的古典中文诗歌数据集,数据来源于搜韵网。
- ORCHESTRA-simple 是 ORCHESTRA 数据集的简化格式,保留了
id,title,group_index,type,dynasty,author,content这7个字段。
数据集用途
- 可用于大型语言模型的训练。
数据集特征
- 语言: 中文, 古文
- 任务类别: 文本生成
- 标签: 艺术, 诗歌
- 大小类别: 1M<n<10M