
koutch/staqc
收藏官方服务:
资源简介:
StaQC(Stack Overflow问题-代码对)是一个包含约148K Python和120K SQL领域问题-代码对的大型数据集,这些对是通过Bi-View Hierarchical Neural Network从Stack Overflow自动挖掘的。数据集分为三个部分:多代码答案帖子、单代码答案帖子和手动注释的多代码答案帖子。每个部分都有对应的配置,可以通过特定的编程语言(Python或SQL)来访问。数据集主要用于自然语言到代码生成的任务。
StaQC(Stack Overflow问题-代码对)是一个包含约148K Python和120K SQL领域问题-代码对的大型数据集,这些对是通过Bi-View Hierarchical Neural Network从Stack Overflow自动挖掘的。数据集分为三个部分:多代码答案帖子、单代码答案帖子和手动注释的多代码答案帖子。每个部分都有对应的配置,可以通过特定的编程语言(Python或SQL)来访问。数据集主要用于自然语言到代码生成的任务。
提供机构:
koutch原始信息汇总
数据集概述
数据集名称
- StaQC (Stack Overflow Question-Code pairs)
数据集内容
- Python和SQL领域的问题-代码对:约148K Python和120K SQL问题-代码对。
- 数据来源:自动从Stack Overflow挖掘,包括多代码答案帖子、单代码答案帖子及手动标注的多代码答案帖子。
数据集配置
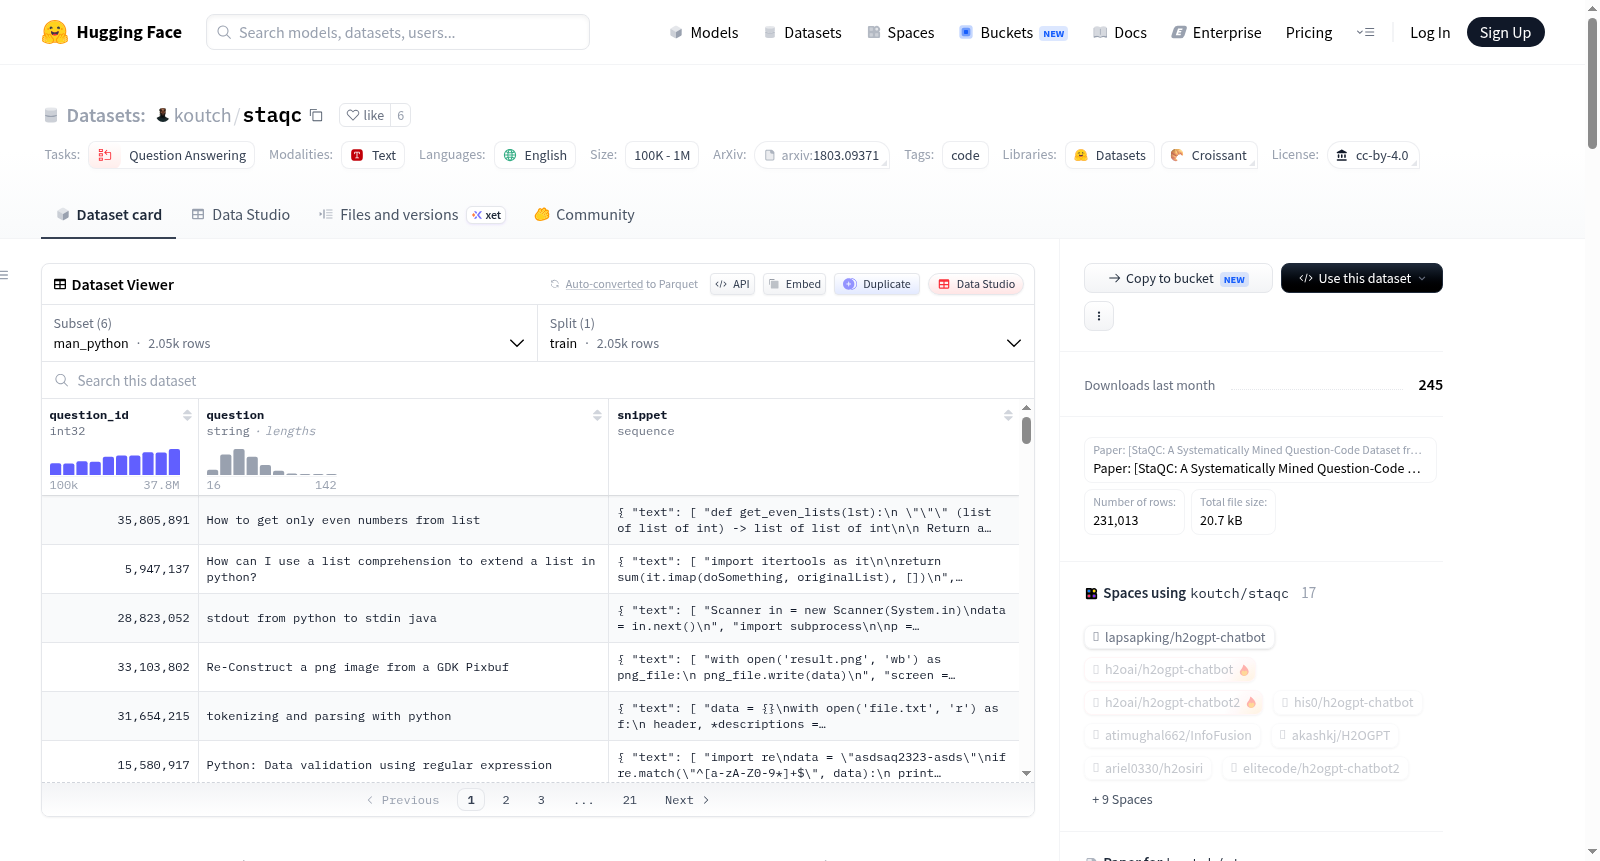
- 配置名称:包括mca_python, mca_sql, sca_python, sca_sql, man_python, man_sql。
- 特征:每个配置包含id, question_id, question, snippet等特征。
- 数据分割:每个配置仅包含训练集。
数据集大小
- 训练集大小:
- mca_python: 40391个例子,23286786字节
- mca_sql: 26052个例子,15164206字节
- sca_python: 85294个例子,39678168字节
- sca_sql: 75637个例子,28656467字节
- man_python: 2052个例子,1445103字节
- man_sql: 1587个例子,1123721字节
数据集使用
- 任务:适用于自然语言到代码生成任务。
- 语言:Python, SQL, English。
许可证
- 许可证类型:Creative Commons Attribution 4.0 International License。
搜集汇总
数据集介绍
构建方式
StaQC数据集源自Stack Overflow平台,通过一种创新的双视角层次神经网络(Bi-View Hierarchical Neural Network)自动挖掘而成。其构建过程整合了三种来源:多代码答案帖、单代码答案帖以及针对多代码答案帖的人工标注。在数据采集阶段,研究者将代码片段界定为“独立解决方案”,即仅凭该代码即可解答提问者的问题。人工标注部分则对每个多代码答案帖中的代码块逐一赋予布尔标签,标识其是否为独立解决方案。最终,该数据集涵盖了约14.8万对Python领域与12万对SQL领域的问答-代码对,形成了结构化的训练资源。
特点
StaQC数据集的核心特点在于其多维度、多语言的配置设计。数据集分为六个子配置:mca_python、mca_sql、sca_python、sca_sql、man_python和man_sql,分别对应多代码答案、单代码答案和人工标注三种类型,每种类型均包含Python和SQL两种编程语言。每个样本包含问题ID、问题标题及代码片段字段,其中人工标注配置额外提供了布尔型字段is_sda,用于指示代码是否为独立解决方案。数据规模从千余条(如man_sql的1587条)到数万条(如sca_python的85294条)不等,总样本量超过20万,为自然语言到代码生成任务提供了丰富且高质量的语料。
使用方法
该数据集可通过Hugging Face的datasets库便捷加载。用户需指定配置名称,例如使用load_dataset('koutch/staqc', 'mca_python')获取多代码答案的Python子集,或使用load_dataset('koutch/staqc', 'man_sql')加载SQL领域的人工标注数据。每个配置仅包含训练集,可直接用于模型训练与评估。在代码生成任务中,可将question字段作为自然语言输入,snippet字段作为目标代码输出;对于人工标注配置,还可利用is_sda字段筛选或加权独立解决方案,以优化模型对关键代码片段的关注度。数据采用CC-BY-4.0许可协议,便于学术研究与商业应用。
背景与挑战
背景概述
StaQC(Stack Overflow Question-Code pairs)数据集由Ziyu Yao、Daniel S. Weld、Wei-Peng Chen和Huan Sun于2018年提出,源自俄亥俄州立大学等机构的研究工作。该数据集旨在解决自然语言与代码之间的语义鸿沟问题,通过从Stack Overflow中系统性地挖掘高质量的问题-代码对,为代码生成与代码理解任务提供大规模监督信号。StaQC包含约148K个Python和120K个SQL领域的问答对,其构建依赖于一种双视角层次神经网络(Bi-View Hierarchical Neural Network),实现了对代码片段是否可作为“独立解决方案”的自动判别。该数据集在自然语言处理与软件工程交叉领域产生了深远影响,成为后续代码智能研究的重要基准。
当前挑战
StaQC所面临的挑战首先体现在领域问题的复杂性上:自然语言描述与代码实现之间的映射并非一一对应,同一问题可能对应多种代码方案,而部分代码片段仅作为辅助说明而非独立解决方案,这要求模型具备区分“独立代码解”的能力。其次,在数据集构建过程中,如何从Stack Overflow海量、嘈杂的帖子中准确筛选出高质量的问题-代码对是一大难题。多代码答案帖子中常混有非解代码,需要设计精细的标注策略和自动化分类方法。此外,不同编程语言(Python与SQL)的语法和语义差异也增加了数据清洗与对齐的难度,确保跨语言数据的一致性和可靠性是构建过程中的关键挑战。
常用场景
经典使用场景
StaQC数据集作为自然语言到代码生成领域的标杆性资源,最经典的应用场景在于训练和评估基于深度学习的代码生成模型。通过将Stack Overflow上的自然语言问题标题与经系统挖掘的独立代码片段进行配对,该数据集为模型提供了海量高质量的‘问题-代码’映射实例,使模型能够学习从人类意图描述到具体编程实现的跨模态转换能力。研究者通常利用其Python和SQL两个子集,分别开展面向通用编程语言和结构化查询语言的代码生成任务,从而在可控的实验环境下验证模型对语义理解与语法生成的综合性能。
解决学术问题
StaQC数据集的核心学术贡献在于系统性地解决了代码语料库构建中的两大难题:噪声过滤与语义对齐。传统从问答社区爬取的代码数据常包含大量非独立或冗余片段,难以直接用于监督学习。该数据集通过双视角层次神经网络自动挖掘独立代码解决方案,并辅以人工标注的多代码答案后处理机制,有效提升了数据纯净度与任务匹配度。这为自然语言处理与软件工程交叉领域的研究提供了可靠基准,推动了代码检索、代码摘要及程序合成等方向从规则驱动向数据驱动范式的转型,显著降低了模型训练对人工标注的依赖。
衍生相关工作
StaQC数据集的发布催生了一系列具有影响力的后续工作。在模型架构层面,CodeBERT、GraphCodeBERT等预训练语言模型均将其作为微调基准任务之一,验证了代码语义表示的有效性。在任务拓展方面,研究者基于其多代码答案标注衍生出代码排序与选择任务,推动了‘代码重排序’方向的发展。此外,该数据集还被用于跨语言代码迁移学习研究,例如利用Python子集训练的模型通过域适应技术迁移至JavaScript等语言,展现了其在程序语言泛化能力探索中的基石作用。
以上内容由遇见数据集搜集并总结生成


