
遇见数据集

humaneness-voice-dpo-rebalanced-six-task-v1

收藏
Hugging Face2026-09-30 更新2026-10-01 收录
官方服务:

资源简介:

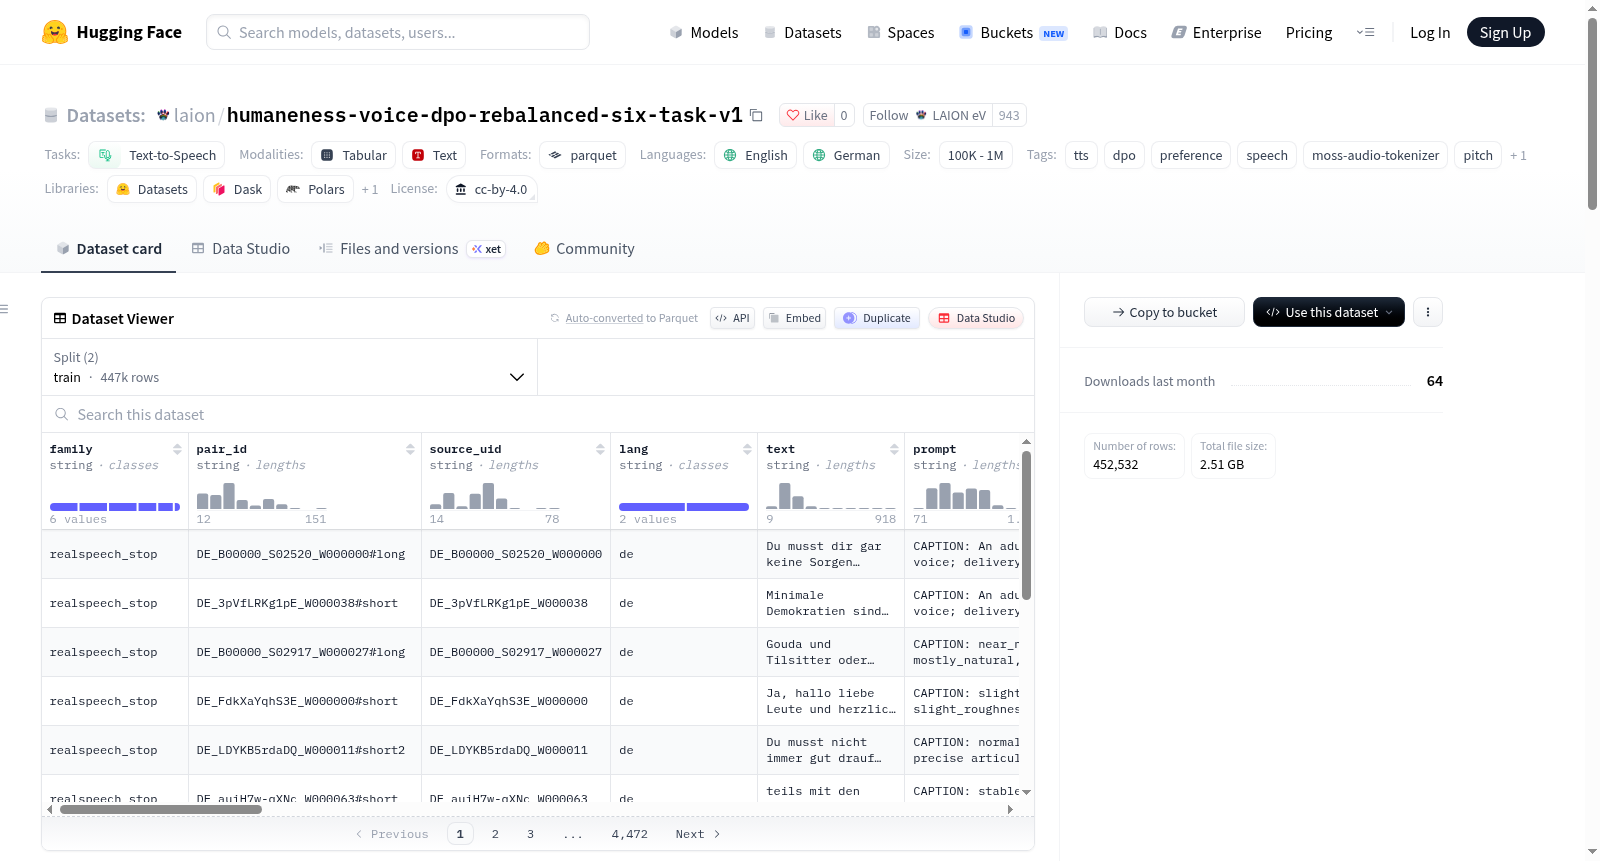
该数据集名为“Humaneness Voice — Rebalanced Six-Task DPO Mix v1”,是一个用于语音合成偏好学习(DPO)的训练混合集。它包含总计447,179个训练偏好对和5,353个验证偏好对,以Zstandard压缩的Parquet分片文件存储。数据来源于六个任务家族:realspeech_stop(10万对)、voice_emotion(10万对)、voice_truncation(10万对)、cfg_p2_length(55,995对)、s5_pitch(66,805对)和quality_repair_sidon(24,379对)。每个样本包含chosen和rejected两种音频的MOSS Audio Tokenizer V2代码块(小端uint16数组,每80毫秒帧对应12个码本值),以及相关元数据(如家庭标签、对ID、源UID、语言、文本、提示等)。数据集主要用于训练文本转语音(TTS)系统中的偏好优化模型。注意:pitch任务存在严重的质量混淆,不应作为纯说话人身份数据集使用;验证集仅覆盖四个家族,缺少s5_pitch和quality_repair_sidon的验证对。所有音频由MOSS V2解码器生成,不包含原始波形。许可证为CC-BY-4.0。

The dataset is named "Humaneness Voice — Rebalanced Six-Task DPO Mix v1", a training mixture for preference learning (DPO) in speech synthesis. It contains a total of 447,179 training preference pairs and 5,353 validation preference pairs, stored as Zstandard-compressed Parquet shards. The data originates from six task families: realspeech_stop (100k pairs), voice_emotion (100k pairs), voice_truncation (100k pairs), cfg_p2_length (55,995 pairs), s5_pitch (66,805 pairs), and quality_repair_sidon (24,379 pairs). Each sample includes MOSS Audio Tokenizer V2 code blocks (little-endian uint16 arrays, 12 codebook values per 80ms frame) for both chosen and rejected audio, along with associated metadata (e.g., family tags, pair IDs, source UIDs, language, text, prompts). The dataset is primarily used for training preference optimization models in text-to-speech (TTS) systems. Note: The pitch task has severe quality confounding and should not be used as a pure speaker identity dataset; the validation set covers only four families, missing validation pairs for s5_pitch and quality_repair_sidon. All audio is generated by the MOSS V2 decoder, with no original waveforms included. License: CC-BY-4.0.
提供机构:
LAION eV
创建时间:
2026-09-30
搜集汇总
数据集介绍
humaneness-voice-dpo-rebalanced-six-task-v1 数据集图片
构建方式
在语音合成偏好优化数据资源建设领域,该数据集通过整合六个来源各异的子任务构建而成。训练集包含447,179对偏好样本,验证集为5,353对,均以Zstandard压缩的Parquet分片存储,音频信息以MOSS音频分词器V2的码本序列表示,不保留波形文件。其中三个子任务以确定性的BLAKE2b最低秩采样上限至100,000对,其余子任务则完整纳入原始发布对或本地质量修复对。验证集从新训练混合中移除所有源UID后,保留四个子任务的独立留出视图,确保训练与验证之间不存在样本重叠。
特点
该数据集的核心特征在于其多任务混合的偏好数据形态与细粒度的诊断信息。每条样本统一包含任务家族、语言、文本提示、所选与拒绝的音频码本及其帧数,以及可选的参考码和来源注解。码本为小端uint16数组,每80毫秒帧含12个码本值。音高任务存在强烈的质量混淆,仅3,350对被视为音高身份聚焦候选;质量修复任务则基于DNSMOS增益和说话人边距筛选。数据规模介于十万至百万之间,覆盖英语和德语,适用于文本到语音的偏好对齐研究。
使用方法
研究人员可通过HuggingFace数据集库以流式或本地方式加载该数据集。加载后,利用NumPy将所选与拒绝的码本字节串解析为形状为帧数乘12的uint16矩阵,再借助MOSS音频分词器V2解码器还原为可听音频。该混合数据旨在用于训练阶段的偏好优化,而非无偏基准评测。验证集仅覆盖四个子任务,音高与质量修复任务需依赖独立生成的音频进行评估。使用者应注意自动标注的模型偏差,并对包含个人或敏感话语的转录文本进行隐私与内容审查。
背景与挑战
背景概述
语音合成领域长期追求自然且富有表现力的合成语音,偏好优化成为提升音质与说话人相似度的关键手段。LAION 发布的 Humaneness Voice 系列数据集,旨在为文本到语音模型提供大规模的偏好对数据。本数据集 humaneness-voice-dpo-rebalanced-six-task-v1 于 2026 年由 LAION 团队构建,整合了六个任务家族的偏好对,涵盖真实语音停止、情感、截断、长度控制、音高及质量修复等维度,共包含 447,179 个训练对和 5,353 个验证对。其核心研究问题在于利用直接偏好优化(DPO)微调语音合成模型,以增强合成语音的人类相似度。作为不可变的偏好数据视图,该数据集为可复现的 DPO 实验提供了基准,推动了语音合成领域对偏好学习范式的探索。
当前挑战
该数据集所应对的领域问题在于,如何通过偏好数据有效提升语音合成模型在自然度、表现力及说话人一致性方面的性能。构建过程中面临多重挑战:首先,数据源自多个上游数据集,需确保各任务家族之间的平衡与去重,例如对三个任务家族进行确定性上限截断;其次,音频以 MOSS Audio Tokenizer V2 编码表示,解码与验证依赖特定工具,增加了处理复杂度;再者,音高任务存在严重音质混淆,仅少数对为音高身份聚焦,评估时需分离身份与音质;此外,质量修复任务中情感保持未逐对测量,不能作为选择标准;最后,自动标注(如 DNSMOS、ECAPA、ASR)带有模型偏差,真实语音转录可能包含敏感内容,需下游用户自行审查。
常用场景
经典使用场景
在文本到语音合成领域,直接偏好优化(DPO)已成为对齐生成语音与人类感知偏好的关键范式。该数据集汇聚六类任务——真实语音停延、语音情感、语音截断、无分类器引导长度、音高及质量修复——构建了逾四十四万对偏好样本,每对样本以MOSS音频分词器V2的离散编码表示,摒弃波形文件,便于高效训练。其经典用法在于为TTS模型提供成对的正例与负例,使模型通过DPO损失学习区分更自然、更符合人类听感的合成语音,从而在停延、情感、音高和整体质量等维度实现细粒度优化。
衍生相关工作
该数据集衍生自一系列公开的偏好数据集,包括laion/tts-realspeech-dpo-en-de、laion/laion-voice-profiles-dpo、laion/laion-voice-profiles-dpo-cfg以及laion/humaneness-voice-s5-pitch-dpo-v1等,并整合了本地SIDON质量修复对。其构建过程保留了上游提示来源与三Whisper训练视图的审计信息,为后续研究提供了可追溯的 lineage。基于此混合数据,研究者已开展DPO-LoRA秩64与秩128的消融实验,并推动了对音高身份聚焦子集与质量混杂问题的独立评估,形成了语音偏好优化领域的一系列可复现基准与分析方法。
数据集最近研究
最新研究方向
在语音合成领域,基于人类偏好的直接偏好优化(DPO)正成为提升生成语音自然度与表现力的关键范式。humaneness-voice-dpo-rebalanced-six-task-v1数据集通过整合六个异质任务——涵盖真实语音停顿、情感表达、截断修复、长度控制、音高调节与质量修复——构建了大规模偏好对,并采用MOSS音频分词器编码,规避了波形存储瓶颈。当前研究聚焦于多任务偏好信号的均衡融合与混淆因子解耦,例如该数据集明确标记了音高任务中质量混杂的普遍性,推动学界分离说话人身份与声学品质的评估。此类资源为DPO在TTS中的可复现性、跨语言泛化及伦理合规提供了基准,亦呼应了生成式音频治理与偏好数据透明化的热点议题。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

