
遇见数据集

Rota do Perfume Dataset

收藏
github2026-08-27 更新2026-08-28 收录
官方服务:

资源简介:

一个虚构的阿拉伯香水B2B分销公司的模拟数据集,包含ERP(产品、订单、支付、库存)和CRM(客户、销售员、机会、访问)表,约14MB,时间跨度为2024年9月至2026年8月,故意包含数据质量问题(如格式不一致、重复、负值)用于教学实践。

A simulated dataset for a fictional Arab perfume B2B distribution company, which includes ERP tables (product, order, payment, inventory) and CRM tables (customer, salesperson, opportunity, visit). The dataset is approximately 14 MB in size, covers the time span from September 2024 to August 2026, and intentionally contains data quality issues such as inconsistent formatting, duplicate records and negative values for teaching practices.

创建时间:
2026-08-24
原始信息汇总

数据集概述

项目名称: 🧭 Imersão Jornada de Dados · Rota do Perfume

领域: 阿拉伯香水B2B分销商(客户为香水店、药店、经销商和电商),虚构公司,数据由固定种子生成,刻意包含数据脏乱问题。

技术栈: Databricks Free Edition(serverless)、SQL、Python、Claude Code


🗄️ 数据集详情

生成方式:material/gerar_dataset.py 生成,固定种子(seed 42),所有人生成完全相同的数据。数据集约14 MB,覆盖时间段为2024年9月至2026年8月。

目录结构:

  • dados/erp/ — 产品、订单、订单项、付款、库存
  • dados/crm/ — 客户、销售员、客户分配、机会、拜访

📊 数据表清单

表名 行数 内容
pedidos 28,729 客户、销售员、日期、渠道、状态、金额
itens_pedido 197,724 SKU、数量、实际价格、折扣
pagamentos 27,772 支付方式、分期、到期日、状态
produtos 292 类别、品牌、香调、成本、上市时间
estoque 8,400 每周SKU快照,含缺货情况
clientes 3,040 CNPJ、公司名称、细分市场、城市
visitas 37,936 日期、结果、时长
oportunidades 5,979 销售漏斗:来源、阶段、金额、丢单原因
carteira 3,637 销售员-客户绑定,含有效期
vendedores 42 区域、入职、离职、目标

🧹 数据脏乱问题(刻意设计)

  • CNPJ存在三种格式
  • 日期存在两种格式
  • 客户数据重复
  • 退货以负数数量体现
  • 已离职销售员仍保留活跃客户分配

这些脏乱问题将成为后续清洗教学的内容,不应修改生成器。


🏗️ 架构与分层

  • 目录: lakehouse_rotaperfume(在课程中通过脚本动态创建)
  • 分层: bronze(原始脏数据)→ silvergold(用于BI和Genie)
  • 命名规范: 表名和列名使用 snake_case 和葡萄牙语,与CSV文件一致

🎓 教学课程结构(4晚)

夜晚 主题 内容
第1晚 目标与首次分析 通过浏览器界面:创建目录、bronze层、6个SQL示例
第2晚 数据工程 自动化项目:12个任务的管道、dashboard、Genie
第3晚 数据科学 模型放入 Unity Catalog,200家客户排队列表(15个任务)
第4晚 应用与智能体 管理层Genie、Databricks App、回访呼叫功能(16个任务)

📝 实现方式

整个项目从原始CSV到可写回gold层的App,由12个按顺序粘贴到Claude Code的提示词完成,每个提示词以部署结束。完整提示词文本见仓库的 PROMPTS.md


🚀 快速开始

bash

1. 生成数据集(固定种子,所有人数据一致)

python3 material/gerar_dataset.py --saida ./dados --seed 42

2. 认证Databricks

databricks auth login

3. 从第1晚开始(全程浏览器操作)

cd aulas/aula-01-databricks-sql && cat README.md

另有 scripts/run_sql.py 工具可逐条执行仓库中任何 .sql 文件到warehouse。
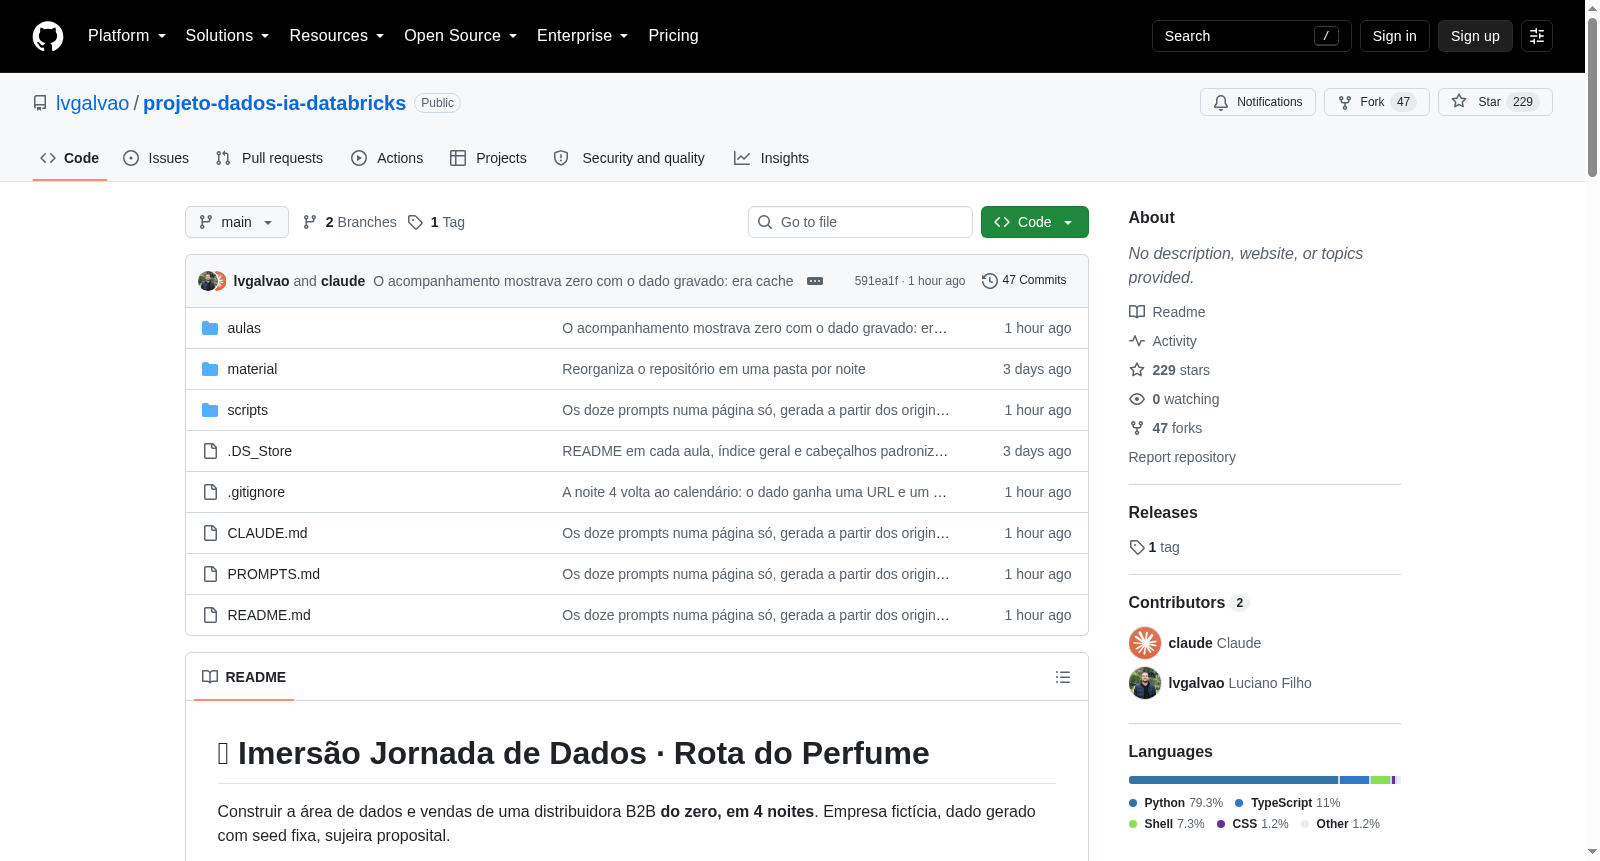
搜集汇总
数据集介绍
Rota do Perfume Dataset 数据集图片
构建方式
Rota do Perfume Dataset 是一套为沉浸式数据科学课程精心构造的合成企业数据集,其生成逻辑以固定随机种子(seed 42)为基石,确保每一位学习者能够复现出完全一致的数据全貌。数据集模拟了一家阿拉伯香水B2B分销商的业务生态,横跨ERP与CRM两大核心模块,具体涵盖产品、订单、支付、库存、客户、销售团队、商机及拜访记录等十个维度的数据表,整体容量约14MB,时间跨度自2024年9月至2026年8月。通过脚本化生成,数据中刻意注入了真实业务场景中常见的脏数据,如CNPJ格式不一、日期类型混杂、客户记录重复、负数量退货等,借此构造出亟待清洗与治理的原始数据层。
使用方法
数据集的使用路径与课程节奏深度绑定,围绕四个夜晚的实战项目徐徐展开。学习者首先生成数据,随后通过Databricks Free Edition平台,在笔记本中逐步构建从Bronze到Silver再到Gold的完整数据管道。整个流程由十二个精心编排的提示词(Prompt)驱动,覆盖数据工程、数据科学乃至应用开发全链路。具体实践时,可借助仓库提供的run_sql.py脚本直接执行任意SQL语句,亦能使用databricks bundle deploy将模型与仪表板部署至生产环境。最终,该数据集不仅支撑起一个可交互的商务智能仪表盘,还能训练出用于客户优先级排序的机器学习模型,并封装为一个具备实际业务反馈能力的网络应用,完整呈现了从数据到决策再到产品的闭环旅程。
背景与挑战
背景概述
Rota do Perfume Dataset 诞生于2025年8月,由巴西数据社区Jornada de Dados发起,旨在通过一场为期四天的沉浸式教学实践,构建一个虚构的阿拉伯香水B2B分销商的完整数据与销售体系。该数据集模拟了从企业资源计划(ERP)到客户关系管理(CRM)的10张核心业务表,涵盖约28,729条订单记录与292种产品,时间跨度从2024年9月至2026年8月,并以固定随机种子生成以保证可复现性。作为教育工具,它深刻反映了真实业务中数据的不规范性,如CNPJ格式不一、重复客户、负数量退货等,为学习者提供了从数据工程、科学分析到应用部署的全链路实战场景。该数据集凭借其贴近现实的复杂性与教学导向,已成为巴西数据科学教育领域的重要资源,推动了数据技能从理论向实践的转化。
当前挑战
该数据集所面临的挑战多维且深刻。在领域层面,它致力于解决B2B分销行业中数据质量参差不齐、业务决策依赖经验而非数据洞察的痛点,通过引入数据清洗(如统一CNPJ格式)、数据建模(如分层架构bronze/silver/gold)及机器学习预测(如构建客户优先级排序模型)等策略,培养学习者应对现实数据问题的能力。在构建过程中,团队需在有限时长内设计出高度仿真的业务场景,平衡数据规模(约14MB)与教学可操作性,同时确保数据中蕴含的“刻意污损”足够真实而不至于误导,并通过固定种子保证全局一致性。此外,跨平台集成(Databricks、SQL、Python及Claude Code)的技术复杂性,以及将复杂数据流程压缩为12个可执行提示词的抽象智慧,均构成了数据集开发中的重大挑战。
常用场景
经典使用场景
Rota do Perfume Dataset 作为巴西B2B香水分销行业的仿真业务数据源,常被用于数据工程与数据分析的教学实践。其生成脚本采用固定随机种子,保证了数据可复现性,并刻意掺入脏数据(如CNPJ格式不一、日期格式混杂、重复客户、负数退款等),使得该数据集成为构建从原始数据到决策支持全流程的理想起点。学习场景涵盖使用Databricks SQL进行探索性分析、搭建ETL管道,以及实施Medallion架构(bronze-silver-gold分层),用于演示数据清洗、转换和加载(ELT)的完整过程。
解决学术问题
该数据集解决了学术研究中缺乏真实业务数据与脏数据并存场景的难题。它同时提供了ERP和CRM两套系统数据,包含订单、支付、库存、客户、销售人员及销售机会等多元表实体,为研究数据质量对分析结果的影响提供了可控实验平台。通过刻意引入的异常记录,学者可以系统对比不同数据清洗策略对销售预测、客户分层等结论的鲁棒性影响。此外,固定种子生成机制使得研究结果可复现,便于学术评审和跨机构对比,推动了可重复性研究在数据驱动营销领域的应用。
实际应用
在实际应用中,该数据集常被用作企业数据团队的培训与演练沙盘。业务人员可据此模拟销售业绩分析、客户价值评估、销售漏斗诊断及库存周转优化等决策场景。例如,通过分析客户购买频次与金额,制定差异化营销策略;利用销售人员与客户关联数据,评估销售团队业绩并优化资源配置。同时,该数据集支持构建实时仪表板和数据产品原型,作为公司内部数据文化普及的载体,帮助非技术部门理解数据驱动的决策流程,提升组织整体的数字化素养。
数据集最近研究
最新研究方向
该数据集聚焦于阿拉伯香水B2B分销领域,通过构建从原始数据到商业决策的完整数据管线,实现了数据工程、数据科学与智能应用的深度融合。其前沿研究方向体现在利用固定种子生成含真实噪声的数据,模拟企业数据治理挑战,并结合Databricks的湖house架构、SQL与Python技术栈,探索从数据清洗到机器学习模型部署再到生成式AI应用(如Genie)的全自动化流程。这一实践响应了数据驱动业务决策的行业趋势,尤其关注中小型分销企业的数据化转型,为数据团队提供了低成本、可复现的端到端解决方案,对推动数据工程与AI落地的平民化具有重要意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


