ElectraAI-Dataset-v4
收藏资源简介:
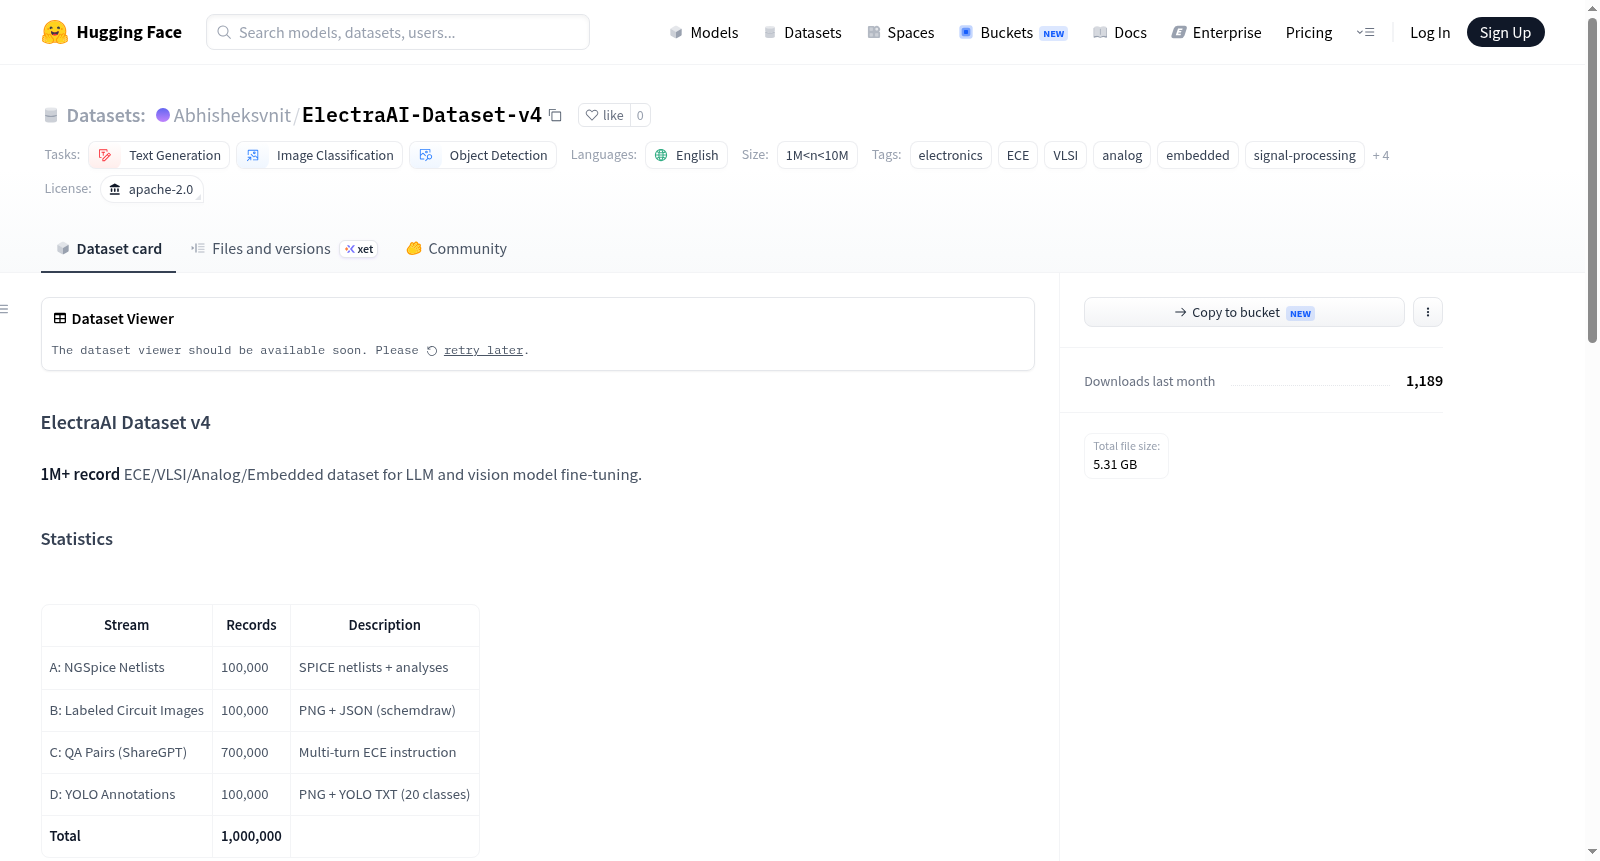
ElectraAI Dataset v4 是一个专为电子与计算机工程(ECE)领域设计的大规模开源数据集,包含超过100万条记录,旨在用于微调大型语言模型(LLMs)和视觉模型。数据集涵盖多个子领域,包括VLSI、模拟电路、嵌入式系统、信号处理等,覆盖500多种电路拓扑结构。具体由四个数据流构成:A流提供10万条NGSpice网表记录,包含SPICE电路网表及其分析;B流包含10万条带标签的电路图像,格式为PNG原理图及对应的JSON标签;C流包含70万条以上的问答对(基于ShareGPT格式),涉及多轮电子工程指令交互;D流提供10万条YOLO标注数据,包括PNG图像和YOLO TXT文件,用于目标检测任务。领域覆盖广泛,包括模拟电子(100种拓扑)、模拟VLSI(100种拓扑)、网络理论(100种拓扑)、数字VLSI与静态时序分析(60种拓扑)、嵌入式系统、信号处理、通信(各50种拓扑)、微处理器、电力电子、AI+VLSI(各50种拓扑)。该数据集适用于文本生成、图像分类和对象检测等多种机器学习任务,由ElectraAI v4工具生成,以促进电子工程教育、研究和自动化应用。
ElectraAI Dataset v4 is a large-scale open-source dataset specifically designed for the field of Electrical and Computer Engineering (ECE), containing over 1 million records, aimed at fine-tuning large language models (LLMs) and vision models. The dataset covers multiple subfields, including VLSI, analog circuits, embedded systems, signal processing, etc., encompassing over 500 circuit topologies. It is structured into four data streams: Stream A provides 100,000 NGSpice netlist records, including SPICE circuit netlists and their analyses; Stream B contains 100,000 labeled circuit images in PNG schematic format with corresponding JSON labels; Stream C includes over 700,000 question-answer pairs (based on ShareGPT format) involving multi-turn electronic engineering instruction interactions; Stream D offers 100,000 YOLO annotated data, comprising PNG images and YOLO TXT files for object detection tasks. The coverage spans various domains, including analog electronics (100 topologies), analog VLSI (100 topologies), network theory (100 topologies), digital VLSI and static timing analysis (60 topologies), embedded systems, signal processing, communications (50 topologies each), microprocessors, power electronics, and AI+VLSI (50 topologies each). This dataset is suitable for multiple machine learning tasks such as text generation, image classification, and object detection, generated by the ElectraAI v4 tool to promote electronic engineering education, research, and automation applications.
数据集概述:ElectraAI Dataset v4
该数据集是一个面向电子工程、计算机工程、超大规模集成电路、模拟电路和嵌入式系统领域的大型多模态数据集,总计包含 1,000,000 条记录,专为大型语言模型(LLM)和视觉模型微调设计。
数据集构成(四大数据流)
| 数据流 | 记录数 | 描述 |
|---|---|---|
| A: NGSpice Netlists | 100,000 | SPICE 网表与分析数据 |
| B: Labeled Circuit Images | 100,000 | 电路原理图图像(PNG)及其 JSON 标注(使用 schemdraw 生成) |
| C: QA Pairs (ShareGPT) | 700,000 | 多轮电子工程领域指令问答对 |
| D: YOLO Annotations | 100,000 | 电路图像(PNG)及其 YOLO 格式标注(包含 20 个类别) |
数据集特性
- 语言: 英语
- 许可协议: Apache-2.0
- 规模: 1M < n < 10M
- 任务类型: 文本生成、图像分类、目标检测
- 标签: 电子学、ECE、VLSI、模拟电路、嵌入式、信号处理、电路
目录结构
图像和标注文件被分片存放,每个子文件夹包含不超过 5,000 个文件,以符合 Hugging Face 的存储限制。例如:stream_B_circuit_images/images/shard_0000/、shard_0001/。
拓扑覆盖范围
数据集覆盖 500 多种拓扑结构,分布于 10 个领域,并提供对应的 QA 记录:
| 领域 | 拓扑数量 | QA 记录数 |
|---|---|---|
| 模拟电子学 | 100 | 95,000 |
| 模拟 VLSI | 100 | 85,000 |
| 网络理论 | 100 | 95,000 |
| 数字 VLSI + STA | 60 | 80,000 |
| 嵌入式系统 | 50 | 70,000 |
| 信号处理 | 50 | 60,000 |
| 通信 | 50 | 60,000 |
| 微处理器 | 50 | 50,000 |
| 电力电子 | 50 | 65,000 |
| AI + VLSI | 40 | 40,000 |
YOLO 类别定义(数据流 D)
共 20 个组件类别:电阻、电容、电感、二极管、齐纳二极管、BJT NPN、BJT PNP、NMOS、PMOS、运算放大器、电压源、电流源、地、导线节点、变压器、开关、电压探针、电流探针、IC 块、逻辑门。
使用示例
python from datasets import load_dataset
加载问答对用于 LLM 微调
ds = load_dataset("Abhisheksvnit/ElectraAI-Dataset-v4", data_files="stream_C_qa_pairs/*.jsonl")