
PROFASR-BENCH
收藏资源简介:
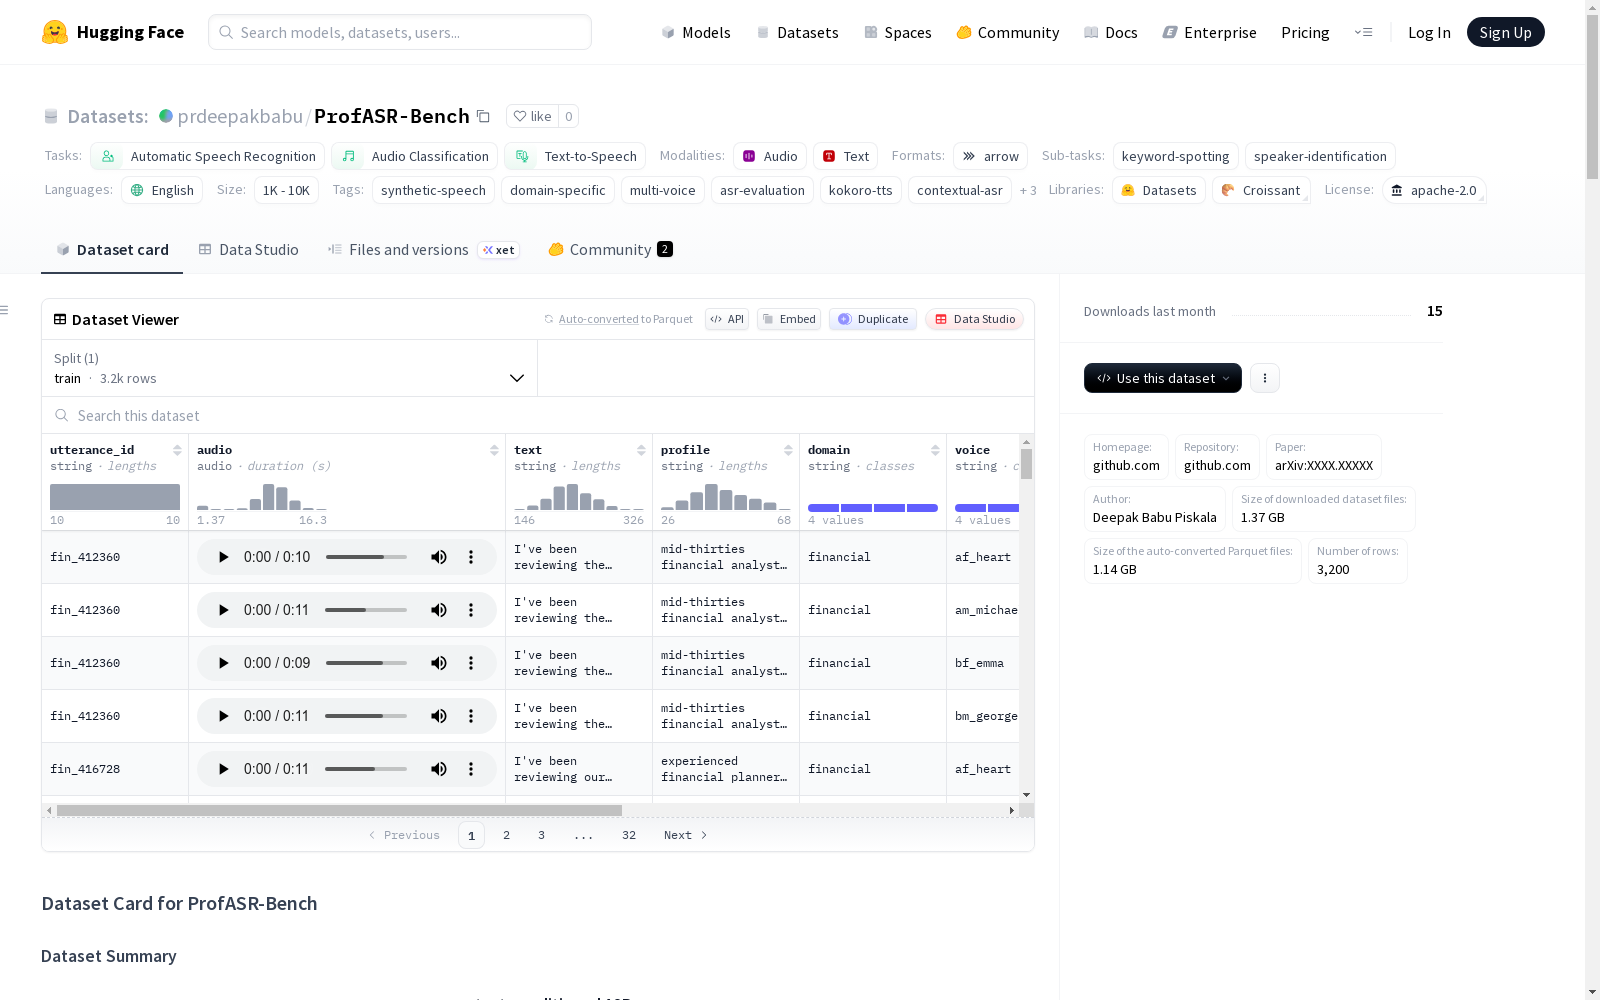
PROFASR-BENCH是由研究者Deepak Babu Piskala构建的专业场景语音识别评测数据集,聚焦金融、医疗、法律和技术四大高风险领域。该数据集包含自然语言提示与实体密集的目标话语配对数据,通过合成语音管道生成,确保专业术语覆盖和口音/性别多样性。其核心价值在于支持上下文条件化评估,包含实体感知指标和分片公平性分析,旨在解决传统ASR系统在专业术语识别和上下文利用不足的痛点。数据集采用标准化报告格式,为语音模型的实时领域适应能力提供基准测试框架。
PROFASR-BENCH is a specialized speech recognition evaluation dataset constructed by researcher Deepak Babu Piskala, focusing on four high-risk domains: finance, healthcare, law, and technology. This dataset includes paired data of natural language prompts and entity-dense target utterances, which is generated via a synthetic speech pipeline to ensure coverage of professional terminology and diversity in accents and genders. Its core value lies in supporting context-conditioned evaluation, which covers entity-aware metrics and slice-based fairness analysis, aiming to address the pain points of traditional ASR systems, namely insufficient recognition of professional terms and inadequate utilization of context. The dataset adopts a standardized reporting format and provides a benchmarking framework for evaluating the real-time domain adaptation capabilities of speech models.
ProfASR-Bench 数据集概述
数据集基本信息
- 数据集名称:ProfASR-Bench
- 主页:https://github.com/prdeepakbabu/ProfASR-Bench
- 代码库:https://github.com/prdeepakbabu/ProfASR-Bench
- 论文:https://arxiv.org/abs/XXXX.XXXXX
- 作者:Deepak Babu Piskala
- 许可协议:Apache 2.0 License
- 语言:英语
- 规模:1K<n<10K
- 任务类别:自动语音识别、音频分类、文本转语音
- 任务ID:关键词识别、说话人识别
- 标签:合成语音、领域特定、多说话人、ASR评估、kokoro-tts、上下文ASR、专业谈话、实体识别、提示条件
数据集描述
ProfASR-Bench 是一个用于金融、医学、法律和技术等高风险应用领域的上下文条件自动语音识别的专业谈话评估套件。每个示例将一个自然语言提示(领域线索和/或说话人档案)与一个富含实体的目标话语配对,从而能够对上下文条件识别进行受控测量。
关键发现 - 上下文利用差距:当前系统名义上可提示,但未能充分利用现成的辅助信息。
支持的任务
- 主要任务:上下文条件自动语音识别
- 次要任务:
- 实体感知的ASR评估
- 分片公平性分析
- 对抗鲁棒性测试
- 领域适应研究
数据集结构
数据实例
每个数据实例包含:
- 音频:高质量WAV文件(22kHz采样率)
- 文本/真实转录:真实转录文本
- 提示:用于上下文条件处理的先前句子
- 元数据:领域、语音、说话人档案、ASR难度分数、命名实体
数据字段
- utterance_id:每个话语的唯一标识符
- audio:采样率为22050 Hz的音频文件
- text/truth:真实转录文本
- profile:说话人档案
- domain:专业领域
- voice:语音档案
- asr_difficulty:ASR转录难度分数
- sentences:句子序列
- prompt:提示序列
- truth:真实转录
语音档案
| 语音ID | 口音 | 性别 | 描述 |
|---|---|---|---|
af_heart |
美式 | 女性 | 高品质 |
am_michael |
美式 | 男性 | 温暖可信 |
bf_emma |
英式 | 女性 | 专业且温暖 |
bm_george |
英式 | 男性 | 清晰明确 |
数据划分
- train:3200个示例
评估协议:上下文阶梯
ProfASR-Bench支持在5种提示条件下进行系统评估:
| 条件 | 描述 |
|---|---|
| NO-PROMPT | 控制基线 |
| PROFILE | 仅说话人属性 |
| DOMAIN+PROFILE | 领域线索 + 说话人属性 |
| ORACLE | 黄金转录作为提示 |
| ADVERSARIAL | 不匹配的领域提示 |
数据集创建
数据来源
- 文本生成:Claude 3.7 Sonnet,使用领域特定提示
- 语音合成:Kokoro 82M TTS
- 实体覆盖:>97%的类型化实体分配
个人和敏感信息
数据集不包含任何个人信息,所有内容均为合成生成。说话人档案是为上下文真实性创建的虚构角色。
使用注意事项
社会影响
- 积极影响:
- 为高风险专业环境提供更好的ASR系统
- 通过合成生成减少隐私问题
- 促进可重复的ASR研究
已知限制
- 合成性质:生成的语音可能缺乏某些人类语音特征
- 领域覆盖:仅限于四个专业领域
- 语音多样性:四个语音档案可能无法捕捉完整的说话人变化
- 语言:仅限英语数据集
引用
bibtex @article{piskala2025profasrbench, title={ProfASR-Bench: A Professional-Talk ASR Dataset for High-Stakes Applications Exposing the Context-Utilization Gap}, author={Piskala, Deepak Babu}, journal={arXiv preprint arXiv:XXXX.XXXXX}, year={2025}, url={https://arxiv.org/abs/XXXX.XXXXX} }
- 1PROFASR-BENCH: A Benchmark for Context-Conditioned ASR in High-Stakes Professional Speech · 2025年


