
遇见数据集

us-caselaw-ky

收藏
Hugging Face2026-09-10 更新2026-09-11 收录
官方服务:

资源简介:

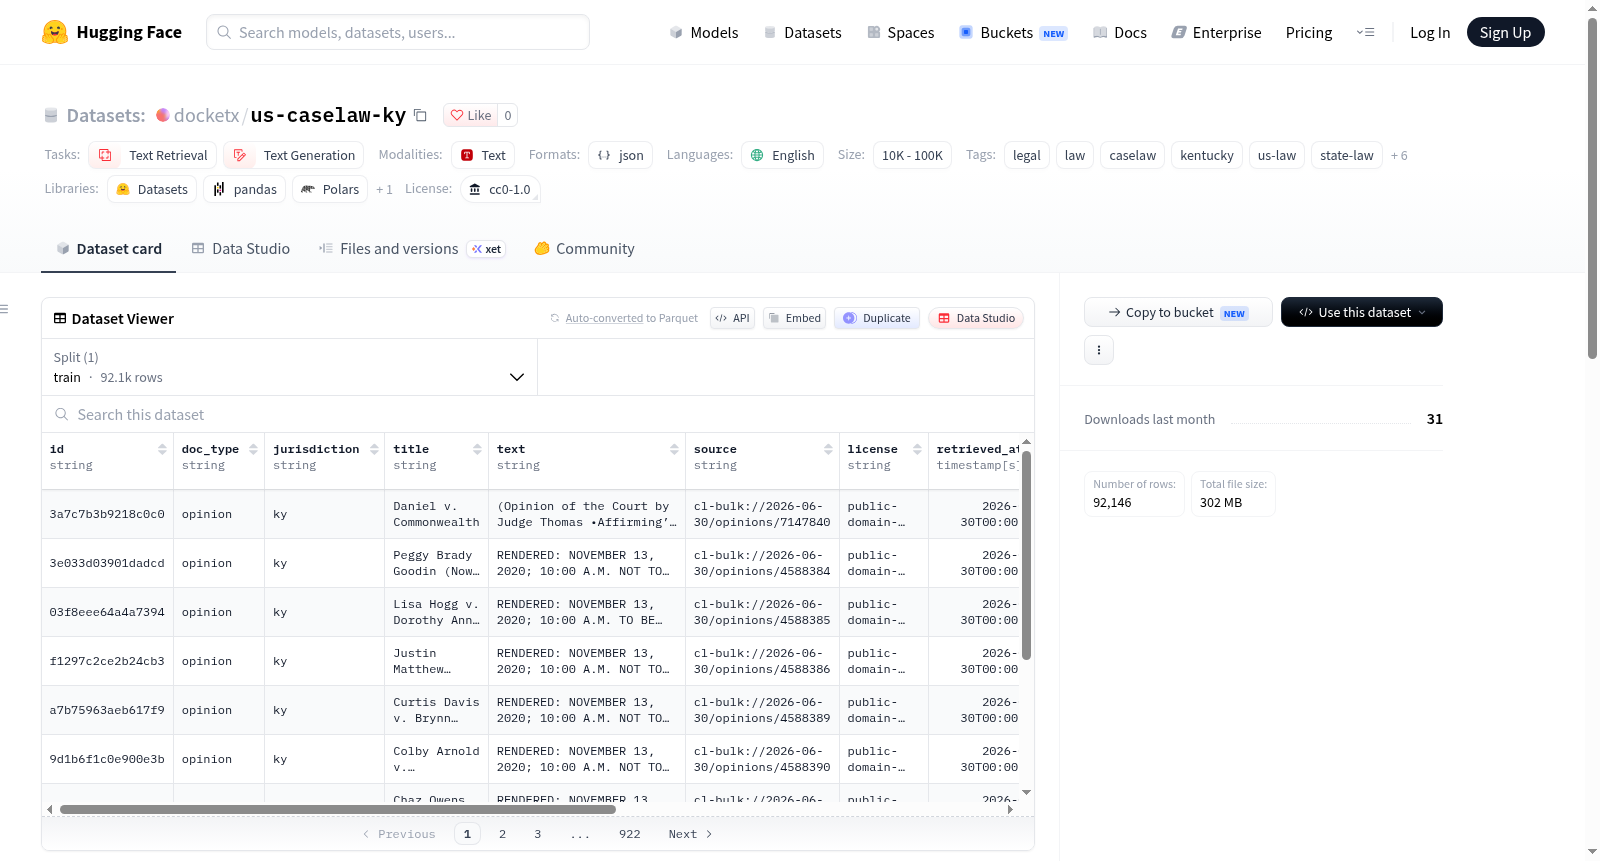
肯塔基州判例法数据集包含92,146份肯塔基州上诉法院意见的全文,来源于公共记录,数据取自Free Law Project / CourtListener于2026年6月30日的批量导出。数据集覆盖三个法院ID(ky、kyctapp、kyctapphigh),包含主要意见和单独意见,仅排除字符数少于1的文档。文档构成:81,321份(88.3%)超过2,000字符,8,801份(9.6%)在200-1,999字符之间,2,024份(2.2%)少于200字符。短文档为真实记录(如调卷令拒绝、一行命令、判决条目),故意保留以呈现完整的公共记录,用户可按文本长度过滤。数据采用docketx record v1格式,每行一条意见,字段包括:id、doc_type、jurisdiction、title、text、source、license、retrieved_at、citation、court、date和extra(CourtListener意见/集群ID及意见类型)。数据集适用于法律文本检索、文本生成、RAG(检索增强生成)等NLP任务,也可用于法律研究。司法意见属于公共领域(政府法令),本数据打包以CC0 1.0许可发布,无附加注释,不主张任何权利。

Kentucky Case Law dataset contains 92,146 full-text opinions from the Kentucky Court of Appeals, sourced from public records, derived from the Free Law Project / CourtListener bulk export on June 30, 2026. The dataset covers three court IDs (ky, kyctapp, kyctapphigh), includes majority and separate opinions, and excludes documents with fewer than 1 character. Document composition: 81,321 (88.3%) with over 2,000 characters, 8,801 (9.6%) between 200-1,999 characters, and 2,024 (2.2%) with fewer than 200 characters. Short documents are genuine records (e.g., certiorari denials, one-line orders, judgment entries) intentionally retained for completeness; users can filter by text length. Data follows the docketx record v1 format, with one opinion per line and fields including: id, doc_type, jurisdiction, title, text, source, license, retrieved_at, citation, court, date, and extra (CourtListener opinion/cluster IDs and opinion type). The dataset is suitable for NLP tasks such as legal text retrieval, text generation, RAG (retrieval-augmented generation), as well as legal research. Judicial opinions are in the public domain (government edicts); this data package is released under CC0 1.0 license with no additional annotations and no claim of rights.

创建时间:
2026-09-06
搜集汇总
数据集介绍
us-caselaw-ky 数据集图片
构建方式
该数据集源自Free Law Project旗下CourtListener平台的批量导出档案,以2026年6月30日的时间切片为基准,通过显式白名单方式严格限定三个法院标识符——ky、kyctapp与kyctapphigh,确保不因前缀匹配而引入无关司法辖区的记录。原始文档经过去重、字段规范化与结构化封装,遵循docketx record v1模式,每行存储一份意见书,并保留引用、法院、日期及CourtListener意见与簇标识等元数据。为维持公共记录的完整性,构建过程仅剔除字符数为零的空文档,对短文本亦不加以过滤,最终形成涵盖92,146份肯塔基州上诉意见书的完整语料。
特点
此数据集以公共领域司法文书为核心,收录81,321份长度超过2,000字符的实质性意见书,同时刻意保留8,801份200至1,999字符的中短文书以及2,024份不足200字符的简式裁决,包括调卷令驳回、单行命令与判决登记等真实记录,从而呈现未经过滤的完整公共档案面貌。所有文档均采用统一的docketx record v1格式,字段涵盖标识符、文书类型、管辖权、标题、正文、来源、许可、检索时间及引用信息,许可协议为CC0 1.0,不附加任何标注,亦不主张任何权利。
使用方法
研究者可通过Hugging Face datasets库以一行代码加载该数据集,实例化后即可获得结构化的法律文本语料。若面向检索增强生成或法律文本生成任务,可直接利用text字段进行语义索引与模型训练;若仅需实质性意见书,则依据len(text)字段设定阈值进行过滤,以排除简式裁决的干扰。统一的docketx record v1模式便于与DocketRouter法律语料库中的其他数据集进行交叉比对与联合分析,为法律信息检索、判例推理及司法文本挖掘提供可复现的数据基础。
背景与挑战
背景概述
法律判例文本的规模化获取与结构化组织,长期构成法律信息学与计算语言学交叉领域的基础性课题。肯塔基州判例法数据集(us-caselaw-ky)由DocketRouter团队于2026年构建,数据源自Free Law Project旗下CourtListener平台于同年6月30日发布的批量导出文件,系统收录了肯塔基州上诉法院体系下92,146份公开裁判文书,涵盖主意见与并存意见,并明确限定于ky、kyctapp、kyctapphigh三个法院标识。该数据集以docketx record v1统一格式封装,附带完整来源与许可元数据,为法律检索、判例生成及检索增强生成等任务提供了兼具规模与规范性的语料基础。
当前挑战
该数据集所面向的领域问题在于,法律裁判文书的检索与生成需在长文本、专业术语及复杂引用结构中维持语义精确性,而现行通用模型往往难以有效捕捉判例间的效力层级与论证逻辑。其构建过程亦面临显著挑战:原始导出数据中并存大量简式命令、调卷令驳回裁定及判决登记等短文本记录,若径行过滤将损害公开记录的完整性,故需在保留全部文档与提供可筛选子集之间取得平衡;同时,跨法院标识的精确匹配、文书类型与引证信息的结构化提取,以及公共领域法律文本的合规再分发,均对数据治理流程提出了严苛要求。
常用场景
经典使用场景
在计算法学与法律信息检索领域,判例法文本的获取与结构化始终是基础性难题。us-caselaw-ky数据集囊括肯塔基州三级上诉法院逾九万份公开裁判文书,天然适于构建法律文本检索与生成任务。经典使用场景聚焦于基于检索增强生成(RAG)的法律问答系统:研究者以该数据集为语料库,训练模型依据用户查询检索相关判例并生成有据可循的法律意见。同时,其完整的裁判文书结构亦可用于法律文本摘要、引文解析与判决预测等任务的基准评测。
实际应用
在法律实务与公共法律服务领域,该数据集为律所、法律援助机构及法律科技公司提供了可直接部署的判例资源。律师可借助以该数据集微调的检索模型,快速定位肯塔基州上诉法院在特定争点上的先例,提升法律检索效率。法律科技开发者可将其嵌入合同审查、诉讼策略分析或合规风险预警系统,实现判例驱动的智能辅助。此外,公共法律教育平台亦可利用其构建面向公众的判例解读工具,降低法律信息获取门槛。
衍生相关工作
作为DocketRouter法律语料库的组成部分,us-caselaw-ky与同系列各州判例数据集共同催生了一系列跨州法律语言模型与检索基准。基于该数据集的衍生工作涵盖法律领域预训练语言模型的持续微调、州法问答系统的构建以及多辖区判例检索的迁移学习研究。其统一的docketx记录格式亦促进了法律文本处理工具链的标准化,为后续研究者在不同州法体系间进行比较实验提供了可复用的数据接口与评测框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

