
遇见数据集

marketing-instruct-13k

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

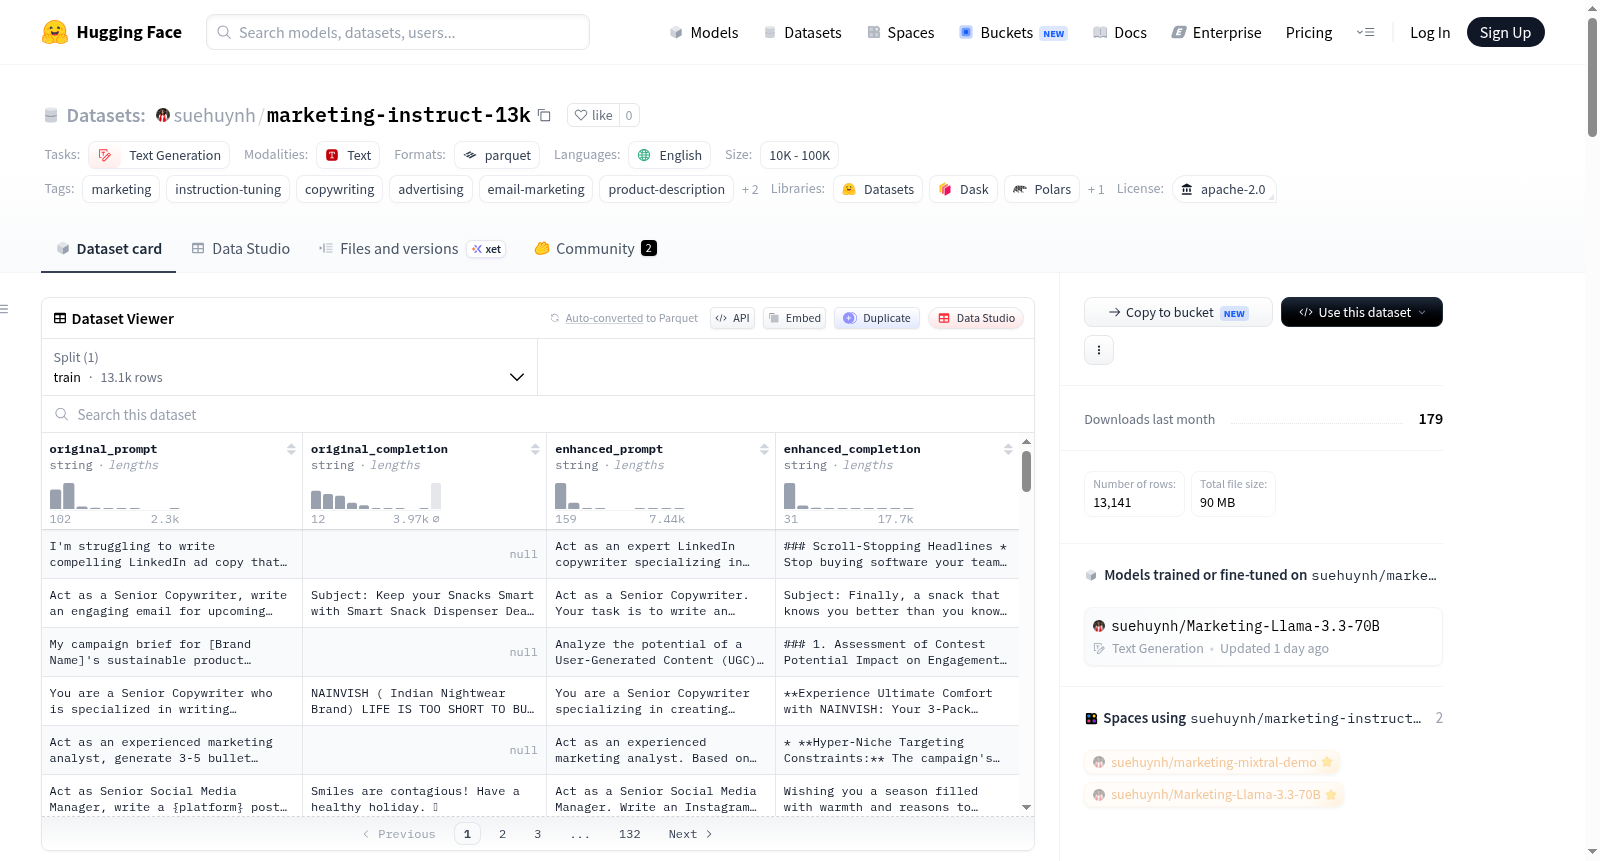
marketing-instruct-13k是一个专门为营销文案生成模型设计的指令调优数据集,包含约13,000个营销文案示例,覆盖五种核心任务类型:产品描述(约4,800个示例,基于属性)、广告/社交文案(约2,800个示例,包括Instagram广告和品牌声音配对)、电子邮件营销(约2,400个示例,涵盖活动邮件和个性化邮件)、品牌声音重写(约1,500个示例,将中性文案重写为特定品牌风格)以及表格到洞察(约1,500个示例,将活动绩效数据总结为洞察报告)。该数据集扩展了早期版本(marketing-instruct-8k),新增了基于属性的产品描述示例,并最终源自首个数据集marketing-instruct-4k。所有示例遵循统一结构,包含instruction、input和output字段。数据来源于10个公开数据集,经过去重、清理等处理,并通过AdaptData平台适配。数据集专用于AutoScientist Challenge 2026(营销类别),已成功微调Marketing-Llama-3.3-70B模型,在基准测试中达到88%胜率。适用场景包括广告文案生成、电子邮件营销等,但排除营销策略等任务。数据集仅含英文内容,基于西方营销惯例,存在偏向产品描述任务、合成示例可能携带生成模型风格等局限性,建议在使用前由人类营销人员审查输出。

marketing-instruct-13k is a curated instruction-tuning dataset for marketing copy generation, containing approximately 13,000 examples across five core task types. It is designed for the AutoScientist Challenge 2026 (marketing category) and is the largest dataset in the Marketing-Mixtral/Llama series, successfully used to fine-tune the Marketing-Llama-3.3-70B model, achieving an 88% win rate in benchmarks. The dataset extends the earlier marketing-instruct-8k version by adding around 4,000 attribute-based product description examples and traces back to the original marketing-instruct-4k dataset. All examples follow a uniform structure with instruction, input, and output fields. Task types include product descriptions (~4,800 examples, attribute-based), ad/social copy (~2,800 examples, including Instagram-specific ads and brand voice pairing), email marketing (~2,400 examples, covering campaign and personalized emails), brand voice rewriting (~1,500 examples, rewriting neutral copy to match a specified brand voice), and table-to-insights (~1,500 examples, summarizing campaign performance data into insights). Data is sourced from 10 public datasets, processed through deduplication, cleaning of short examples and placeholders, and adapted via the AdaptData platform. It is intended for marketing copy generation tasks, excluding strategy and analysis, and is limited to English with Western marketing conventions. Limitations include bias towards product descriptions and potential style patterns from synthetic examples, recommending human review before deployment.
创建时间:
2026-06-26
搜集汇总
数据集介绍
marketing-instruct-13k 数据集图片
构建方式
marketing-instruct-13k 数据集专为营销文案生成场景设计,其构建过程融合了多源数据整合与自动化处理。在初始版本 marketing-instruct-4k 的基础上,该数据集进一步整合了来自 HuggingFace 和 Kaggle 的十个公开数据源,涵盖广告文案、品牌语调改写、电子邮件营销、产品描述及营销活动数据洞察等五大任务类型。每个数据源首先经由 AdaptData 平台进行适应性改造,生成统一的指令微调格式,随后执行严格的清洗流程:包括基于输出文本哈希的去重、移除不足10词的低质量样本、剔除含有未填充占位符或编码异常的条目,并通过人工抽检确保生成提示词与客户画像的合理性与真实性。最终,这一系统性流程产出约13,000条高质量指令-输出对,为营销领域的大语言模型微调提供了坚实的数据基础。
特点
该数据集的核心特点在于其领域聚焦性与规模扩展性。作为 marketing-instruct 系列中最大的版本,它专门针对文案生成而非战略分析任务进行设计,排除了 SWOT 分析、竞争对比等商业咨询类内容,从而确保训练目标的高度一致性。数据集覆盖五大任务类型,其中产品描述任务占据最大比例(约37%),其余为广告社交媒体文案、电子邮件营销、品牌语调改写以及表格到洞察摘要,这种结构使模型能够广泛学习不同营销场景下的语言风格与表达逻辑。此外,所有数据均为英文,并偏向西方市场营销惯例与消费者/B2B SaaS 场景,反映了主流商业文案的语用特征。数据集中使用的客户画像为合成构造,不涉及真实个人信息,保障了隐私安全。
使用方法
该数据集主要面向需要进行指令微调的营销文案生成模型,开发者可直接将其用于监督式微调,以提升模型在广告文案、电子邮件营销、产品描述、品牌语调改写及营销数据洞察摘要等五项核心任务上的生成能力。每个样本遵循统一的指令微调模式,包含 instruction(任务描述)、input(可选的结构化上下文,如属性列表或表格)和 output(目标营销文案)三个字段,便于直接加载和训练。值得注意的是,由于产品描述样本占比最大,用户若希望模型在五项任务上表现更为均衡,可考虑使用该系列下分布更均匀的 marketing-instruct-4k 或 marketing-instruct-8k 数据集。训练后的模型输出在发布前应经人工审核,特别需核实产品描述中的事实性声明。
背景与挑战
背景概述
营销文案生成是自然语言处理领域的重要应用方向,旨在通过人工智能技术自动生成广告、邮件、产品描述等营销内容,以提升营销效率与创意质量。marketing-instruct-13k数据集由Sue Huynh于2026年创建,面向AutoScientist Challenge 2026营销赛道,是迄今为止最大的营销文案指令微调数据集。该数据集涵盖约13,000条示例,横跨广告文案、电子邮件营销、产品描述、品牌语调改写及表格数据洞察五大任务类型,并在此基础上训练出Marketing-Llama-3.3-70B模型,在与基础模型的对比中达到88%的胜率。该数据集的发布填补了营销领域高质量指令微调数据的空白,为低资源场景下的自动化文案生成研究提供了关键支撑。
当前挑战
营销文案生成面临多重挑战。首先,领域问题层面,营销文案需兼具创意性、品牌一致性与事实准确性,传统模型难以在多样化场景中保持高质量输出,尤其在跨任务类型(如从产品描述到品牌语调改写)的泛化能力上存在瓶颈。其次,数据集构建过程中,需要融合来自HuggingFace、Kaggle等多平台的异构源数据,经历去重、长度过滤、编码修复及手动抽检等繁琐处理流程,以确保数据质量。此外,数据分布的不均衡性(如产品描述占比接近37%)可能导致模型偏向某一任务,削弱其他类型的表现。合成数据带来的风格偏差以及西方英语营销语境的偏向性,也增加了模型在实际部署中的适配难度。
常用场景
经典使用场景
marketing-instruct-13k作为营销文案生成领域的核心指令微调数据集,其经典应用场景聚焦于五大任务类型:广告文案创作、邮件营销撰写、产品描述生成、品牌语调重写以及营销活动数据洞察。该数据集涵盖了约13,000条高质量的英文营销文本样本,使研究者能够训练出在品牌语调一致性、文案风格多样性以及任务指令遵循能力上表现出色的语言模型。尤其在产品描述任务上,该版本新增了约4,000条基于属性的电商描述样本,为构建面向在线零售场景的智能内容生成系统提供了坚实的训练基础。
实际应用
在实际产业应用中,基于该数据集微调的Marketing-Llama-3.3-70B模型在广告创意生成、电商产品详情页自动编写、电子邮件营销序列设计以及社交媒体内容批量生产等场景中均展现出显著效能。例如,品牌团队可利用模型快速生成符合指定语调的多版本广告文案,大幅降低了人工撰写的重复性劳动;电商运营者能够基于产品属性结构化输入自动产出高质量描述文本,提升商品上架效率。该数据集尤适用于需要规模化持续产出营销内容的SaaS平台和数字营销代理机构。
衍生相关工作
marketing-instruct-13k作为系列数据集的延续与扩展,直接催生了Marketing-Llama-3.3-70B这一在营销文案生成基准上实现88%胜率的微调模型,成为AutoScientist Challenge 2026营销赛道的重要技术支撑。其前序版本marketing-instruct-4k与marketing-instruct-8k则构成了实验对比的基线,为研究人员探讨数据集规模、任务平衡性与模型泛化能力之间的关系提供了连贯的实证线索。此外,该数据集所采用的跨来源融合、AdaptData自动化适配与合成数据扩展等构建方法,也为后续营销领域指令数据集的设计范式积累了方法论经验。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

