遇见数据集

ovos-wake-word-bench-mlsw-negatives-pt-PT

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

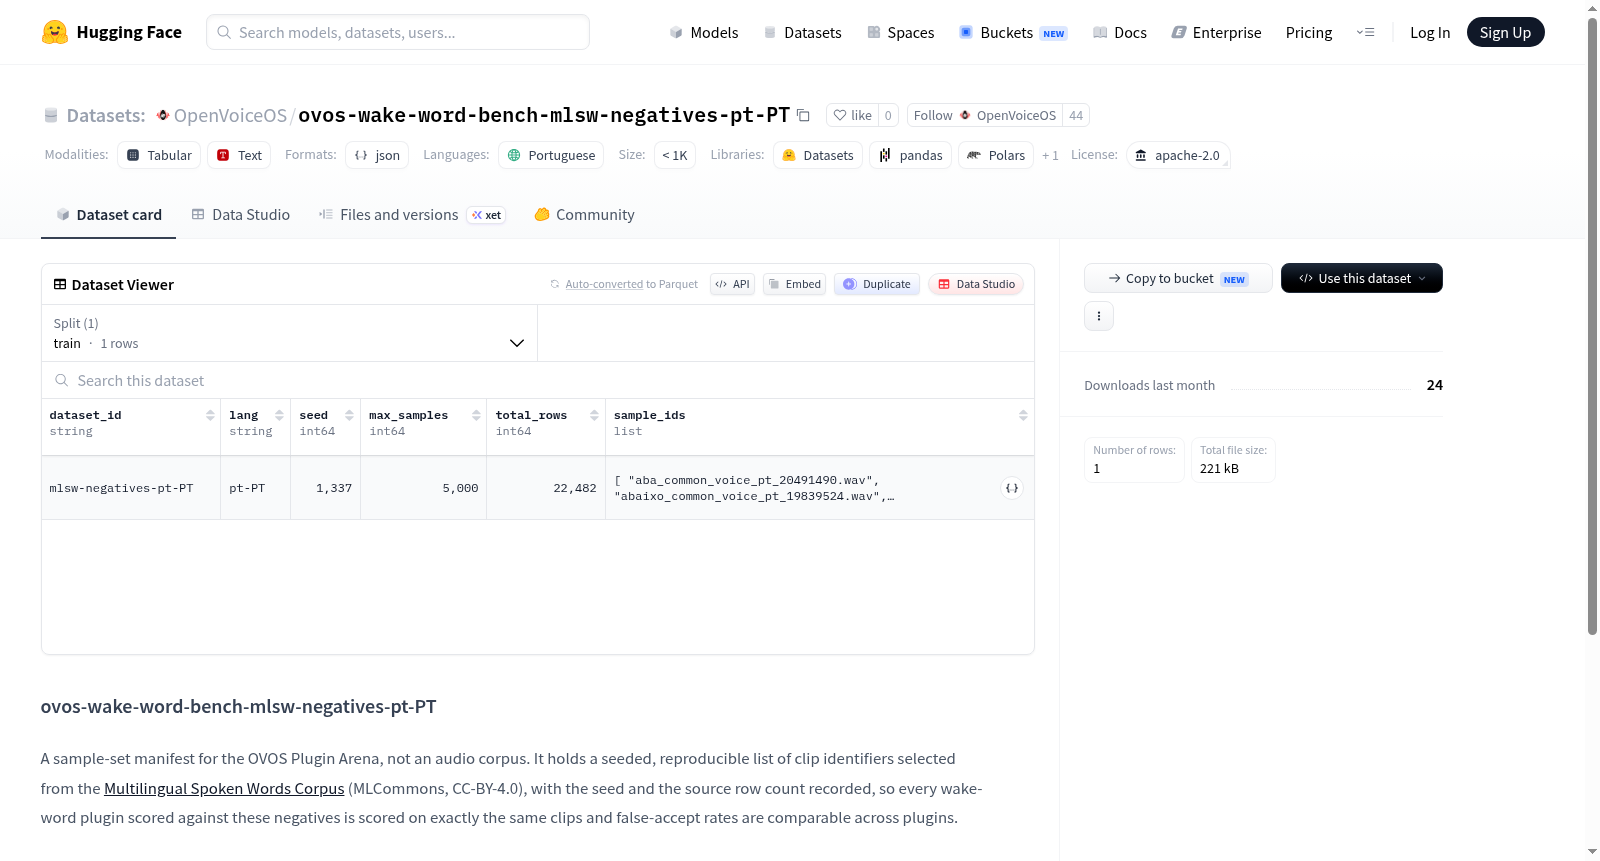
该数据集是OVOS唤醒词插件竞技场(OVOS Plugin Arena)的一个负样本清单,而非音频语料库。它包含从Multilingual Spoken Words Corpus(MLCommons, CC-BY-4.0)中经种子随机选取的剪辑标识符列表,并记录了种子和源行数,以确保不同唤醒词插件在完全相同的一组剪辑上进行评分,从而使假接受率具有可比性。音频文件未重新分发,仍保留在原始数据集中。该清单以Apache-2.0许可证发布,与竞技场其他基准测试仓库一致。数据集语言为葡萄牙语(欧洲葡萄牙语)。

This dataset is a negative sample list for the OVOS Wake Word Plugin Arena, not an audio corpus. It contains clip identifiers randomly selected from the Multilingual Spoken Words Corpus (MLCommons, CC-BY-4.0) with seeds and source row counts, ensuring that different wake word plugins are scored on the exact same set of clips for comparable false acceptance rates. Audio files are not redistributed and remain in the original dataset. The list is released under the Apache-2.0 license, consistent with other benchmark repositories in the arena. The dataset language is Portuguese (European).

创建时间:
2026-09-02
原始信息汇总

数据集概述

该数据集为 ovos-wake-word-bench-mlsw-negatives-pt-PT,由 OpenVoiceOS 发布,遵循 Apache-2.0 许可证,语言为葡萄牙语(pt)。

核心性质

  • 这是一个 样本清单(manifest),并非音频语料库本身,用于 OVOS 插件竞技场(Plugin Arena)的基准测试。
  • 它包含从 多语言口语词语库(Multilingual Spoken Words Corpus,MLCommons,CC-BY-4.0) 中选出的、可复现的片段标识符列表,并记录了随机种子和源数据行数。

用途与技术细节

  • 旨在确保所有唤醒词插件在评估时使用完全相同的负面样本片段,从而使得不同插件之间的误接受率(false-accept rate)具有可比性
  • 音频内容不在此数据集中重新分发,仍托管于 MLCommons 平台,并遵循其自身的许可和署名条款。

附加信息

  • 测试结果页面:https://openvoiceos.github.io/ovos-plugin-arena/
  • 清单格式规范:见 https://github.com/OpenVoiceOS/ovos-plugin-arena 中的 docs/SPECIFICATION.md 文件。
搜集汇总
数据集介绍
ovos-wake-word-bench-mlsw-negatives-pt-PT 数据集图片
构建方式
本数据集为OVOS插件竞技场量身打造,并非音频实体库,而是作为样本清单存在。其构建精髓在于从MLCommons的多语种口语词汇语料库中,依据设定种子,精准筛选出可复现的剪辑标识序列。此过程详细记录了随机种子与源数据行数,确保了每次针对该负样本集进行唤醒词插件评测时,所使用的音频剪辑完全一致,从而保障了不同插件间误唤醒率对比的公平性与可靠性。音频本体并未随清单重新分发,而是保留在MLCommons原始许可框架内,本清单则以Apache-2.0许可发布,与竞技场其他基准仓库保持一致。
特点
该数据集最显著的特征在于其作为基准测试的严谨性与可比性。它提供了一个经过种子固定的、确定性的负面样本集合,使得任何唤醒词插件在这些样本上的表现都能直接进行横向比较。其设计哲学强调评估流程的标准化,通过精确控制测试音频的选取,消除了因样本差异导致的性能波动,使得误唤醒率成为衡量插件鲁棒性的纯净指标。此外,数据集严格遵守知识产权规范,采用清单而非音频副本的形式,体现了对原语料库许可条款的尊重,同时以Apache-2.0许可发布,促进了学术与工业界的开放合作。
使用方法
使用本数据集时,开发者需访问OVOS插件竞技场文档,依据规范将清单文件集成至评测流程。具体而言,可加载清单中列出的剪辑标识,并从MLCommons多语种口语词汇语料库中获取对应音频,用于测试唤醒词插件在葡萄牙语环境下的负面样本表现。评测结果可提交至公开榜单,实现跨插件的性能对比。该清单文件与详细规格说明位于官方GitHub仓库,确保了使用流程的透明性与可复现性,适用于推动唤醒词技术在多语种场景下的优化与迭代。
背景与挑战
背景概述
随着智能语音交互技术的蓬勃发展,唤醒词系统作为人机对话的初始门户,其性能评估愈发受到学术界与工业界的重视。然而,跨语言、多场景下的唤醒词误唤醒率评测因缺乏标准化基准而面临挑战。在此背景下,OpenVoiceOS 团队于近年创建了 ovos-wake-word-bench-mlsw-negatives-pt-PT,该数据集源自 MLCommons 的 Multilingual Spoken Words Corpus,为葡萄牙语(欧洲)的唤醒词插件竞技场提供标准化的负样本清单。其核心研究问题聚焦于构建可复现、可比较的唤醒词误接受率测试环境,通过记录固定的音频片段选择种子与源数据行数,确保不同插件在相同条件下接受评估。该基准为 OVOS Plugin Arena 生态做出了贡献,促进了多语言语音助手唤醒模块的公平对比与迭代发展。
当前挑战
该数据集所应对的领域挑战在于解决唤醒词误接受率评估的公平性与可复现性问题,因不同测试样本集或随机采样会引入评估偏差,致使插件性能可比性受损。此外,语料库的异构性(如口音、录制环境)加剧了评估的复杂性,要求基准在保证多样性的同时兼顾一致性。在构建过程中,首要难题是确定合适的采样策略以代表葡萄牙语语音的广阔分布,同时避免版权争议——数据集本身仅提供样本标识清单,而非音频内容,需在合规前提下确保清单能忠实映射原始语料。种子值的选择与记录需要谨慎,以防因采样逻辑缺陷导致评估结果偏倚。最终,维护清单与源数据的同步更新,以及支撑多样插件的高效评测,构成了持续性的工程挑战。
常用场景
经典使用场景
在语音交互系统的研发征途中,唤醒词检测作为人机对话的起始闸门,其性能优劣直接关乎用户体验的流畅性与智能设备的响应敏锐度。该数据集以精密的清单形式,划定了从多语种口语词语语料库中筛选出的负面样本集合,为唤醒词插件的基准测试构筑了标准化的评估基石。其核心应用场景在于对各类唤醒词检测插件进行统一的、可复现的误唤醒率度量,确保不同系统在相同音频片段上的对比公平性。通过种子机制确保样本选取的可重复性,该清单为学术界与工业界提供了一个严谨的对照实验环境,使得唤醒词算法的精进不再是孤立的、主观的,而是建立在客观、可量化、可横向比较的坚实数据之上。
衍生相关工作
依托于此基准清单,一系列衍生工作得以蓬勃开展。首先,该数据集直接支撑了OVOS Plugin Arena的持续集成体系,使得多款唤醒词插件在统一标准下的性能排行榜成为社区参考的权威依据,激发了围绕特征提取、模型架构与决策阈值调优的诸多改进型研究。其次,该清单的发布模式启发了其他语言与场景的负面样本基准构建,推动了跨语言唤醒词测评规范的初步形成。再者,研究者可结合该清单与正面样本集,开展关于领域自适应、噪声鲁棒性以及轻量化模型剪枝的深度探索,将误唤醒率的降低作为核心优化目标,进而催生出一系列基于此数据集的高效语音交互前端解决方案,为端侧智能语音代理的进一步发展奠定了评测方法论层面的重要基础。
数据集最近研究
最新研究方向
该数据集聚焦于多语言唤醒词系统公平性评测的前沿方向,通过引入种子化、可复现的负样本清单,为OVOS插件竞技场提供了标准化的干扰项选择方案。这一举措顺应了智能语音助手在多语言场景下对误唤醒率精确量化的迫切需求,尤其针对葡萄牙语(pt-PT)环境,旨在解决不同唤醒词插件在相同音频条件下性能可比性缺失的痛点。数据集依托大规模多语种语音语料库,精心筛选并记录采样规则,确保了跨插件测试的一致性,从而有效遏制虚假接受率的偏差,推动开放语音生态中唤醒词技术的稳健发展。其意义在于为社区树立了严谨的评测基准,促进插件良性竞争,进而提升多语种用户的交互体验与安全性。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务