
c_dfiltered_science_DeepSeek-R1-Distill-Qwen-14B_mneutral_add_random_text_t30
收藏数据链接:
官方服务:
资源简介:
该数据集包含了问题、答案内容、参考答案、问题来源、模型名称、验证者分数、变异答案内容以及多个延续内容和对应的完整答案等字段。数据集仅包含训练集部分,并提供了数据集的大小和示例数量信息。
This dataset includes multiple fields such as questions, answer content, reference answer, question source, model name, validator score, variant answer content, as well as multiple continuation contents and their corresponding complete answers. This dataset only contains the training split, and provides information about the dataset size and the number of examples.
创建时间:
2025-08-02
原始信息汇总
数据集概述
基本信息
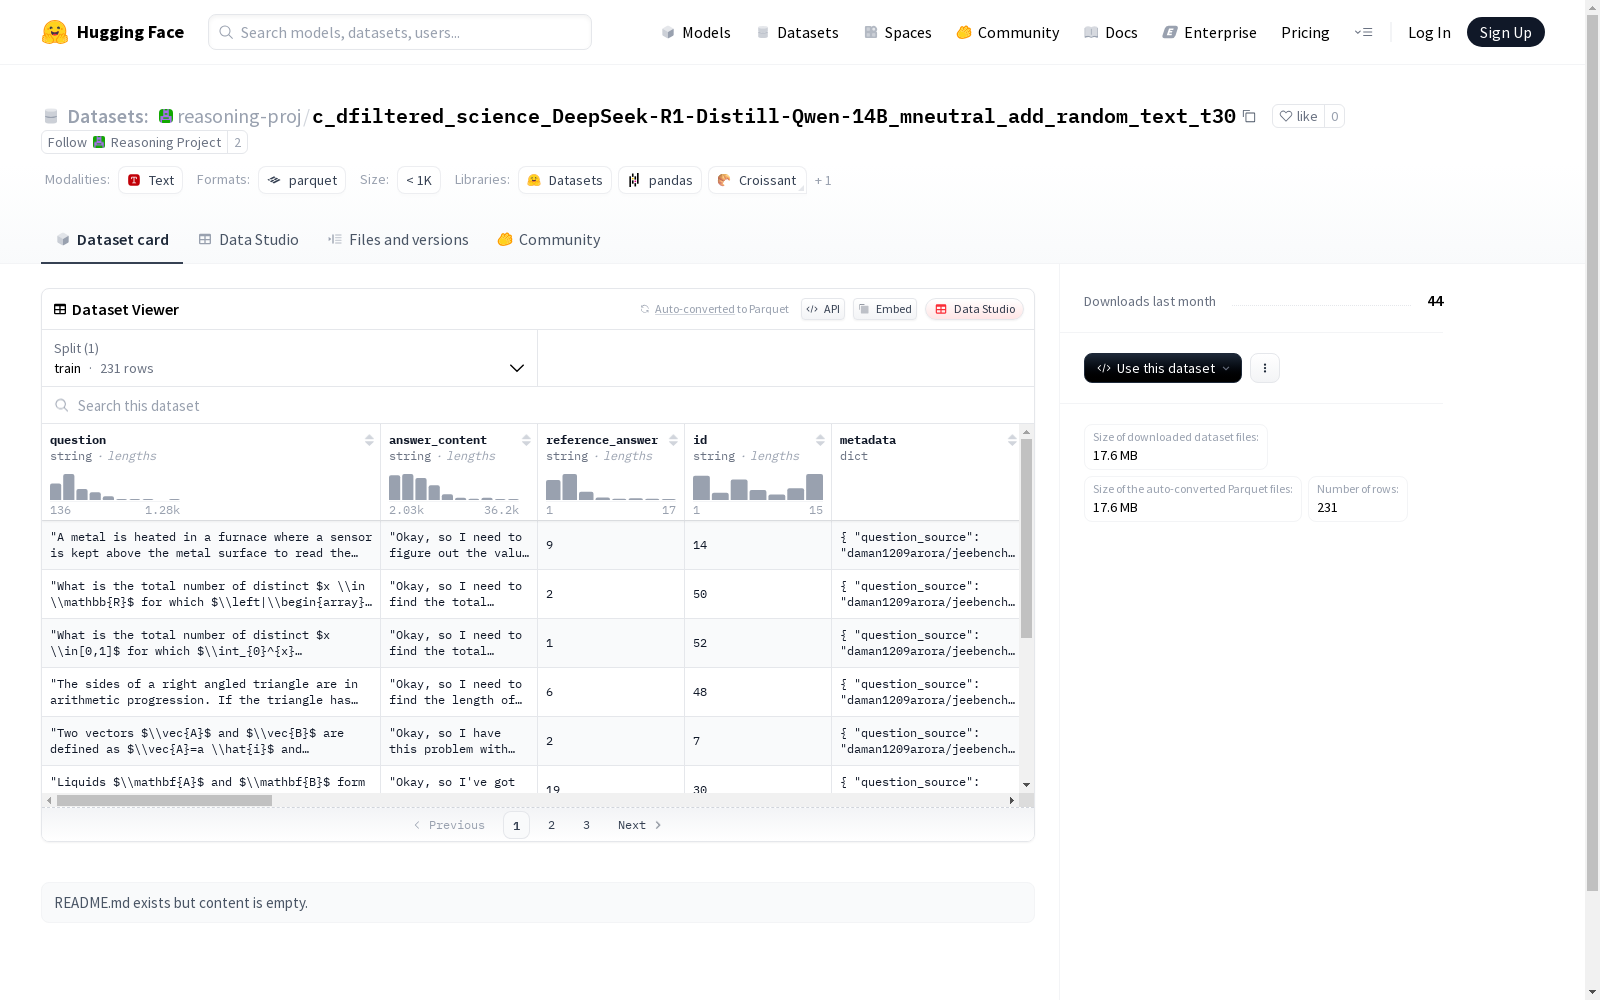
- 数据集名称: reasoning-proj/c_dfiltered_science_DeepSeek-R1-Distill-Qwen-14B_mneutral_add_random_text_t30
- 下载大小: 17,599,577 字节
- 数据集大小: 47,513,428 字节
- 训练集样本数: 231 个
数据集特征
- question: 字符串类型,表示问题内容。
- answer_content: 字符串类型,表示回答内容。
- reference_answer: 字符串类型,表示参考回答。
- id: 字符串类型,表示唯一标识符。
- metadata: 结构体类型,包含以下字段:
- question_source: 字符串类型,表示问题来源。
- model_name: 字符串类型,表示模型名称。
- verifier_score: 整型,表示验证分数。
- mutated_answer_content: 字符串类型,表示变异后的回答内容。
- continuation_1 到 continuation_8: 字符串类型,表示连续回答部分。
- complete_answer_1 到 complete_answer_8: 字符串类型,表示完整回答部分。
- continuation_model: 字符串类型,表示连续回答模型。
数据集配置
- 默认配置:
- 数据文件:
- 训练集路径:
data/train-*
- 训练集路径:
- 数据文件:
搜集汇总
数据集介绍
构建方式
该数据集通过深度知识蒸馏技术构建,以Qwen-14B模型为基础生成科学领域的问答数据。原始问题来源于专业科学领域,经过模型生成初始回答后,采用多轮续写策略产生8种不同变体,每轮续写均由特定模型完成。数据构建过程中引入随机文本干扰机制(t30参数),并经过严格的验证评分体系筛选,确保数据质量与多样性。
使用方法
该数据集适用于科学问答系统的性能评估与改进研究,研究者可通过对比不同续写变体分析模型输出稳定性。验证分数可作为自动评估指标开发的基准,多轮续写数据适合用于模型微调与知识蒸馏。使用时应关注metadata中的问题来源字段以追溯原始语境,verifier_score字段可帮助筛选高质量样本。数据加载可直接通过HuggingFace数据集库完成,47.5MB的训练集包含全部231个样本。
背景与挑战
背景概述
数据集c_dfiltered_science_DeepSeek-R1-Distill-Qwen-14B_mneutral_add_random_text_t30由DeepSeek团队构建,旨在推动科学问答领域的研究。该数据集基于Qwen-14B模型进行知识蒸馏,并融合了多种科学问题的回答变体,为自然语言处理领域提供了丰富的训练资源。其核心研究问题聚焦于如何通过多轮回答生成和验证机制提升模型在科学问答任务中的准确性和鲁棒性。该数据集的构建体现了当前大模型时代对高质量、多样化训练数据的迫切需求,为后续研究提供了重要的基准。
当前挑战
该数据集面临的主要挑战体现在两个方面:在领域问题层面,科学问答需要处理复杂的专业术语和逻辑推理,如何确保生成答案的准确性和科学性成为关键难题;在构建过程中,多轮回答的生成与验证需要平衡多样性和质量,同时处理大规模数据的标注和一致性校验也带来了显著的技术挑战。此外,知识蒸馏过程中的信息损失问题以及中立性文本的生成控制,都对数据集的构建提出了更高要求。
常用场景
经典使用场景
在自然语言处理领域,c_dfiltered_science_DeepSeek-R1-Distill-Qwen-14B_mneutral_add_random_text_t30数据集被广泛应用于问答系统的性能评估与优化。该数据集通过提供多轮对话的延续内容,为研究者提供了丰富的上下文信息,使得模型能够在复杂的对话场景中进行更精准的应答生成。其经典使用场景包括对话系统的延续性测试、多轮对话的连贯性分析以及模型生成答案的多样性评估。
解决学术问题
该数据集有效解决了对话系统中答案生成的一致性与多样性之间的平衡问题。通过提供多个可能的对话延续路径,研究者可以深入探讨模型在不同上下文环境下的应答策略,从而优化生成内容的准确性与自然度。此外,数据集中的验证分数为评估模型性能提供了量化指标,助力于对话系统领域的学术研究。
实际应用
在实际应用中,该数据集为智能客服、虚拟助手等对话系统提供了重要的训练与测试资源。通过利用数据集中的多轮对话延续内容,开发者能够显著提升系统在复杂对话场景中的应答能力,改善用户体验。其多样化的对话路径也为系统应对用户不同提问方式提供了丰富的参考。
数据集最近研究
最新研究方向
在自然语言处理领域,基于大模型生成的数据集正逐渐成为研究热点。c_dfiltered_science_DeepSeek-R1-Distill-Qwen-14B_mneutral_add_random_text_t30数据集以其独特的结构和丰富的内容,为研究者提供了探索模型生成能力与答案多样性之间关系的新视角。该数据集通过多轮续写和完整答案的对比,为评估模型在不同上下文中的表现提供了基准。近期研究聚焦于如何利用此类数据集优化模型的知识蒸馏过程,特别是在科学问答任务中提升生成答案的准确性和连贯性。与此同时,该数据集也被用于探索模型在生成过程中引入随机文本对最终输出的影响,为理解模型的鲁棒性和创造性提供了实验基础。这些研究方向不仅推动了对话系统和问答技术的进步,也为大模型在实际应用中的可靠性评估提供了重要参考。
以上内容由遇见数据集搜集并总结生成


