
遇见数据集

nineninesix/diamond-benchmark

收藏
Hugging Face2026-07-15 更新2026-07-22 收录
官方服务:

资源简介:

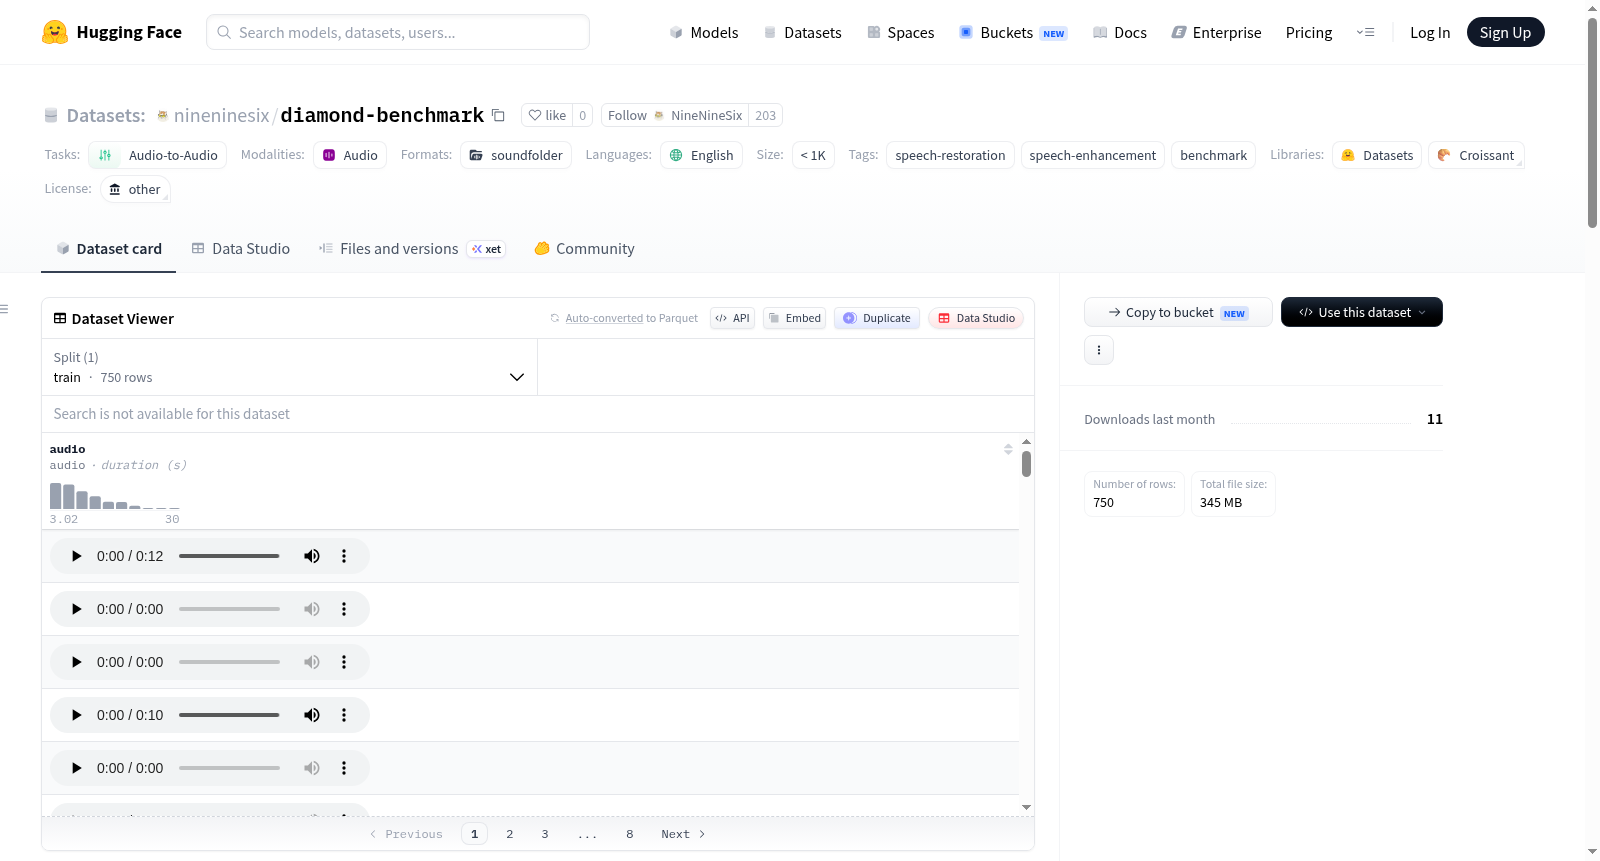
Diamond Benchmark是一个包含750个真实降质语音录音的数据集,用于评估语音恢复模型的性能。这些录音是真实降质的语音,而非合成或通过管道重新降质的干净音频。每个录音都带有实际捕获中的损伤,如低比特率编解码压缩、窄带宽、背景噪声和削波。数据集提供了一个固定基准,用于测量语音恢复模型从真实降质中恢复干净、工作室质量音频的能力。每个录音都附有参考文本,因此可以在感知质量和内容保存两个轴上同时评分。数据集包括750个降质的.wav录音,语言为英语,结构包含音频文件和manifest.csv元数据文件,其中包含集合、ID、原始录音ID、音频路径、采样率、时长、说话者和文本等列。评分使用DNSMOS-P.835(感知质量)和CER(内容保存)两个互补指标。

Diamond Benchmark is a dataset containing 750 real degraded speech recordings for evaluating speech restoration models. These are real, genuinely degraded speech recordings — not synthetic, not clean audio re-degraded by a pipeline. Each clip carries the damage of an actual real-world capture: low-bitrate codec compression, narrow bandwidth, background noise, and clipping. Together they form a fixed benchmark for measuring how well a speech-restoration model recovers clean, studio-quality audio from real degradation. Every clip ships with its reference transcript, so restoration can be scored on two axes at once — perceptual quality and content preservation. The dataset includes 750 degraded .wav recordings in English, structured with audio files and a manifest.csv metadata file containing columns such as set, id, emolia_id, audio_path, sample_rate, duration_sec, speaker, and text. Scoring uses two complementary metrics: DNSMOS-P.835 (perceptual quality) and CER (content preservation).
提供机构:
nineninesix
搜集汇总
数据集介绍
nineninesix/diamond-benchmark 数据集图片
构建方式
Diamond Benchmark 数据集由750段真实环境下采集的退化语音录音构成,这些录音并非通过模拟管道对纯净音频进行再处理,而是直接源自实际场景中的低比特率编解码压缩、窄带宽限制、背景噪声及削波失真。每段音频均附有对应的参考转录文本,以构成一个固定的评估基准,用于衡量语音恢复模型从真实退化中复原干净录音室级音频的能力。
特点
该数据集的核心特点在于其真实性——所有退化痕迹均来自真实世界捕获,而非人工合成。评估采用双轴互补指标:DNSMOS-P.835用于量化感知质量,涵盖信号、背景和整体三个维度;CER用于衡量内容保真度,通过ASR转录与参考文本对比实现。这种设计确保了模型在提升听觉质量的同时不会牺牲词汇的完整性。
使用方法
使用者可通过Hugging Face的`snapshot_download`函数下载完整数据集,并利用`pandas`读取`manifest.csv`元数据文件。该文件记录了每个音频的源子集、ID、采样率、时长、说话人及参考文本。加载时只需调用`soundfile`库即可获取波形与采样率,进而基于DNSMOS和CER指标对任意语音恢复模型进行标准化评估。
背景与挑战
背景概述
在语音信号处理领域,真实场景下的语音退化问题一直是制约语音恢复模型性能提升的关键瓶颈。现有评估基准多采用合成退化数据,难以反映实际应用中复杂多变的声学环境。为填补这一空白,Diamond Benchmark于近期由研究团队nineninesix构建并发布,专注于提供750条真实退化的英语语音片段,涵盖低比特率编解码、窄带宽、背景噪声及削波等多种退化类型。该数据集的核心研究问题在于评估语音恢复模型在真实退化条件下的感知质量与内容保真度,推动模型从实验室理想条件向真实部署场景的迁移。通过引入DNSMOS与CER双重评估指标,Diamond Benchmark为语音恢复领域树立了更贴近实际应用的评测标杆,对推动该领域技术的实用化发展具有重要意义。
当前挑战
Diamond Benchmark所解决的领域核心挑战是真实世界中语音退化模式的多样性与不可预测性,这远超合成退化数据的模拟范围,导致现有模型在真实场景下泛化能力严重不足。在构建过程中,主要挑战包括:首先,采集真实退化语音需要精心设计多源采集流程,确保退化来源的真实性与代表性,而非通过后处理模拟;其次,为每条退化片段提供精准参考转录文本,以支持内容保真度评估,这对标注精度提出极高要求;再者,需要在有限的750条样本上构建稳定且可重复的评测方案,避免样本量不足导致的统计偏差,同时平衡感知质量与内容保持两方面的评估权重,以客观反映模型的真实恢复能力。
常用场景
经典使用场景
Diamond Benchmark数据集专为评估语音修复模型的性能而设计,其核心使用场景在于衡量模型从真实退化语音中恢复高质量音频的能力。该数据集包含750个真实采集的退化语音片段,涵盖了低比特率编解码压缩、窄带宽、背景噪声和削波等多种实际损伤类型,而非人工合成的模拟数据。研究者可利用这些片段,通过DNSMOS-P.835指标评估感知质量(包括信号质量、背景噪声和整体评分),同时结合字符错误率(CER)衡量内容保留程度,从而全面检验模型的修复效果。这一双维度评估体系确保了模型在提升听感的同时不牺牲语音内容的准确性,特别适用于对比不同语音修复算法在真实退化场景下的优劣表现。
衍生相关工作
Diamond Benchmark的发布催生了一系列围绕真实退化语音修复的衍生研究工作。首先,其官方配套模型Diamond-1.0作为基于该基准的基线系统,展示了如何联合优化感知质量与内容保真度,为后续模型设计提供了参照框架。其次,该数据集的评估协议已经融入到DNSMOS和CER联合评价的学术讨论中,促使研究者开发更合理的语音修复评价指标。此外,该基准启发了更多针对特定退化类型(如非平稳噪声或极端带宽限制)的修复方法研究,部分工作进一步扩展了数据集规模或涵盖了多语种内容。还有学者基于该基准的元数据信息,探索了退化类型对修复模型性能的精细影响,从而指导更自适应的修复策略设计。
数据集最近研究
最新研究方向
在语音修复与增强领域,Diamond Benchmark的发布标志着评估体系从合成退化向真实世界退化的关键跃迁。当前前沿研究聚焦于利用该750条真实受损语音样本集,联合DNSMOS感知质量与CER内容保真度双指标,系统性地检验生成式修复模型在低码率编解码、窄带宽、背景噪声及削波等复合真实退化场景下的鲁棒性。这一基准的诞生呼应了业界对脱离模拟管道、拥抱真实声学环境评估的迫切需求,尤其为衡量模型在恢复自然听感时不扭曲语义信息设立了严苛门槛,对推动语音交互系统在嘈杂通话、录音异常等高频热点场景中的实用化落地具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

