Persona-E2-Dataset
收藏资源简介:
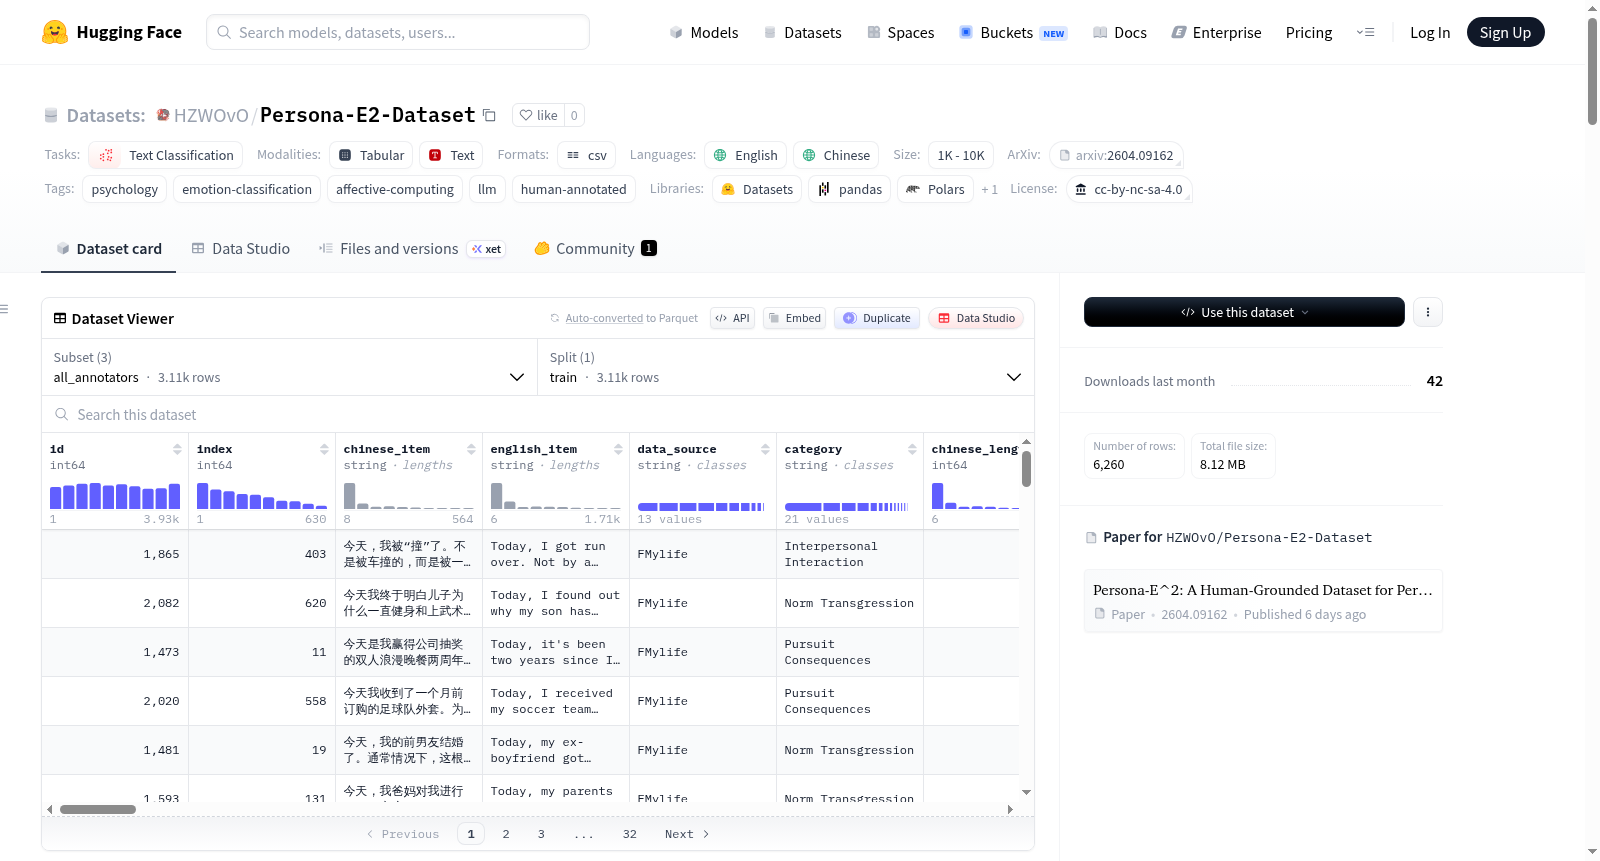
Persona-E²(Persona-Event2Emotion)是一个大规模、基于人类标注的数据集,旨在弥合人格特质与情感评估之间的鸿沟。与传统情感计算研究不同,Persona-E²强调读者的视角,捕捉个体倾向如何导致对同一刺激的不同情感反应。数据集包含3,111个经过筛选的事件,每个事件由36名标注者独立盲标,共计111,996个高质量标注。标注者通过Myers-Briggs Type Indicator (MBTI)和Big Five Inventory (BFI)进行了全面的人格分析。数据集涵盖新闻、社交媒体和生活经验三个主要领域,并引入了Group Consensus Score (S_consensus)和Subjective Divergence Subset (SDS)等高级指标。数据集结构包括三个核心CSV文件:1_dataset_all_annotators.csv(所有标注者的原始情感标注)、2_dataset_group_consensus.csv(基于BFI的人格聚类情感标注)和3_annotator_profiles.csv(标注者的人口统计和人格档案)。数据集适用于情感分类、人格计算和LLM评估等任务,遵循CC BY-NC-SA 4.0许可,仅限学术研究使用。
Persona-E² 数据集概述
数据集基本信息
- 数据集名称:Persona-E² (Persona-Event2Emotion)
- 语言:英语 (en)、中文 (zh)
- 许可证:CC BY-NC-SA 4.0
- 任务类别:文本分类
- 标签:心理学、情感分类、情感计算、大语言模型、人工标注
- 规模类别:100K < n < 1M
- 配置:
all_annotators:数据文件为1_dataset_all_annotators.csvgroup_consensus:数据文件为2_dataset_group_consensus.csvannotator_profiles:数据文件为3_annotator_profiles.csv
- 数据量:111,996 条高质量标注
- 联系方式:ftyuqin_yang@mail.scut.edu.cn
- 论文:https://arxiv.org/abs/2604.09162
- 项目主页:https://scut-hai.github.io/Persona-E2/
数据集简介
Persona-E² 是一个大规模、以人为中心的数据集,旨在连接人格特质与情感评估。该数据集关注读者的视角,捕捉个体倾向如何导致对同一刺激产生不同的情感反应,为评估大语言模型是否能真正捕捉特质驱动的情绪多样性提供了严格的基准。
核心特征
- 高标注密度:数据集中的每个事件均由 36 位标注员 独立盲标,总计 111,996 条高质量标注。
- 全面的人格画像:标注员使用 迈尔斯-布里格斯类型指标 和 大五人格量表 进行画像。
- 跨领域多样性:数据集涵盖三个主要领域,包含 3,111 个经过筛选的事件:新闻、社交媒体 和 生活经历。
- 高级指标与 SDS:引入了基于归一化熵的 群体共识分数 以验证标签。数据集还包含一个 主观分歧子集,由 413 个高度争议的事件组成,突显了情感反应明确但严重受人格影响的场景。
数据结构
数据集包含 3 个核心 CSV 文件。
1. 1_dataset_all_annotators.csv
包含全部 3,111 个事件以及来自所有 36 位参与者的原始细粒度情感标注。 主要列包括:
id/index:文本事件的唯一标识符。chinese_item/english_item:事件的双语文本。data_source:原始平台。category:细粒度语义子类别。top1_emotion:普通读者多数投票的情感。emotion_distribution:情感概率分布的 JSON 字符串。E[1-36]_emo:参与者 E1 到 E36 标注的具体情感。E[1-36]_confidence:自报告的情感置信度分数 (1-5)。
2. 2_dataset_group_consensus.csv
将个体标注聚合为 6 个基于 BFI 的不同人格聚类,以追踪组内一致性。 主要列包括:
g[1-6]_emo:特定人格组 (g1 到 g6) 内的主导情感标签。g[1-6]_members:此聚类中的具体标注员 ID。g[1-6]_consensus_score:群体共识分数。
3. 3_annotator_profiles.csv
包含所有 36 位标注员的匿名化人口统计信息和全面人格画像。 主要列包括:
ID:匿名标识符 (E1 到 E36)。GNDR:标注员性别 (M/F)。MBTI:16 种迈尔斯-布里格斯分类。Open. / Cons. / Extra. / Agree. / Neuro.:大五人格量表分数,归一化到连续范围 [0.0, 1.0]。
事件来源与统计
为构建多样且全面的数据集,数据来源于新闻、社交媒体讨论和特定生活经历叙述等不同渠道。
| 领域 | 来源 | 链接 | Cutoff | 数量 |
|---|---|---|---|---|
| 新闻 | ABC_news | https://abcnews.go.com/abcnews | 3.5 | 130 |
| 新闻 | BBC_news | https://www.bbc.com/ | 3.5 | 248 |
| 新闻 | Independent | https://www.independent.co.uk/news | 3.5 | 36 |
| 新闻 | Today | https://tophub.today/c/tech | 4.0 | 314 |
| 新闻 | The Paper | https://tophub.today/c/tech | 4.0 | 273 |
| 新闻 | https://weibo.com/u/2656274875 | 4.0 | 478 | |
| 新闻 | https://tophub.today/c/tech | 4.0 | 37 | |
| 社交媒体 | SocialChem | - | 4.0 | 416 |
| 社交媒体 | https://www.reddit.com/ | 4.7 | 440 | |
| 生活经历 | B.E. | https://www.reddit.com/r/BenignExistence/ | 4.0 | 140 |
| 生活经历 | FMylife | https://www.fmylife.com/ | 4.0 | 507 |
| 生活经历 | IUTB | http://iusedtobelieve.com/ | 4.0 | 26 |
| 生活经历 | KindLife | https://www.randomactsofkindness.org/kindness-stories | 4.0 | 66 |
收集与标注方法
- 三阶段事件筛选:初始超过 76,000 个事件经过严格筛选:内容安全过滤 -> 多维度 LLM 评分 -> 专家验证。
- 受控的人工标注:36 位筛选过的参与者通过定制在线平台独立标注所有最终确定的事件。
- 伦理与隐私:整个实验方案,包括个人身份信息匿名化和公平劳动报酬,均经过机构审查委员会审查和批准。
快速开始
可以使用 pandas 和 seaborn 加载和探索数据集。
许可证与使用限制
本数据集根据 知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议 发布。
- 仅限学术使用:仅限于纯学术研究、教育目的和非商业模型对齐实验。
- 相同方式共享:如果您混合、转换或基于本材料创作,您必须在相同许可下分发您的贡献。
- 禁止商业画像:禁止用于训练旨在监控、画像或操纵真实用户心理特征的商业产品。
引用
如果在研究中使用 Persona-E²,请引用我们的 ACL 论文。