
遇见数据集

biglam/muninn-ww1-documents

收藏
Hugging Face2026-07-19 更新2026-07-22 收录
官方服务:

资源简介:

该数据集是Muninn项目第一次世界大战关联开放数据档案中文档记录的表格转换。Muninn项目是一个研究项目,从数字化的一战时期档案文件中提取结构化数据。数据集涵盖28,742份文档——包括28,718份加拿大远征军(CEF)入伍文件(士兵个人入伍表格)和24份加拿大部队战争日记——以及它们在加拿大图书馆和档案馆(LAC)保存的58,286页和74,616页扫描图像。该数据集为BigLAM倡议创建,通过将Muninn RDF数据转储转换为平面表格而成。数据集包含三个配置:documents(每行代表一个档案文档)、pages(每行代表一个扫描页)和images(每行代表一个扫描图像文件)。图像未捆绑在存储库中,而是通过URL指向LAC服务器上的原始扫描。可用于历史表格分类、手写/打字文本识别和历史命名实体研究等任务。

A tabular conversion of the document records in the Muninn Projects World War I Linked Open Data archive. The Muninn Project is a research project that extracts structured data from digitized WWI-era archival documents. The dataset covers 28,742 documents — 28,718 Canadian Expeditionary Force (CEF) attestation papers (enlistment forms of individual soldiers) and 24 Canadian unit war diaries — together with their 58,286 pages and 74,616 page-scan images held by Library and Archives Canada (LAC). It was created for the BigLAM initiative by converting the Muninn RDF data dump into flat tables. The dataset includes three configs: documents (one row per archival document), pages (one row per scanned page), and images (one row per scan image file). Images are not bundled in the repository; image_url points to original scans on LAC servers. Example uses include document-type and country-of-origin classification, handwritten/typewritten text recognition, and historical named-entity research.
提供机构:
biglam
搜集汇总
数据集介绍
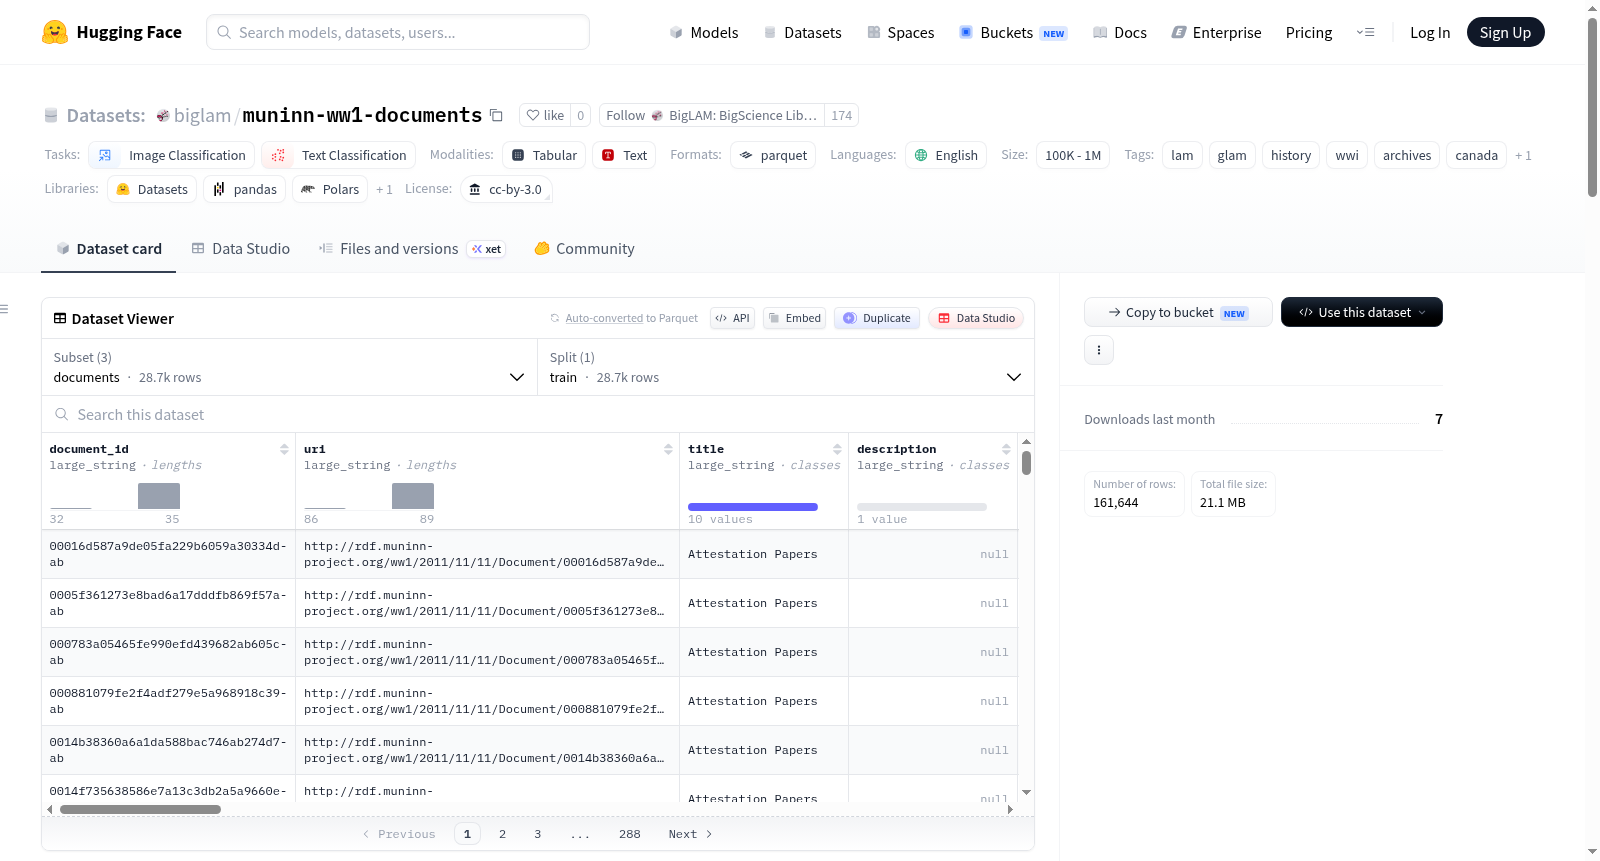
biglam/muninn-ww1-documents 数据集图片
构建方式
该数据集源于Muninn项目所构建的第一次世界大战关联开放数据档案,以结构化表格形式呈现了加拿大远征军士兵入伍登记表与作战日志等历史文献。在Muninn SPARQL端点已不可用的情况下,研究者通过解析其2016年发布的VoID数据转储文件(约380万条SPARQL-XML格式的声明),利用定制的提取与建表脚本,筛选相关谓词并重组文档、页面与图像之间的层级关联。借助Muninn文档本体中的包含关系与前后页链接,还从组织及军事本体中解析出人员姓名与出生日期,最终生成三个分立的Parquet表格,实现了从原始RDF三元组到平面数据的精确转换。
特点
本数据集覆盖28,742份档案文献,包括28,718份加拿大远征军士兵入伍登记表与24份作战日志,关联的58,286个扫描页面及74,616张图像文件均指向加拿大图书馆与档案馆的原始数字副本。数据以文档、页面、图像三个层次组织,文档层完整记录了士兵姓名、出生日期、所属部队等结构化元数据,页面层提供序数与前后页指针,图像层则包含格式、尺寸与版权状态。值得关注的是所有条目均标记为公共领域,且绝大部分士兵的出生日期覆盖率达99.8%,为历史文本分析提供了丰富而可靠的弱标注信息。
使用方法
该数据集可通过HuggingFace Datasets库直接加载,支持documents、pages、images三个配置选项,分别对应档案级、页面级与图像级的表格化数据。适用于历史文档类型与来源国的图像分类任务,例如从页面扫描中识别加拿大来源的入伍登记表。亦可借助士兵姓名、出生日期等结构化工件,作为手写或打字文本识别任务的弱监督真值,用于二十世纪早期表格文档的转录。此外,对于一战人事档案的命名实体识别与记录链接研究,该数据集同样提供了规整且丰富的关联数据基础。
背景与挑战
背景概述
该数据集名为“Muninn WWI Documents”,由Muninn项目与BigLAM倡议于2026年联合创建,旨在将一战时期加拿大远征军(CEF)的入伍登记表与战争日记等历史档案的结构化元数据,从关联数据(Linked Open Data)格式转化为易于使用的表格化数据集。数据集涵盖28,742份文档、58,286页及74,616张扫描图像,由加拿大图书馆与档案馆(LAC)托管。其核心研究问题在于为历史档案的数字化分析提供高质量、可复用的结构化数据,推动大规模历史文献的图像分类、文本识别及实体链接研究,对数字人文学科与文化遗产数据开放运动具有重要影响力。
当前挑战
该数据集面临多重挑战。在领域问题层面,一战档案多为手写体与早期打字机文本,字迹潦草、格式不统一,导致光学字符识别(OCR)与手写文本识别(HTR)难度极高;同时,文档类型多样(如入伍登记表与战争日记),需设计鲁棒的图像分类模型以区分来源与版式。在构建过程中,Muninn项目原本的SPARQL端点已失效,仅能依赖2016年发布的截断数据转储,约20M的三元组仅保留部分记录,导致数据集仅为完整知识库的子集;此外,扫描图像未打包于数据集中,需动态从LAC服务器获取,网络依赖性强且链接可能随维护而失效。
常用场景
经典使用场景
在历史文献数字化与自然语言处理的交叉领域中,Muninn WWI Documents数据集为研究早期20世纪档案提供了结构化基石。其经典应用场景聚焦于图像分类与文本分类任务,尤其适用于区分加拿大远征军征兵文件与战争日记等不同类型的历史文档。通过结合页面扫描图像与结构化元数据——如士兵姓名、出生日期等字段的弱标签——研究者可训练模型实现表单区域的自动识别与文字转录,从而高效地将海量手写或打字机印刷的档案转化为可检索的数字文本。
实际应用
在实际应用中,该数据集可服务于文化遗产机构的自动化编目与公众历史教育平台。图书馆与档案馆可利用其图像与文本分类能力,自动将新扫描的征兵文件归入加拿大远征军档案体系,并提取关键人物信息以丰富元数据。此外,基于该数据集训练的OCR模型能辅助家谱网站与历史研究门户实现表单字段的自动填写,使研究者与公众能够便捷地检索到特定士兵的服役记录,从而深化对一战时期加拿大社会结构的理解。
衍生相关工作
该数据集衍生出一系列开创性工作,涵盖历史文献的弱监督学习与知识图谱构建。BigLAM倡议借助其结构化数据验证了从RDF三元组到扁平表格的转换流程,为其他文化遗产项目提供了可复用的数据管道模板。在此基础上,研究者已发展出针对早期20世纪手写体的多模态识别模型,并探索利用士兵姓名与出生日期的弱对齐关系,改进无监督命名实体消歧技术。这些工作推动了数字人文中战役档案研究范式的转变,从孤立的数据集整合转向基于关联数据的全球历史人物网络重建。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

