suno-various-94k
收藏资源简介:
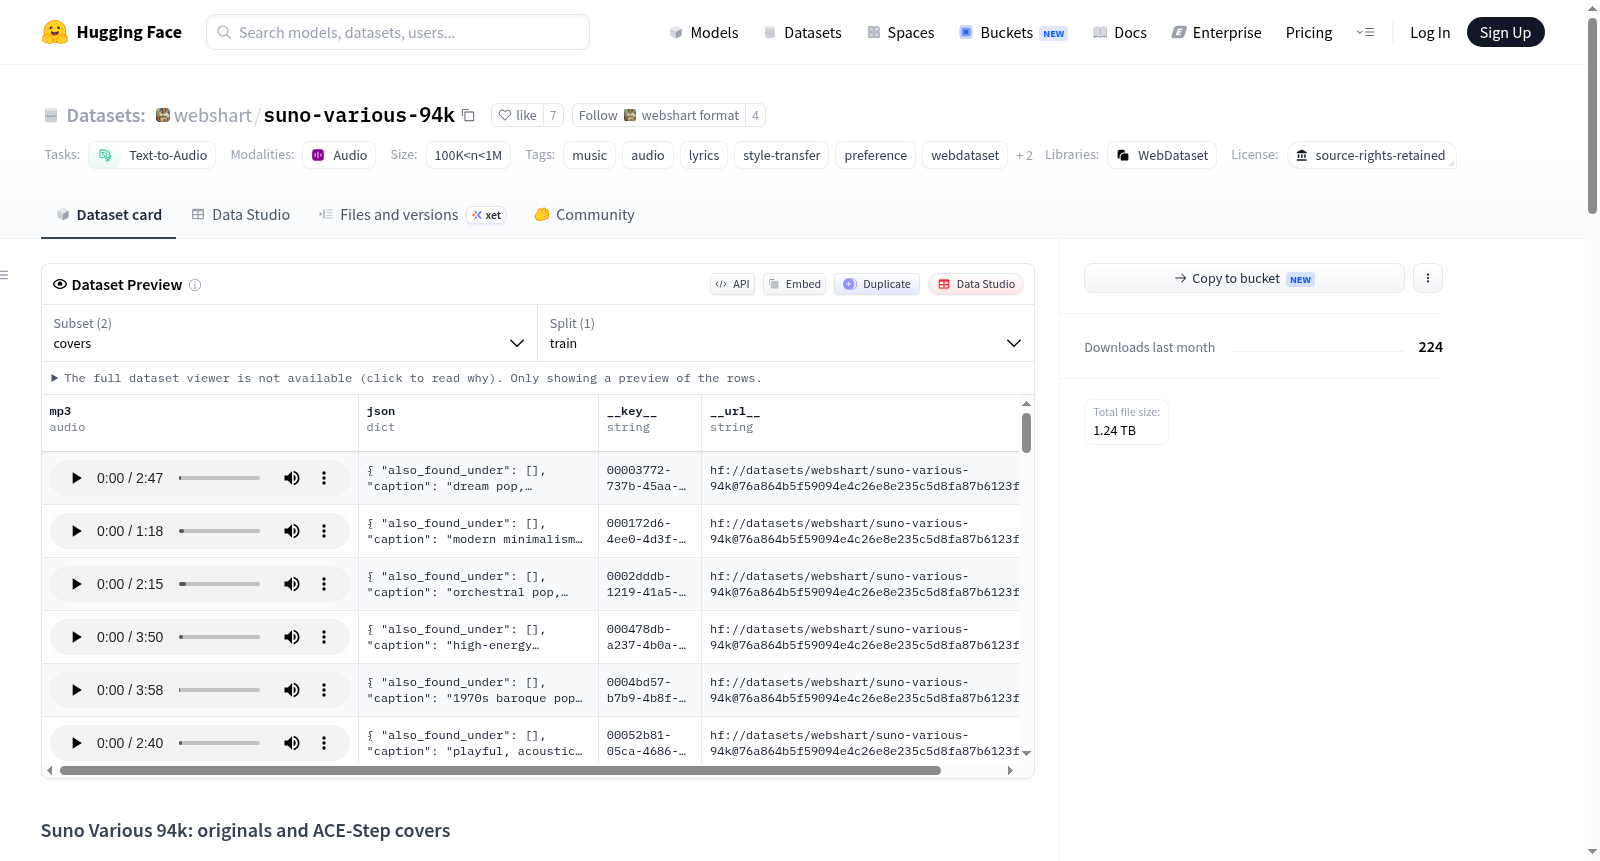
该数据集名为 Suno Various 94k,包含 94,174 对精确的原始音频与封面音频,专为参考条件、偏好、滑块和音乐风格迁移研究而设计。数据集分为两个独立子集:original(原始音频)和 covers(封面音频),每个子集均包含 85 个 tar 包和对应的 JSON 索引文件(WebShart 格式)。原始音频来自 Suno 生成的音乐,涵盖 53,082 位不同创作者,总时长约 5,429 小时,每条样本包含持续时间、风格描述、歌词、创作者标识、源片段 ID、搜索词和模型版本等字段。封面音频由 ACE-Step 1.5 XL Turbo 生成,保留源音频的作曲和歌词,但目标风格描述由 Qwen3.8-27B 模型重写,生成使用 8 步扩散和封面强度 0.50。数据集还提供了可恢复的生成管道代码、进度文件及原始数据集卡片。注意:所有源音频的版权归原始创作者所有,封面为衍生研究制品。封面音频为研究级输出,可能包含生成伪影、风格条件失败或低质量结果,未经过全面人工审计。数据集存在以下限制:源音频为合成音频,存在 Suno 模型伪影;收集存在流行度偏差;创作者描述词汇和特异性各异;搜索词仅为发现来源,非验证的流派标签;未过滤显式内容;封面继承源限制并增加 ACE-Step 伪影。该数据集适用于音乐风格迁移、参考条件控制、偏好学习等研究任务。
This dataset is named Suno Various 94k, containing 94,174 precise pairs of original audio and cover audio, designed for research on reference conditioning, preference, slider, and music style transfer. It is divided into two independent subsets: original and covers, each containing 85 tar packages and corresponding JSON index files (WebShart format). The original audio comes from Suno-generated music, covering 53,082 different creators, with a total duration of approximately 5,429 hours. Each sample includes fields such as duration, style description, lyrics, creator ID, source segment ID, search term, and model version. The cover audio is generated by ACE-Step 1.5 XL Turbo, retaining the composition and lyrics of the source audio, but the target style description is rewritten by the Qwen3.8-27B model, using 8-step diffusion and cover strength 0.50. The dataset also provides resumable generation pipeline code, progress files, and the original dataset card. Note: The copyright of all source audio belongs to the original creators, and the covers are derivative research artifacts. The cover audio is research-grade output, may contain generation artifacts, style condition failures, or low-quality results, and has not been fully manually audited. The dataset has the following limitations: source audio is synthetic and contains Suno model artifacts; collection has popularity bias; creator description vocabulary and specificity vary; search terms are only discovery sources, not verified genre labels; explicit content is not filtered; covers inherit source limitations and add ACE-Step artifacts. This dataset is suitable for research tasks such as music style transfer, reference conditioning, and preference learning.
Suno Various 94k 数据集概述
基本信息
- 数据集名称:Suno Various 94k Original and ACE-Step Covers
- 规模:包含 94,174 对原始音频/翻唱音频对(100K < n < 1M)
- 任务类型:文本转音频(text-to-audio)
- 标签:音乐、音频、歌词、风格迁移、偏好、WebDataset
- 许可协议:source-rights-retained(非标准许可证,链接至 Suno 服务条款)
数据内容
- 原始数据:94,174 首 Suno 生成的音乐曲目,附带创作者风格描述、结构化歌词和来源信息;涵盖 53,082 位独立创作者,约 5,429 小时音频;包含时长、描述、歌词、创作者昵称、来源片段 ID、发现词和模型版本字段。
- 翻唱数据:使用 ACE-Step 1.5 XL Turbo 生成的翻唱版本,保留原始作曲和歌词,但目标风格描述由 Qwen3.8-27B 重写;生成使用 8 步扩散和 0.50 的翻唱强度。
- 配对信息:翻唱 JSON 中记录了
pair_source、source_caption、target_style和pair_generation字段,使配对关系明确可审计。
数据组织
- 数据集分为
original/和covers/两个子文件夹,各包含 85 个 tar 文件及对应的 WebShart 随机访问索引(JSON 文件)。 - 每个 tar 文件中的成员以片段 ID 为键,包含
<clip_id>.mp3和<clip_id>.json。 - 两个子文件夹的片段 ID 完全一致(94,174 个),可通过文件名主干/片段 ID 进行配对。
加载方式
- 支持通过
webshart.discover_dataset分别加载任一子数据集,或通过片段 ID 进行配对任务。
权利与来源
- 所有原始音频和歌词的权利归第三方 Suno 用户(创作者)所有,数据集不授予底层内容的任何权利。
- 翻唱输出为派生的研究产物,每条记录的 JSON 中包含创作者身份和来源片段 ID,支持单样本定位和移除。
- 创作者可通过讨论区请求移除其作品。
质量声明与局限性
- 翻唱质量为研究级,并非精修语料:可能存在生成伪影、作曲或歌词保留不完美、风格条件失败或低质量结果;未经全面人工审计。
- 作者承认该数据集并不完美,但认为“不完美但可检查的大规模配对数据集比完全没有更有用”。
- 局限性:
- 所有源音频均为合成,继承 Suno 模型伪影。
- 收集受 Suno 搜索相关性影响,存在流行度偏差。
- 创作者撰写的描述词汇和具体程度各异。
- 搜索词是发现来源,而非经过验证的流派标签。
- 包含未过滤的露骨内容。
- 翻唱继承源限制并增加 ACE-Step 生成伪影。