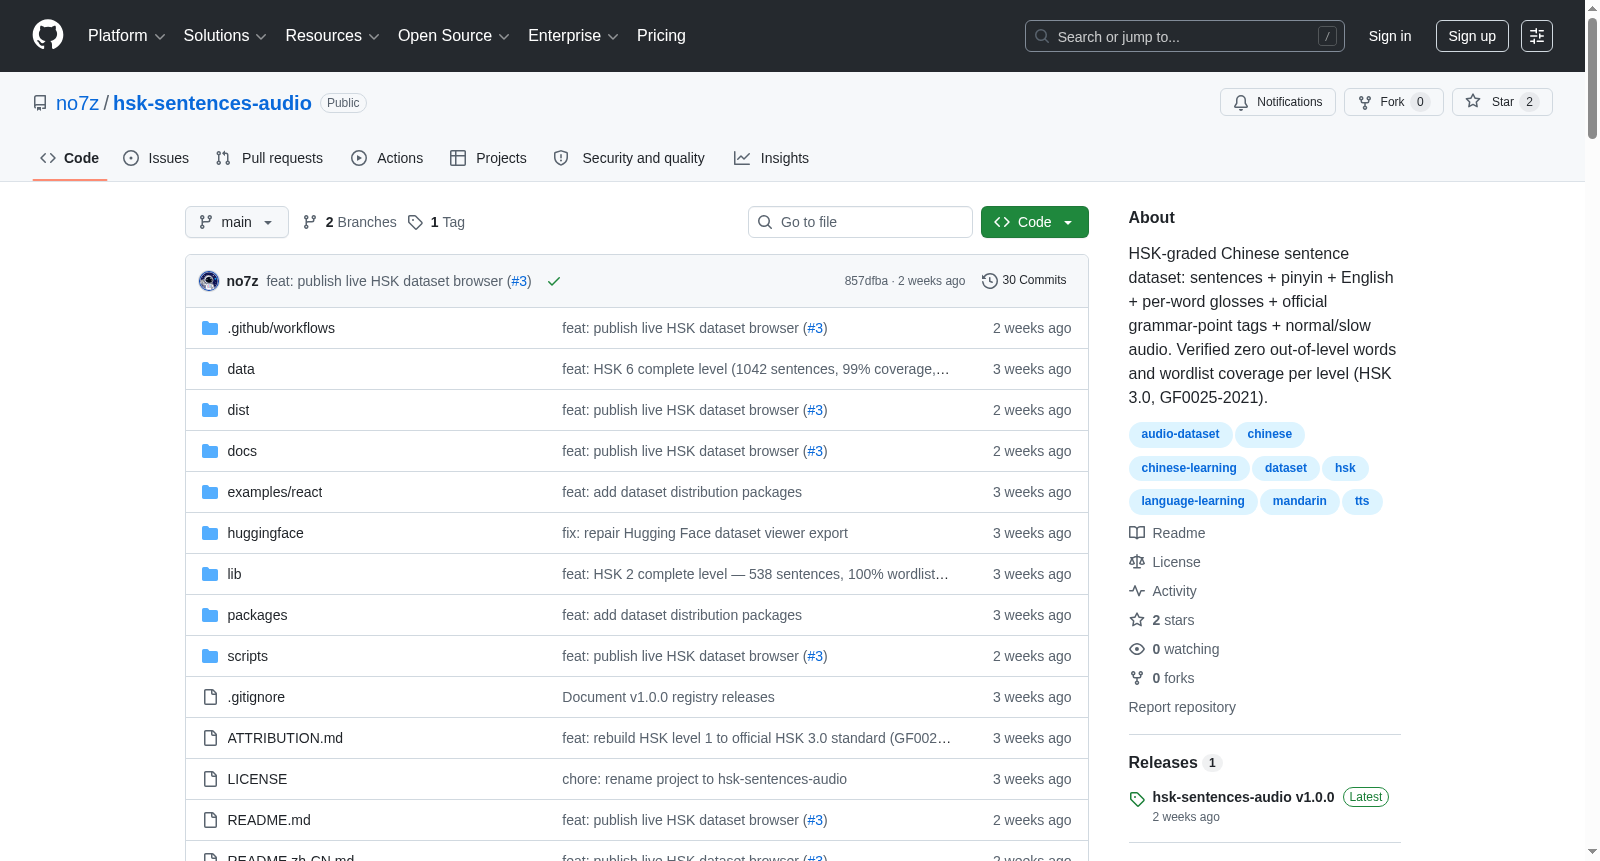
HSK-graded Chinese Sentence Dataset
收藏资源简介:
HSK分级中文句子数据集:包含句子、拼音、英文翻译、逐词注释、官方语法点标签以及正常/慢速音频。按照官方HSK 3.0标准分级,确保每个级别无超纲词汇,并覆盖该级别词汇表。包含4354个句子,覆盖HSK 1-6级,以及8708个MP3音频文件。
HSK Graded Chinese Sentences Dataset: This dataset comprises sentences, Hanyu Pinyin, English translations, word-by-word annotations, official grammar point tags, and both normal and slow-speed audio files. It is graded in accordance with the official HSK 3.0 standard, ensuring no out-of-level vocabulary for each level and covering the official vocabulary list of the corresponding level. The dataset contains 4354 sentences spanning HSK Levels 1 through 6, alongside 8708 MP3 audio files.
数据集概述
hsk-sentences-audio 是一个面向中文学习者的HSK分级句子数据集,提供带拼音、英文翻译、逐词注释、官方语法点标签以及常速/慢速双速音频的完整结构化句子记录,可直接用于闪卡、跟读、听力练习或间隔重复学习(SRS)应用。
规模与分级
数据集涵盖HSK 3.0(GF0025-2021)官方标准下的六个等级(1–6级),共 4,354 个句子,并附带 8,708 个MP3音频文件(每句常速+慢速各一个,总计约170 MB)。
| 等级 | 句子数 | 词汇覆盖率 | 超纲词数 |
|---|---|---|---|
| HSK 1 | 281 | 94% (478/506词) | 0 |
| HSK 2 | 538 | 100% (750/750词) | 0 |
| HSK 3 | 727 | 99% (950/953词) | 0 |
| HSK 4 | 801 | 98% (956/972词) | 0 |
| HSK 5 | 965 | 98% (1045/1059词) | 0 |
| HSK 6 | 1042 | 99% (1112/1123词) | 0 |
| 总计 | 4354 | — | 0 |
- 所有句子严格仅使用当前等级及以下等级的词汇,超纲词为0。
- 每个等级中未被覆盖的少量词为不能独立成句的黏着语素(如“员/者”),其合成词均已包含。
数据结构
每条记录包含以下字段(示例来自 dist/sentences.json):
- id:句子唯一标识(如
hsk1-0002) - hsk_level:所属HSK等级
- topic:主题分类,共18个主题(问候、家庭、时间、食物、交通、健康等)
- sentence_type:句型(陈述、疑问、祈使)
- chinese:简体中文句子
- traditional:繁体中文句子
- pinyin:拼音(含轻声、多音字、儿化处理)
- pinyin_numbered:带声调数字的拼音
- translation.en:英文翻译
- tokens:逐词注释,包含词语、拼音和英文释义
- grammar_tags:官方语法点ID(如
1-09表示程度副词,完整语法点登记表见data/grammar_points.json) - audio:常速和慢速音频文件路径
- audio_meta:音频生成信息(引擎 CosyVoice2-0.5B、音色 zh-female-studio、许可证 Apache-2.0、采样率 24000)
使用方式
- 在线浏览:可通过实时数据集浏览器查看,或离线双击
dist/index.html。支持按等级、主题、句型、语法点四个维度筛选,并可点击播放音频。 - 开发集成:访问开发者设置页(或离线
dist/setup.html),可一键导出SQL(SQLite/PostgreSQL/MySQL)、CSV及Anki导入文件,并提供Swift/TypeScript/Kotlin数据模型及LLM提示词生成器。 - 程序化读取:直接读取
dist/sentences.json和dist/audio/目录即可。 - 包管理安装:
- npm:
npm install hsk-sentences-audio(JavaScript/TypeScript) - PyPI:
pip install hsk-sentences-audio(Python)
- npm:
质量保证
- 分级验证(
scripts/hsk_validate.py):逐词对照官方词表检查超纲词(目标为0)和覆盖率,结果可复现。 - 语法点注册表:包含全部413个等级1–6的官方语法点(ID/等级/类别/例句),其中70个有自动检测规则,并有回归测试保护。
- 拼音处理:基于pypinyin结合CC-CEDICT批量校正(轻声、儿化)及人工覆盖层,确保文本与音频拼音一致。
- 分词:jieba(关闭HMM)+ HSK词表重切分,自动拆分错误合并,并配备异常表。
- 音频合成:使用CosyVoice2-0.5B本地合成,工作室女声参考音色,裁剪起始瞬态并做淡入处理。合成语音需在应用中进行披露(符合行业惯例)。
- 复审流程:构建时自动标记多音字/词典外词汇,人工确认后修正写入
data/overrides.json,永久生效。
数据贡献
可编辑 data/sentences/hsk<level>.yaml 文件添加句子,每句仅需提供中文、英文翻译和语法标注三个字段;拼音、繁体、分词、注释、主题、句型、语法标签和音频均由流水线自动生成,运行验证器确认无超纲词即可。
许可证
- 代码:MIT
- 数据集(
dist/):CC-BY-SA 4.0(注释和逐词拼音含CC-CEDICT衍生内容) - 音频:Apache-2.0(由CosyVoice2合成)