
遇见数据集

munchkincat/Kanana_Agent-data

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

Kanana Agent Data是一个用于Kanana Agent多智能体系统的预收集数据集,包含法律、新闻和金融趋势数据,支持系统中的Legal Agent、News Agent和Trend Agent。数据具体包括:法律文档向量数据库(来自国家法令信息中心)、新闻文章向量数据库(来自韩国经济和Money Today)以及金融趋势Chroma数据库(来自KCIF国际金融中心)。该数据集旨在为多智能体系统提供RAG(检索增强生成)和向量数据库支持,用户需将其放置在项目根目录的./data/路径下供各智能体引用。数据基于爬取和数据库构建时间点,并可能定期更新。

Kanana Agent Data is a pre-collected dataset for the Kanana Agent multi-agent system, containing legal, news, and financial trend data to support Legal Agent, News Agent, and Trend Agent in the system. The data includes: a legal document vector database (from the National Law Information Center), a news article vector database (from The Korea Economic Daily and Money Today), and a financial trend Chroma database (from KCIF International Finance Center). This dataset is designed to provide RAG (Retrieval-Augmented Generation) and vector database support for the multi-agent system, and users should place it in the ./data/ path under the project root for reference by each agent. The data is based on the time of crawling and database construction and may be updated periodically.

提供机构:
munchkincat
搜集汇总
数据集介绍
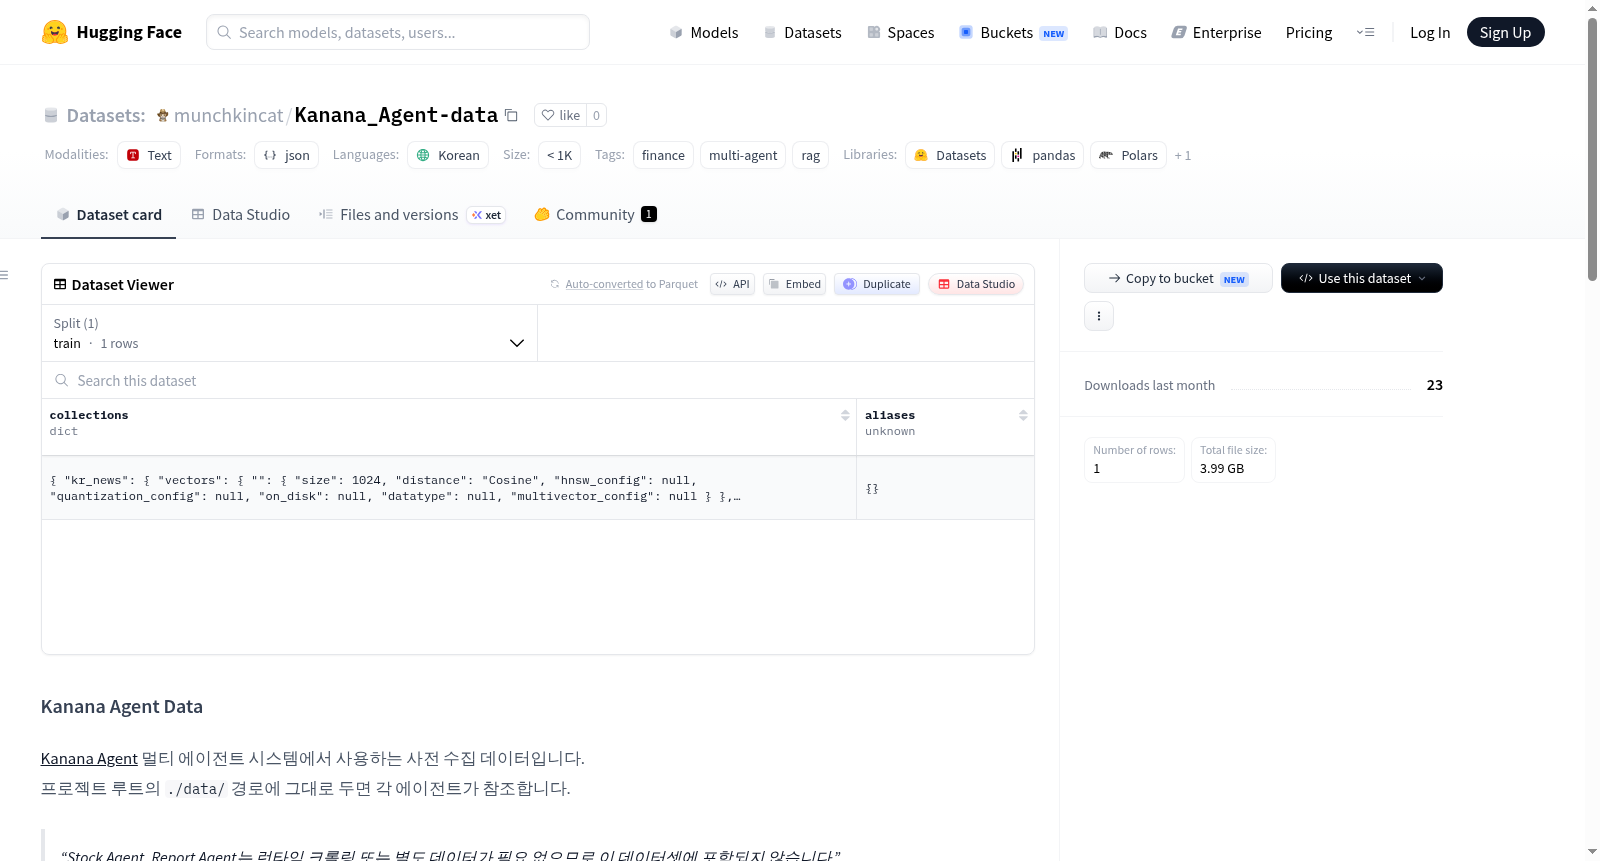
munchkincat/Kanana_Agent-data 数据集图片
构建方式
Kanana_Agent-data是针对多智能体系统构建的预采集数据集,旨在为金融领域的智能体提供结构化知识支撑。该数据集通过整合来自韩国国家法令信息中心的法律文档、韩国经济与Money Today的新闻文章,以及KCIF国际金融中心的数据,分别构建了Legal Agent专用的法律RAG数据库、News Agent所需的新闻向量数据库,以及Trend Agent所需的金融趋势数据。数据以向量数据库形态存储,包括LawDB、新闻collection及Chroma DB,确保多智能体系统可高效检索与调用。
特点
该数据集具有鲜明的多领域融合特性,聚焦于金融法律、新闻舆情与趋势分析三大核心场景。Legal Agent的数据涵盖完整的法律条文,News Agent的数据来源于主流财经媒体,Trend Agent的数据则聚焦于国际金融趋势。各子数据集均以向量数据库形式组织,支持高效相似性检索,降低了智能体在运行时对实时爬取的依赖。数据来源权威且时效性强,为多智能体协同决策提供了高可靠性的知识基座。
使用方法
使用者可通过复制数据集至项目根目录的`./data/`路径下,各智能体将自动引用对应子数据。推荐使用Hugging Face CLI执行下载指令,或利用Python的`snapshot_download`函数完成数据获取。下载后目录结构需保持`legal_data/LawDB`、`news_data/collection`及`trend_data/chroma_db_bge`的层级划分。值得注意的是,Stock Agent与Report Agent无需此数据集,因其依赖运行时爬取或独立资源。
背景与挑战
背景概述
Kanana_Agent-data数据集由韩国研究人员构建,旨在为多智能体金融分析系统Kanana Agent提供结构化知识支撑。该数据集整合了法律、新闻与金融趋势三类核心信息,分别源自国家法令信息中心、韩国经济日报及KCIF国际金融中心,构建时间可追溯至2024年。研究团队通过向量数据库与Chroma DB技术,将非结构化文本转化为可被法律智能体、新闻智能体与趋势智能体高效检索的嵌入表示,从而弥合金融决策中信息碎片化与智能体知识隔离之间的鸿沟。该数据集在面向金融领域的多智能体协作研究中具有奠基性意义,为后续融合实时数据与静态知识的混合推理范式提供了可复现的基准资源。
当前挑战
在领域问题层面,该数据集旨在应对金融分析中多源异构信息的整合挑战,包括法律条款的动态解读、新闻舆情的时效性捕捉以及金融趋势的语义对齐,这些任务要求智能体在细粒度语义空间中实现跨模态知识推理。构建过程中,团队面临三大技术难题:其一,法律文本的结构化转换需兼顾条款的层级关联与版本迭代;其二,新闻数据的高维向量索引在大规模实时更新场景下难以维持检索精度与延迟平衡;其三,趋势数据依赖的Chroma DB在跨语言金融术语的嵌入对齐上缺乏领域自适应机制,导致冷启动阶段语义漂移风险显著。
常用场景
经典使用场景
Kanana_Agent-data数据集专为多智能体系统(Multi-Agent System)在金融领域的应用而设计,其经典使用场景在于为不同职能的智能体提供结构化的知识底座。具体而言,Legal Agent通过法律文本向量数据库(LawDB)进行法规检索与合规分析,News Agent依托新闻向量数据库实现实时市场情绪捕捉,而Trend Agent则利用金融趋势数据库(Chroma DB)完成对宏观经济走向的研判。该数据集将法律、新闻与趋势三类异构知识源统一整合至一个多智能体协作框架中,使得各智能体能够基于各自专属的RAG(检索增强生成)模块高效协同工作,从而构建起一个覆盖法规解读、舆情分析与趋势预测的全方位智能决策系统。
衍生相关工作
围绕Kanana_Agent-data数据集,已衍生出多项具有代表性的研究工作。在技术层面,研究者基于其多智能体架构开发了优化的RAG检索策略,提升了法律与新闻语料的语义匹配精度。在应用层面,相关工作探索了将社区问答系统与趋势分析结合,以增强多智能体对金融事件因果推理的能力。此外,该数据集还为跨语言金融知识图谱的构建提供了基础资源,带动了韩语金融领域大模型微调与对齐优化的研究热潮。后续工作进一步将多智能体协作框架扩展至财务报表分析与风险管理,形成了以Kanana_Agent為原型的一系列垂直领域智能代理系统。
数据集最近研究
最新研究方向
Kanana_Agent-data数据集聚焦于金融领域多智能体系统中的检索增强生成(RAG)技术,通过结构化法律、新闻与趋势数据的向量数据库,支撑面向韩国金融市场的高精度信息检索与知识推理。前沿研究正探索将此类异构数据源与大规模语言模型协同,实现法律合规分析、实时舆情监测及金融趋势预测的自动化。该数据集与近期AI在金融科技领域的爆发式增长紧密相关,尤其是多智能体协作框架与RAG管线的融合,为智能投顾、风险管控等场景提供了可复现的基准资源,其影响在于推动金融行业从静态规则引擎向动态语义理解系统的范式迁移。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

