
karpaai/proof-bundles
收藏搜集汇总
数据集介绍
构建方式
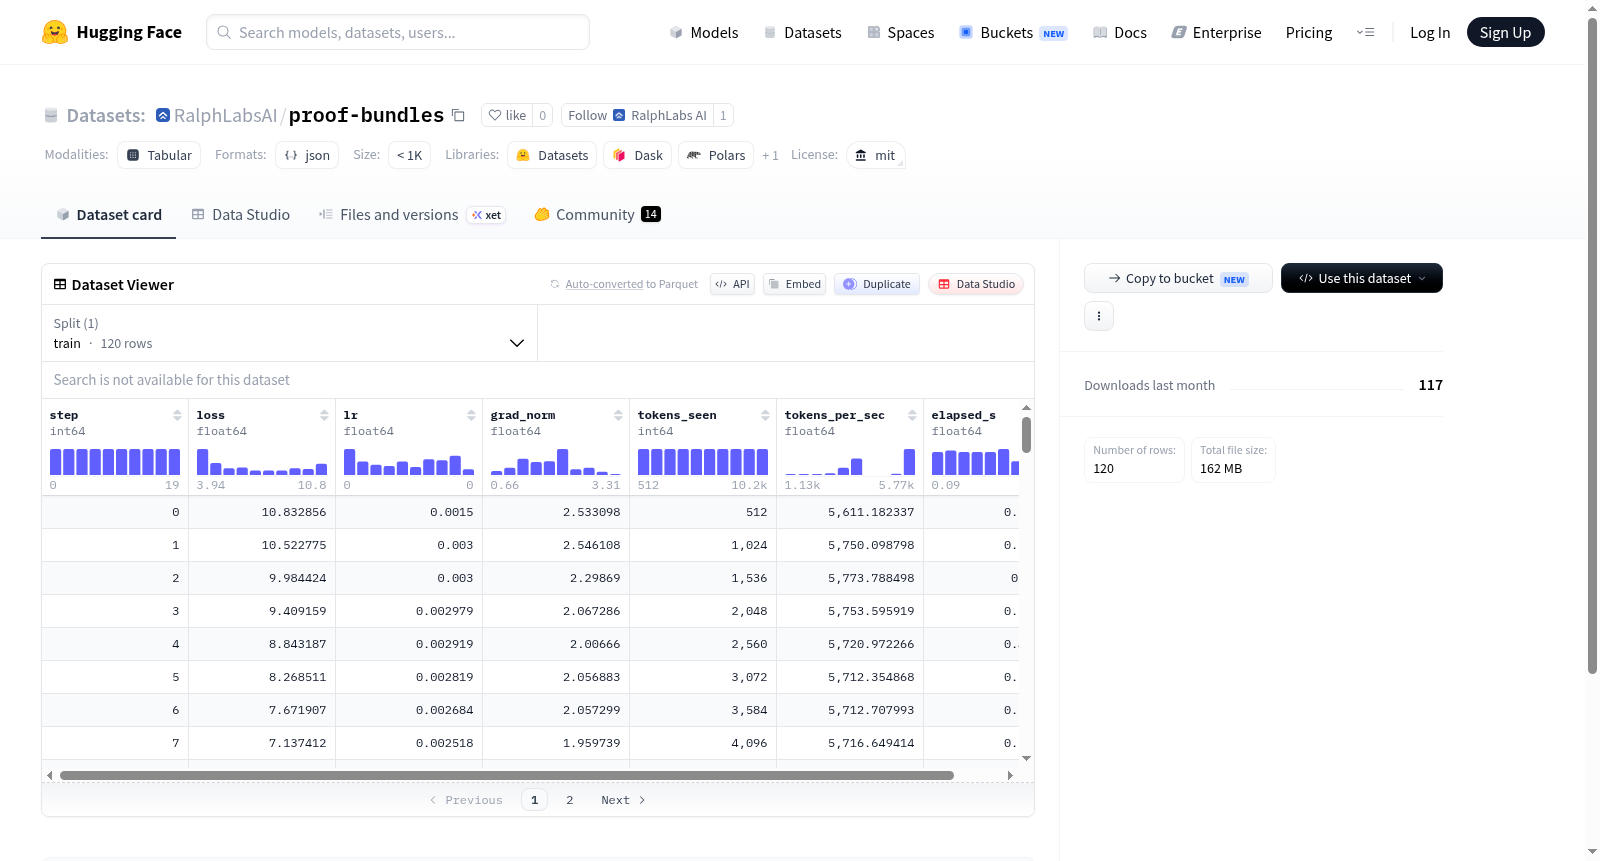
proof-bundles数据集通过收集和整理多种数学证明的源代码与形式化验证结果构建而成,涵盖了从基础算术到高级代数定理的广泛领域。每个数据样本包含证明的完整结构、推理步骤以及对应的逻辑依赖关系,确保数据在形式化环境中可复现和可验证。构建过程中采用了标准化格式对证明进行编码,并利用自动化工具检查一致性,从而形成高质量、结构化的证明集合。
特点
该数据集的核心特点在于其高度结构化的证明形式,每个条目不仅包含最终证明,还保留了中间推理链条与元数据信息,如证明长度、使用的公理和推导规则。此外,数据集支持多粒度分析,既可用于训练模型生成证明片段,也可用于评估证明的逻辑完整性。其开源许可(MIT)鼓励学术和工业界广泛应用,促进了形式化验证领域的资源共享与协作。
使用方法
使用proof-bundles数据集时,可将其加载为JSON或序列化格式,直接用于训练证明自动生成模型或作为强化学习环境的基准。研究人员也可通过解析推理步骤进行证明模式挖掘,或结合其他工具(如交互式定理证明器)进行跨数据集验证。建议从论文中获取详细配置示例,并依据任务需求选择子集或进行数据增强以适配特定证明策略。
背景与挑战
背景概述
proof-bundles数据集是一个专注于数学证明验证的结构化数据集,由相关研究机构于近期构建,旨在探索如何利用机器学习方法高效地解析和验证数学证明的完整性。该数据集的创建源于对形式化证明系统的需求,特别是在自动定理证明和数学推理领域,其核心研究问题是通过组织证明束(proof bundles)来降低验证复杂度。该数据集的出现为符号推理与神经符号方法的结合提供了标准化基准,对推动人工智能在数学发现中的应用具有重要影响。
当前挑战
proof-bundles数据集所面临的挑战首先体现在领域问题层面:数学证明的自动验证需要处理复杂的逻辑结构和抽象符号,而现有方法在鲁棒性和泛化能力上仍存在不足,容易陷入组合爆炸或局部最优陷阱。在构建过程中,数据收集面临证明束的标准化标注困难,不同数学分支的证明风格差异导致一致性维护成为难题;此外,保证证明束中推理步骤的完全正确性,以及平衡数据规模与标注成本,均是构建时需克服的显著障碍。
常用场景
经典使用场景
在数学定理机器证明与形式化验证的学术前沿,proof-bundles数据集为研究者提供了一类结构化的证明语料库。其最经典的用途在于训练和评估面向数学推理的生成模型与翻译系统,具体而言,研究人员可利用该数据集开发从非形式化数学陈述到形式化证明脚本的自动转换方法。通过将自然语言描述的命题与对应的高阶逻辑证明束进行对齐,该数据集成为弥合数学直觉与机器可操作形式系统之间鸿沟的关键桥梁。
解决学术问题
proof-bundles直面了形式化验证领域中数据稀缺这一核心瓶颈。长期以来,构建大规模、高质量的人机可读证明对需要专家耗费大量精力,限制了机器学习技术在定理证明中的应用深度。该数据集通过系统性地整理和标注证明束结构,有效支撑了证明搜索空间缩减、战术规划策略学习以及表述无关的证明模式挖掘等研究。其贡献在于首次以统一格式汇聚了跨领域的证明工程案例,为自动定理证明领域的神经符号学习方法奠定了数据基础。
衍生相关工作
围绕proof-bundles衍生出一系列具有深远影响的学术工作。基于其结构化的证明束,研究人员提出了证明片段微调方法,显著提升了大型语言模型在数理论证任务中的少样本学习能力。同时,该数据集激励了证明骨架抽取算法的开发,该算法能从冗余的交互式证明中提炼出核心逻辑链条,为证明压缩与复用提供了新思路。相关研究还证明了在该数据集上预训练的表征能够零样本泛化至未见的数学领域,推动了通用数学推理基座模型的构建进程。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


