DeepSWE-Gym-Raw
收藏资源简介:
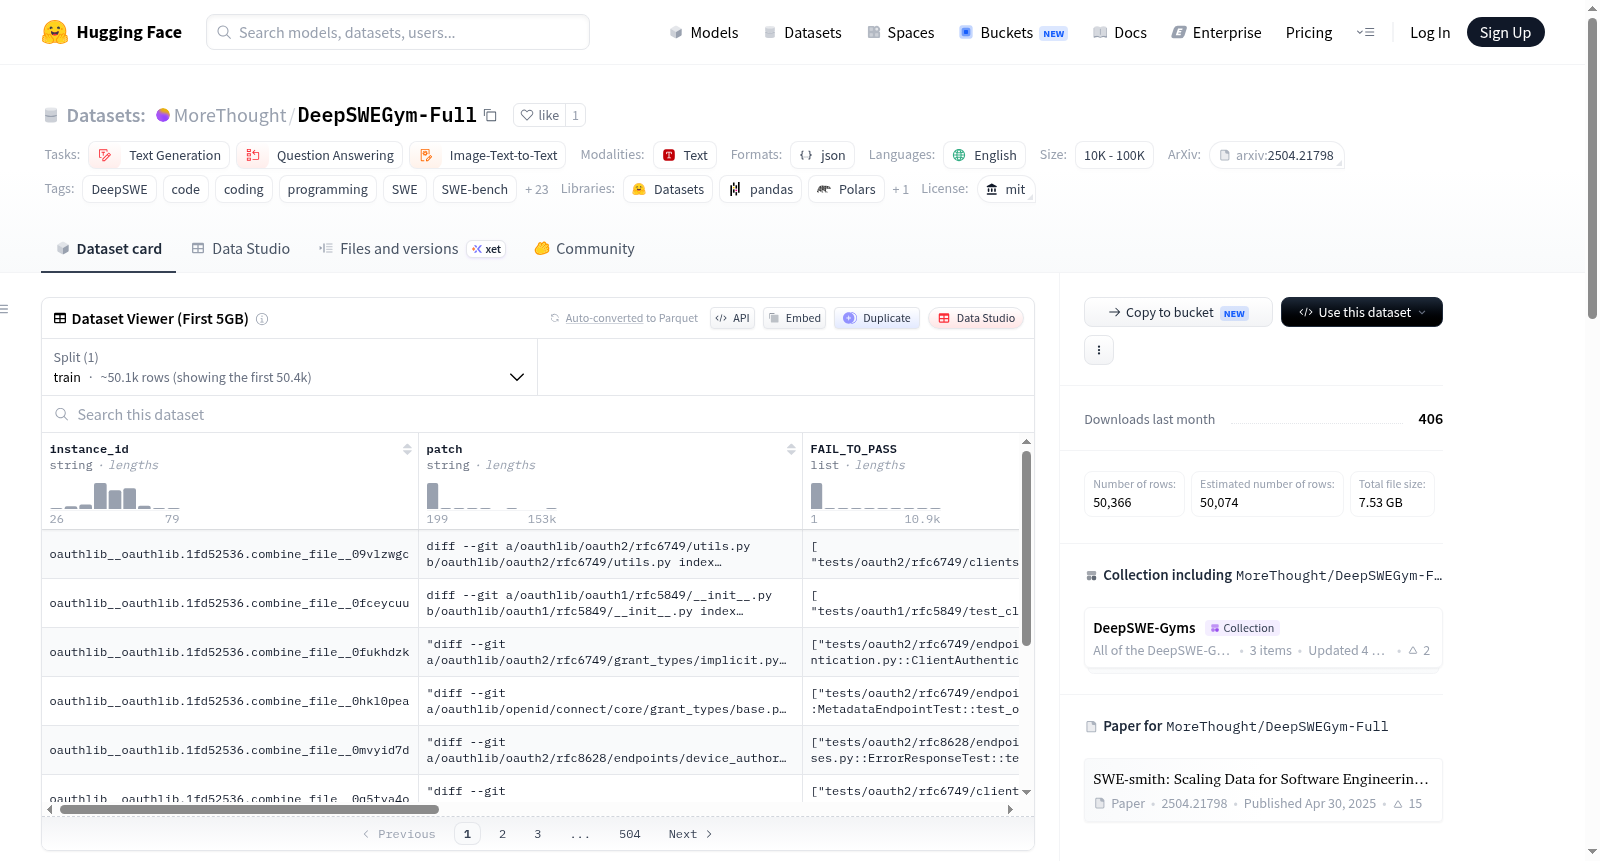
该数据集是 SWE-bench 和 SWE-smith 系列中所有语言特定数据集的合并版本,总计 88130 个样本。它旨在提升 DeepSWE 风格问题、相关基准测试以及通用编程技能的表现。尽管未专门筛选原始数据集中复杂或长代码问题的行,但平均每个样本大小为 85.4KB,总未压缩大小为 7.53GB。数据集涵盖多种编程语言(Python、Go、Rust、TypeScript、JavaScript、C++、Java、PHP),适用于改进基准测试结果、提升通用编码能力、训练软件工程/编码代理以及改进长上下文编码任务。数据集由 MoreThought 策划、资助和共享,采用 MIT 许可证。注意:为避免样本重叠,请勿将此数据集与其他变体或版本一同使用。
This dataset is a merged version of all language-specific datasets in the SWE-bench and SWE-smith series, totaling 88,130 samples. It aims to improve performance on DeepSWE-style problems, related benchmarks, and general programming skills. Although it does not specifically filter lines for complex or long-code problems from the original dataset, the average sample size is 85.4KB, with a total uncompressed size of 7.53GB. The dataset covers multiple programming languages (Python, Go, Rust, TypeScript, JavaScript, C++, Java, PHP), and is suitable for improving benchmark results, enhancing general coding abilities, training software engineering/coding agents, and improving long-context coding tasks. The dataset is curated, funded, and shared by MoreThought under the MIT license. Note: To avoid sample overlap, do not use this dataset together with other variants or versions.
DeepSWE-Gym-Raw 数据集概述
数据集简介
本数据集由 MoreThought 团队策划、资助并共享,合并了所有 SWE-bench/SWE-smith-lang 系列的原始数据,总计包含 88,130 条样本,旨在提升模型在 DeepSWE 风格问题、基准测试及通用编程能力上的表现。
数据规模与特性
- 样本数量:88,130 条
- 平均单条大小:85.4 KB
- 未压缩总大小:7.53 GB
- 分类规模:10K < N < 100K
- 未特别筛选包含复杂/长代码问题的样本,但整体数据规模仍较大
数据来源
该数据集由以下 8 个仓库的 SWE-smith 语言子集合并而成:
- SWE-bench/SWE-smith-py (Python)
- SWE-bench/SWE-smith-go (Go)
- SWE-bench/SWE-smith-rs (Rust)
- SWE-bench/SWE-smith-ts (TypeScript)
- SWE-bench/SWE-smith-js (JavaScript)
- SWE-bench/SWE-smith-cpp (C++)
- SWE-bench/SWE-smith-java (Java)
- SWE-bench/SWE-smith-php (PHP)
相关论文参考:https://huggingface.co/papers/2504.21798
数据用途
- 提升基准测试表现
- 增强通用编程能力
- 训练软件工程/编码智能体
- 改进长上下文编码任务
任务类型与语言
- 任务类别:文本生成、问答、图像-文本到文本
- 语言:英语
- 代码语言标签:py、js、ts、java、cpp、rust、go 等
标签属性
涵盖 coding、programming、SWE、SWE-bench、reasoning、agentic、software-engineering、long-context、code-generation、repository-level、multi-file、fine-tuning、SFT、benchmark 等多项技术标签。
重要提示
请勿将本数据集与其变体或不同版本混用,以免产生重叠的训练样本。