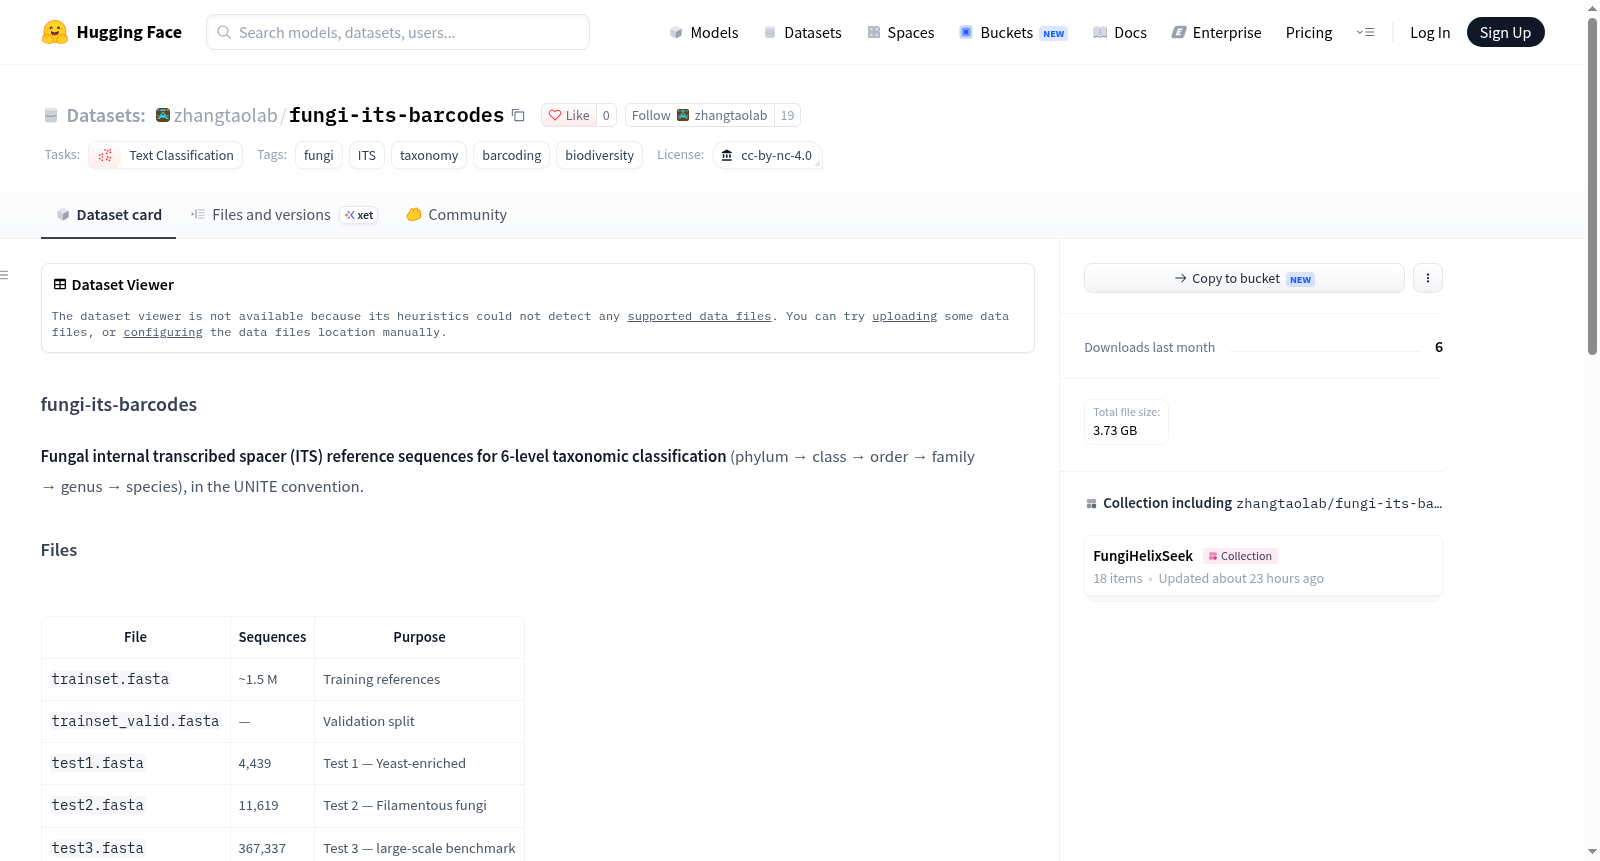
fungi-its-barcodes
收藏资源简介:
该数据集(fungi-its-barcodes)是针对真菌内转录间隔区(ITS)的参考序列集合,用于六级分类学注释(门、纲、目、科、属、种),遵循 UNITE 命名规范。数据来源于 UNITE + INSD 真菌数据库(Abarenkov et al. 2023),并采用 MyCoAI 数据发布(Romeijn et al. 2024)中的训练/验证/测试划分和分类头格式。数据集包含以下文件:训练集(trainset.fasta,约150万条序列)、验证集(trainset_valid.fasta)、测试集1(test1.fasta,4,439条,酵母富集)、测试集2(test2.fasta,11,619条,丝状真菌)、测试集3(test3.fasta,367,337条,大规模基准)以及演示子集(top50.fasta,2,024条)。每条序列的 FASTA 头部编码了从界到种的完整分类路径,未知等级以问号标记。训练集中覆盖了18个门、70个纲、231个目、791个科、3,695个属和14,742个种。该数据集适用于文本分类任务,可用于训练和评估真菌 ITS 序列的分类模型。许可协议为 CC-BY-NC 4.0,仅限研究用途。
The dataset (fungi-its-barcodes) is a reference sequence collection for fungal internal transcribed spacer (ITS) regions, used for six-level taxonomic annotation (phylum, class, order, family, genus, species) following the UNITE naming scheme. The data originates from the UNITE + INSD fungal database (Abarenkov et al. 2023) and adopts the training/validation/test splits and classification head format from the MyCoAI data release (Romeijn et al. 2024). The dataset includes the following files: training set (trainset.fasta, ~1.5 million sequences), validation set (trainset_valid.fasta), test set 1 (test1.fasta, 4,439 sequences, yeast-enriched), test set 2 (test2.fasta, 11,619 sequences, filamentous fungi), test set 3 (test3.fasta, 367,337 sequences, large-scale benchmark), and a demo subset (top50.fasta, 2,024 sequences). Each sequences FASTA header encodes the complete taxonomic path from kingdom to species, with unknown ranks marked by question marks. The training set covers 18 phyla, 70 classes, 231 orders, 791 families, 3,695 genera, and 14,742 species. This dataset is suitable for text classification tasks and can be used to train and evaluate fungal ITS sequence classification models. Licensed under CC-BY-NC 4.0, for research purposes only.
fungi-its-barcodes 数据集概述
基本信息
- 数据集地址:https://huggingface.co/datasets/zhangtaolab/fungi-its-barcodes
- 许可协议:CC-BY-NC 4.0(仅限研究使用;商业授权需联系作者)
- 任务类别:文本分类
- 标签:fungi、ITS、taxonomy、barcoding、biodiversity
数据集简介
真菌内转录间隔区(ITS)参考序列,用于 6 级分类学分类(门 → 纲 → 目 → 科 → 属 → 种),采用 UNITE 规范。
文件构成
| 文件 | 序列数量 | 用途 |
|---|---|---|
trainset.fasta |
约 150 万 | 训练参考序列 |
trainset_valid.fasta |
— | 验证集划分 |
test1.fasta |
4,439 | 测试 1 — 富集酵母 |
test2.fasta |
11,619 | 测试 2 — 丝状真菌 |
test3.fasta |
367,337 | 测试 3 — 大规模基准 |
top50.fasta |
2,024 | 演示子集 |
数据格式
FASTA 头部编码完整的分类学路径;未知等级以 ? 标记:
KY106088|k__Fungi;p__Ascomycota;c__Saccharomycetes;o__Saccharomycetales;f__Saccharomycetaceae;g__Zygotorulaspora;s__Zygotorulaspora_mrakii|SH1312607.09FU
类别数量(训练集)
- 门:18
- 纲:70
- 目:231
- 科:791
- 属:3,695
- 种:14,742
数据来源
- 参考序列源自 UNITE + INSD dataset for Fungi(Abarenkov 等,2023,PlutoF,doi:10.15156/bio/2938065)。
- 训练/验证/测试划分及 UNITE 风格分类学头部遵循 MyCoAI 数据发布(Romeijn 等,2024,Molecular Ecology Resources,doi:10.1111/1755-0998.14006;github.com/MycoAI/MyCoAI)。
- 使用本数据集时需同时引用上述两个来源。
使用方法
- 微调模型:FungiHelixSeek-Taxonomy(https://huggingface.co/zhangtaolab/FungiHelixSeek-Taxonomy),在丝状真菌测试集(
test2.fasta,干净标注的参考子集)上物种准确率为 70.8%。
bash python scripts/species_classification/predict.py --model_path models/FungiHelixSeek-Taxonomy --input_fasta test2.fasta --output predictions.csv
- 训练配方与完整指标:scripts/species_classification on GitHub(https://github.com/zhangtaolab/FungiHelixSeek/blob/main/scripts/species_classification/README.md)
许可
CC-BY-NC 4.0(仅限研究使用;商业授权需联系作者)。