FrontierChallenge
收藏资源简介:
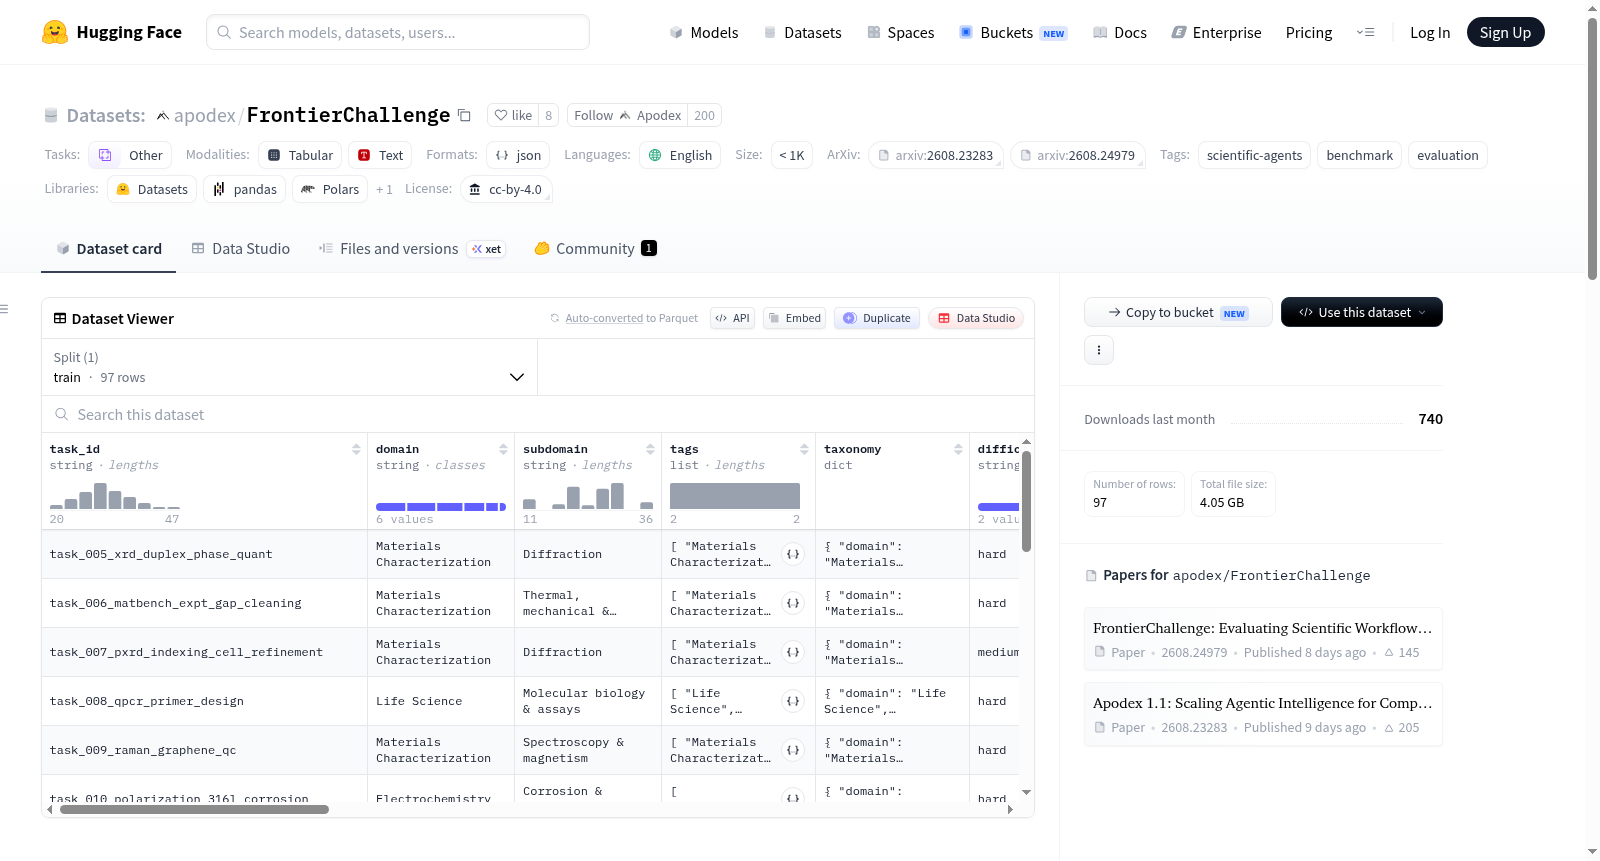
FrontierChallenge 是一个用于评估科学工作流完成能力的基准数据集。它包含 97 个科学工作流任务,每个任务提供英文指令、输入、Harbor 定义、领域标签以及可重新分发的开放运行时镜像。数据集包含一个 manifest.jsonl 文件,记录任务 ID、分类、难度、运行时间和指令;每个任务在 tasks/<task-id>/ 目录下包含 instruction.md、任务元数据、环境定义和 agent 可见输入;images/ 目录存储了 81 个开放镜像任务的已验证 linux/amd64 Docker 归档。另有 16 个 ORCA 任务定义和输入,但 ORCA 本身及其镜像需从官方提供方获取。该数据集不含评分器、规则、固定装置或参考输出,这些信息存储在单独的加密数据集中。数据集适用于评估科学工作流中 agent 的任务完成能力,典型使用方式是通过 FrontierChallenge 运行时工具下载、验证、加载镜像并运行评分。
FrontierChallenge is a benchmark dataset for evaluating scientific workflow completion capabilities. It contains 97 scientific workflow tasks, each providing English instructions, inputs, Harbor definitions, domain labels, and redistributable open runtime images. The dataset includes a manifest.jsonl file recording task IDs, categories, difficulty, runtime, and instructions; each task under tasks/<task-id>/ contains instruction.md, task metadata, environment definitions, and agent-visible inputs; the images/ directory stores verified linux/amd64 Docker archives for 81 open image tasks. There are also 16 ORCA task definitions and inputs, but ORCA itself and its images must be obtained from the official provider. The dataset does not include scorers, rules, fixtures, or reference outputs, which are stored in a separate encrypted dataset. It is suitable for evaluating agent task completion abilities in scientific workflows, typically used via the FrontierChallenge runtime tool to download, verify, load images, and run scoring.
FrontierChallenge 数据集概述
基本信息
- 数据集名称:FrontierChallenge
- 许可证:CC-BY-4.0
- 语言:英语
- 任务类别:其他(other)
- 标签:科学智能体(scientific-agents)、基准测试(benchmark)、评估(evaluation)
- 数据集大小:包含 97个科学工作流任务
- 数据集配置:默认配置(default),包含训练集(train)文件
manifest.jsonl
内容与结构
| 路径 | 内容 |
|---|---|
manifest.jsonl |
包含任务ID、分类、难度、运行时和指令等行的数据集查看内容 |
tasks/<task-id>/ |
每个任务的指令(instruction.md)、任务元数据、环境定义和智能体可见输入 |
images/ |
已验证的 linux/amd64 Docker归档,覆盖81个开放镜像任务 |
核心特点
- 任务类型:提供97个科学工作流任务,附带纯文本英文指令、输入、Harbor定义、领域标签和可再分发的开放运行时镜像。
- ORCA任务:包含16个ORCA任务的定义和输入,但ORCA本身及相关镜像不随数据集分发,需由评估者从官方提供商获取,并遵循运行时仓库的本地镜像教程。
- 无评分内容:数据集中不含评分器、评分标准、固定环境或参考输出,这些内容以加密归档形式存储于单独的
apodex/FrontierChallenge-reference数据集中。
使用方式
- 运行时:使用 FrontierChallenge 运行时(来自 ApodexAI/FrontierAgent 仓库)下载两个数据集、验证共享注册表、加载镜像归档、运行Harbor并对任务进行评分。
- 设置与评估示例:通过
setup.sh脚本设置跟踪(track)为开放(open),并利用run_eval.sh脚本指定智能体(如 claude-code)和模型执行评估。 - 验证:可使用
python tools/verify_dataset.py验证下载的解决包。
引用信息
- Apodex 1.1:e-print arXiv:2608.23283(cs.AI)
- FrontierChallenge:e-print arXiv:2608.24979(cs.AI),作者包括 Liangcai Su、Zhaopeng Feng、Zhuo Chen 等。