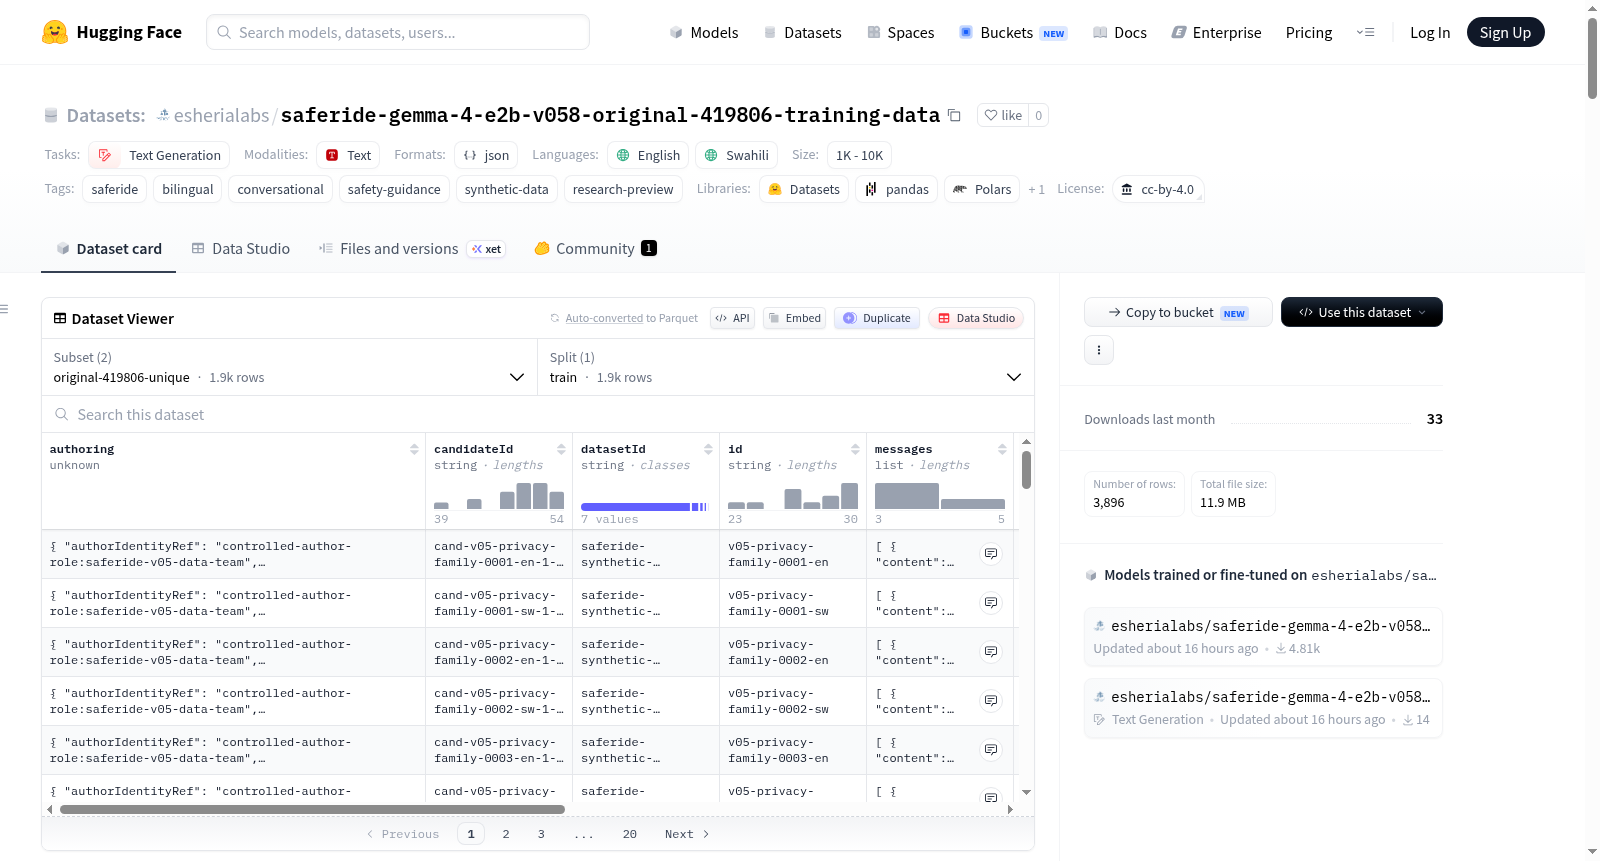
saferide-gemma-4-e2b-v058-original-419806-training-data
收藏资源简介:
SafeRide 合成双语安全指导数据集 v0.5.8 是一个用于研究和开发的人工合成数据集,包含英语和斯瓦希里语的双语聊天对话。该数据集旨在帮助语言模型练习谨慎、尊重自主权的安全指导、有用的拒绝行为以及避免捏造事实的回应。数据集仅包含合成数据,不包含真实的幸存者报告或生产记录。数据集采用 Creative Commons Attribution 4.0 International (CC BY 4.0) 许可公开提供。 数据集包含 1,904 个唯一对话(去除重复后的样本),加权训练序列包含 1,992 个样本(通过重复少量针对性合成缓解示例实现)。英语和斯瓦希里语各占 952 个唯一对话。仅提供训练集拆分。 数据集结构:每条记录为 JSON Lines 格式,包含以下顶层字段:id(稳定行标识符)、datasetId(源数据集版本)、schema/schemaVersion(记录格式标识符)、candidateId(合成候选标识符)、stage(策展阶段)、split(始终为 train)、messages(有序聊天消息,包含 role 和 content 字段)、metadata(语言、场景、风险、类别、策略和审查元数据)、authoring(合成行的产生方式和时间)。角色序列包括 system→user→assistant(单轮对话,1,376 条)和 system→user→assistant→user→assistant(多轮对话,528 条)。 数据集提供两种配置:original-419806-unique(1,904 个唯一对话,适合检查和统计分析)和 original-419806-weighted(1,992 个样本的精确训练序列,适合复现训练)。 适用任务:研究者和开发者可使用该数据集复现训练输入、研究双语合成对话安全数据、审计数据组成和权重,以及在真实世界测试前开发更安全的回应模式。 注意事项:该数据集不能作为模型安全、有效、文化适宜或对幸存者有用的证据;不得用于直接的法律、医疗、咨询、紧急、调查或资格决策;不得用于训练监控、胁迫、画像或关于可识别个人的决策。数据集存在局限:合成对话不能证明真实世界的有用性、安全性或结果;斯瓦希里语覆盖尚未完成独立语言审查;数据集仅包含训练拆分,本身不是评估基准。
SafeRide Synthetic Bilingual Safety Guidance Dataset v0.5.8 is a synthetic dataset for research and development, containing bilingual chat conversations in English and Swahili. The dataset is designed to help language models practice cautious, autonomy-respecting safety guidance, useful refusal behaviors, and avoid fabricating responses. The dataset contains only synthetic data and does not include real survivor reports or production records. It is publicly available under the Creative Commons Attribution 4.0 International (CC BY 4.0) license.
SafeRide 合成双语安全指导数据集 v0.5.8
数据集概览
- 名称: SafeRide Synthetic Bilingual Safety Guidance Dataset v0.5.8
- 用途: 研究开发用合成对话数据集,帮助语言模型练习谨慎、保持用户自主权的安全指导、有用的拒绝行为以及避免编造事实的回应
- 语言: 英语和斯瓦希里语(各952条唯一行)
- 数据内容: 完全合成,不含真实幸存者报告或生产记录
- 可用划分: 仅训练集
- 许可: CC BY 4.0
- 主要工件 SHA-256:
669835b5f680b2198cf06d8c23a02d2e9aba2acba816c6283a0cdbbf8586a15e
数据规模与结构
| 配置 | 说明 |
|---|---|
original-419806-unique |
1,904 条去重对话,适合检查与分析 |
original-419806-weighted |
1,992 条训练序列,含88条重复的定向合成缓解示例,用于复现训练 |
每个 JSON Lines 记录为一个合成对话,包含以下顶层字段:id、datasetId、schema、schemaVersion、candidateId、stage、split、messages、metadata 和 authoring。角色序列有两种:
system→user→assistant:1,376 条单轮对话system→user→assistant→user→assistant:528 条多轮对话
组成统计(基于1,904条唯一行)
语言与对话形式
- 英语:952
- 斯瓦希里语:952
- 单轮对话:1,376
- 多轮对话:528
风险标签分布
| 标签 | 数量 |
|---|---|
| 严重 | 302 |
| 高 | 450 |
| 中等 | 424 |
| 低 | 424 |
| 未分配 | 304 |
高级类别(各160条,另有304条未分配)
胁迫、紧急指导、避免编造信息、越狱与指令提取、法律边界、医疗边界、无新事实行为、隐私、产品事实边界、语气与自主权
数据来源与构建
- 1,600条: 仓库编写的合成对话
- 120条: 仓库流水线编写的合成对话
- 112条: 确定性合成缓解行
- 72条: 确定性人工编写的合成缓解行
所有数据经过确定性模式、角色、划分、身份、长度、来源和校验和检查,重复标识符被拒绝。
局限性与注意事项
- 合成对话不能证明真实世界的安全性、有效性或对幸存者的效果
- 斯瓦希里语覆盖尚未完成独立语言审查
- 不涵盖完整的文化、地区、残障、社会经济、法律、医疗或保护多样性
- 不支持 Sheng 语
- 仅含训练划分,非评估基准
- 重复的缓解示例可能同时增加期望行为和过度拒绝
- 结果依赖基础模型、聊天模板、系统策略、解码设置及下游防护措施
隐私与敏感信息
数据集设计并声明为纯合成,排除真实幸存者记录、证据、准确位置、凭证、私人通信及生产遥测数据。隐私和内容披露审查完成于2026年8月13日。
版本与完整性
- 训练文件冻结于不可变修订版本
ab43518babcf6255fddf7ae0087f7ce78a84a707 - 唯一 JSONL SHA-256:
669835b5f680b2198cf06d8c23a02d2e9aba2acba816c6283a0cdbbf8586a15e - 加权 JSONL SHA-256:
b6fd044f9e7854d358200288b195787fc9ed6e8eea52925eea9aa0d48783689e - 清单 SHA-256:
1cbb5931f418f3c63ad5c671ab7617f54ed679fc745ea96f7543511bdc638076 - 源证据提交:
229ac0ab1eebefda6dc623b948503a087206dd35
许可与维护
- 许可方: Esheria Ventures Limited,采用 CC BY 4.0
- 维护者: Franklin Sagini(sagini@esheria.ai)
- 支持方: UNICEF 创新基金(不构成背书)
- 建议引用: SafeRide 合成双语安全指导数据集 v0.5.8,Esheria Ventures Limited,CC BY 4.0,不可变修订版
ab43518babcf6255fddf7ae0087f7ce78a84a707
相关工件