
FreedomIntelligence/CoD-PatientSymDisease
收藏官方服务:
资源简介:
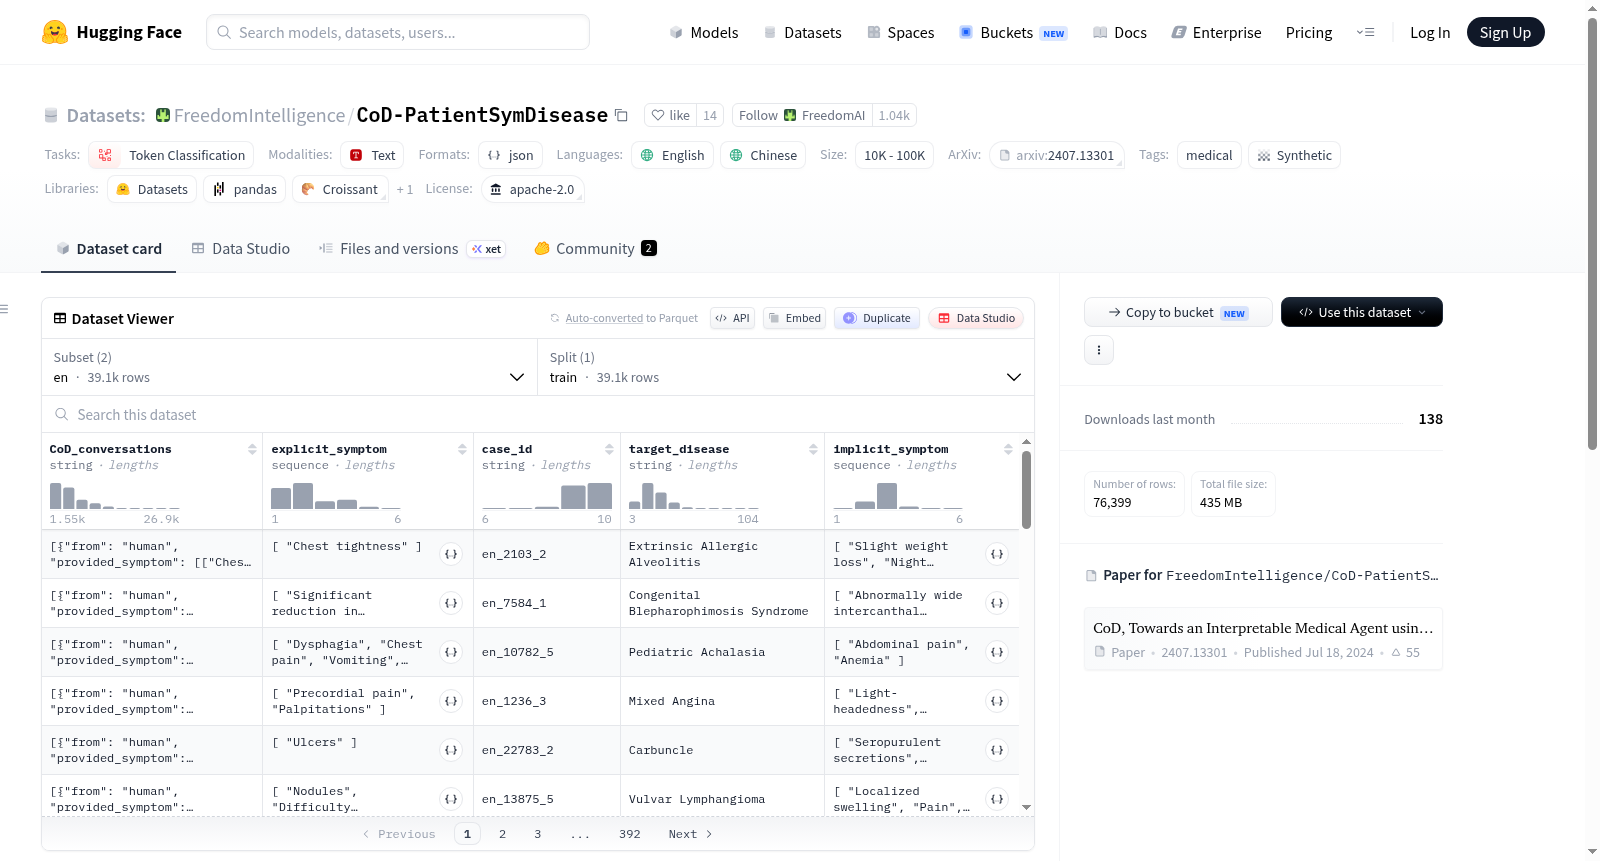
CoD合成患者疾病和症状数据集是一个专为文本生成和标记分类任务设计的医疗合成数据集,支持英语和中文。该数据集包含英文和中文两个版本,数据文件分别为CoD_en.json和CoD_zh.json。
The CoD Synthesized Patients with Disease and Symptoms dataset is a medical synthetic dataset designed for text generation and token classification tasks, supporting both English and Chinese. It includes two configurations, with data files CoD_en.json and CoD_zh.json for English and Chinese versions respectively.
提供机构:
FreedomIntelligence原始信息汇总
数据集概述
基本信息
- 许可证: Apache 2.0
- 任务类别:
- 文本生成
- 标记分类
- 语言:
- 英语
- 中文
- 标签:
- 医疗
- 合成
数据集名称
- 名称: CoD Synthesized Patients with Disease and Symptoms
配置
- 配置名称: en
- 数据文件: CoD_en.json
- 配置名称: zh
- 数据文件: CoD_zh.json
搜集汇总
数据集介绍
构建方式
该数据集基于Chain of Diagnosis(CoD)框架,通过合成技术构建而成。数据生成过程模拟了医学诊断中的逻辑推理链条,从疾病出发,反向推导出与之相关的症状表现,从而形成结构化的“疾病-症状”映射对。数据集涵盖英文和中文两种语言版本,分别存储于独立的JSON文件中,确保了语言多样性与跨语言适用性。
特点
数据集的核心特点在于其合成性与结构化。所有数据均通过自动化流程生成,避免了真实患者数据的隐私风险,同时保证了症状与疾病之间的逻辑一致性。此外,数据集支持文本生成与令牌分类两种任务类型,适用于多种自然语言处理场景。其双语配置进一步拓展了在跨语言医疗应用中的潜力,为医学语言模型提供了高质量的推理训练基础。
使用方法
用户可通过HuggingFace平台直接加载该数据集,指定语言配置(en或zh)以获取对应版本的JSON文件。数据可用于训练和评估医疗领域的文本生成模型,例如基于CoD的诊断推理系统。同时,也可用于令牌分类任务,如识别文本中的疾病与症状实体。推荐结合相关论文中的方法进行使用,以充分发挥其在可解释医疗代理中的价值。
背景与挑战
背景概述
在智能医疗诊断领域,如何构建可解释且可靠的诊断模型一直是核心难题。2024年,由陈俊英、桂驰等研究者提出的CoD(Chain of Diagnosis)框架,旨在通过模拟临床医生的诊断推理链来提升模型透明度。作为该框架的关键数据支撑,FreedomIntelligence/CoD-PatientSymDisease数据集由香港中文大学(深圳)及深圳市大数据研究院等机构联合创建,聚焦于患者症状与疾病之间的结构化关联。该数据集包含中英双语版本,通过合成方式生成高质量的患者-症状-疾病三元组,为训练可解释的医疗语言模型提供了基础资源。其发布不仅推动了诊断推理任务的研究,更在自然语言处理与临床决策支持的交叉领域产生了重要影响,为后续构建具有可解释性的医疗智能体奠定了数据基础。
当前挑战
该数据集面临的核心挑战首先在于医疗领域固有的复杂性:症状与疾病之间往往呈现非一一对应的模糊关系,同一症状可能对应多种潜在疾病,而模型需从合成数据中学习这种多对多的诊断逻辑,这对数据质量和标注准确性提出了极高要求。其次,构建过程中需平衡合成数据的真实性与多样性,避免引入虚假关联或偏离临床实际的样本分布。此外,跨语言版本的构建(英文与中文)需处理不同医疗术语体系的差异,确保语义对齐的精确性。最后,如何验证合成数据在真实临床场景中的泛化能力,避免模型过度依赖人工生成的模式,仍是当前亟需突破的瓶颈。
常用场景
经典使用场景
该数据集专为医疗领域的文本生成与序列标注任务而设计,其核心应用场景在于构建和评估基于链式诊断(Chain of Diagnosis, CoD)的可解释医疗智能体。通过提供结构化描述的合成患者数据,涵盖疾病与对应症状的映射关系,研究者能够利用该数据集训练模型模拟临床推理过程,即从主诉症状出发,逐步推导出潜在诊断结论。这种数据驱动的诊断链构建,不仅为大型语言模型在医疗问答中的可解释性研究提供了标准化测试基准,还推动了融合医学知识与自然语言处理的跨学科探索。
解决学术问题
该数据集直面当前医疗AI领域的两大核心学术挑战:其一,现有模型在诊断推理中常呈现“黑箱”特性,缺乏可解释的中间推理步骤,而CoD-PatientSymDisease通过显式编码症状与疾病的逻辑链条,为研究可解释诊断机制提供了数据基础;其二,真实医疗数据因隐私与伦理限制难以大规模获取,该合成数据集在确保无病人信息泄露的前提下,模拟了多样化的临床场景,有效缓解了医学自然语言处理研究中数据稀缺的困境。其意义在于为构建安全、可信的临床决策支持系统奠定了方法论与数据基石。
衍生相关工作
围绕该数据集已衍生出一系列具有影响力的研究工作,其中最具代表性的是Chen等人(2024)提出的CoD框架,该工作首次将链式诊断范式引入医疗大语言模型,通过结构化推理步骤显著提升了诊断的可解释性。后续研究进一步探索了基于该数据集的少样本学习策略、多语言跨域诊断迁移(如中英文症状-疾病映射对齐),以及结合知识图谱增强诊断链的鲁棒性。这些工作共同推动了可解释医疗AI从理论验证走向实际部署的进程。
以上内容由遇见数据集搜集并总结生成


