
camfruss/bread_proofing
收藏官方服务:
资源简介:
该数据集包含多个特征,如文件名、日期、帖子ID、点赞数、帖子链接、图片链接以及不同类型的证明(如过量证明、不足证明等)。数据集分为训练、测试和验证三个部分,每个部分都有相应的字节数和样本数。数据集的总下载大小和实际大小也被提供。
该数据集包含多个特征,如文件名、日期、帖子ID、点赞数、帖子链接、图片链接以及不同类型的证明(如过量证明、不足证明等)。数据集分为训练、测试和验证三个部分,每个部分都有相应的字节数和样本数。数据集的总下载大小和实际大小也被提供。
提供机构:
camfruss原始信息汇总
面包发酵数据集
数据集概述
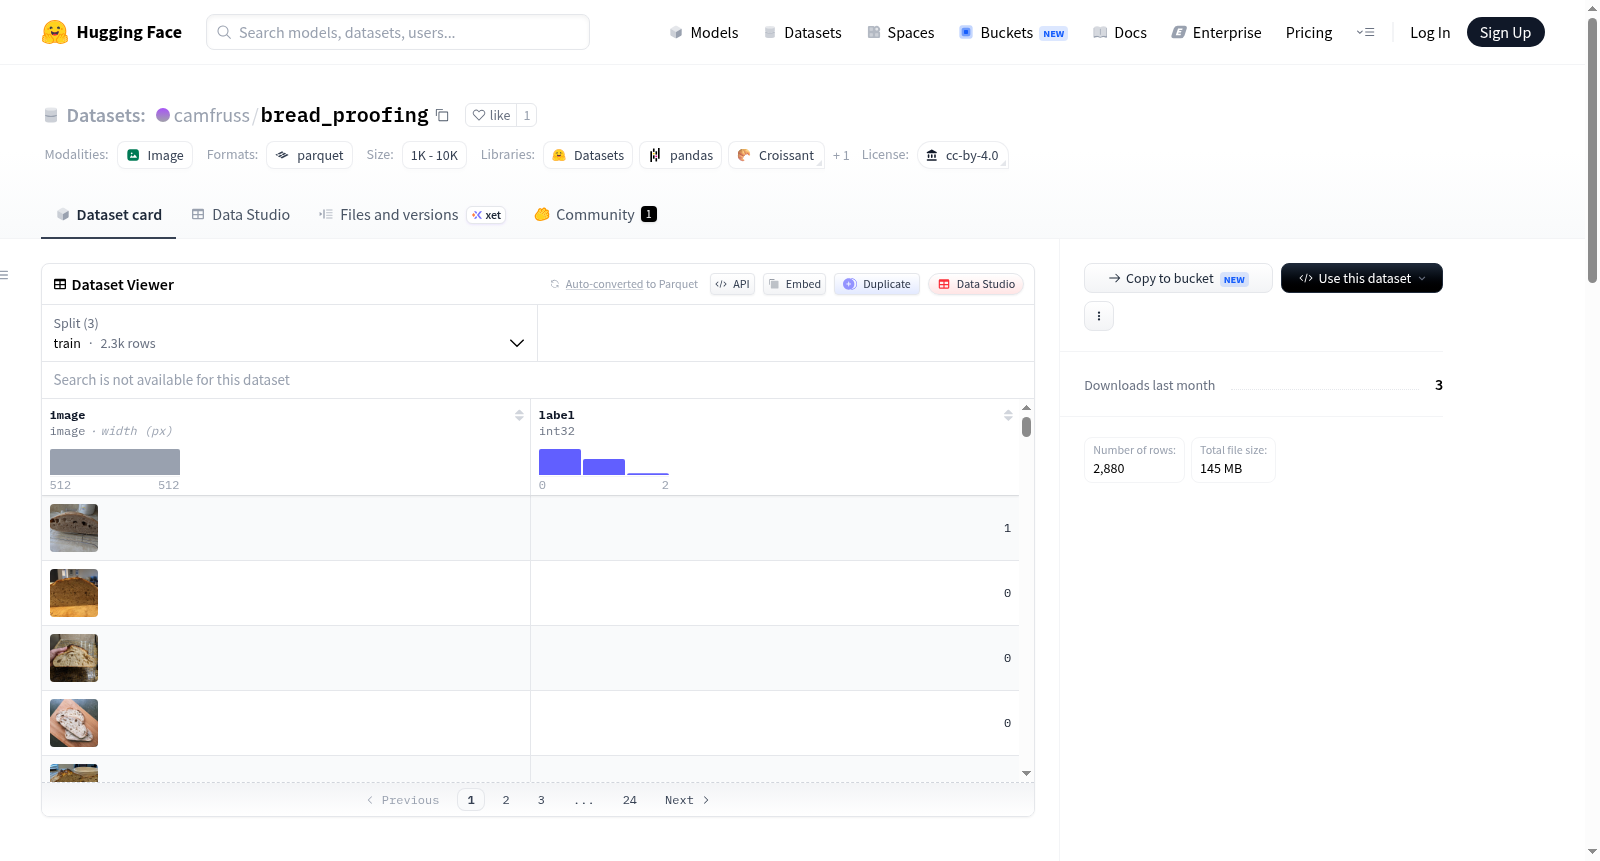
面包发酵数据集提供了3,801张切片面包的图像,以及每条面包是否过度发酵、发酵不足、发酵良好或无法确定的概率。
特征
- image: 图像数据,类型为图像。
- upvotes: 点赞数,类型为int32。
- under_proof: 发酵不足的概率,类型为float16。
- over_proof: 过度发酵的概率,类型为float16。
- perfect_proof: 发酵良好的概率,类型为float16。
- unsure_proof: 无法确定的概率,类型为float16。
数据集结构
数据集分为三个部分:
- train: 训练集,包含3040个样本,大小为153009299.56字节。
- valid: 验证集,包含380个样本,大小为19215858.0字节。
- test: 测试集,包含381个样本,大小为19268030.0字节。
数据集实例
json { "image": Image, "upvotes": int, // 帖子互动的代理 "under_proof": float, "over_proof": float, "perfect_proof": float, "unsure_proof": float }
已知限制
- 评论来自匿名且未经验证的烘焙师,数据存在一定噪声。
- 部分图像不是理想的面包屑照片,且光照条件不佳。
搜集汇总
数据集介绍
构建方式
本数据集旨在为面包发酵程度识别提供标准化图像资源,其构建过程严谨而系统。数据源采集自Reddit的/r/Breadit与/r/Sourdough两个子论坛,原始数据经由Academic Torrents获取,时间跨度覆盖各子论坛创建之初至2023年12月31日。利用Pushshift Dumps提供的脚本过滤掉未提及发酵的评论,并对包含多张图片的帖文仅取首张图像入库。随后通过Narrative Select软件人工剔除所有非面包纹理照片,从12,558篇提及发酵的帖文中筛选出3,802张可用纹理图像,最终保留2,880张高质量样本。所有图像均被裁剪并缩放至512×512像素,矩形图像的长边经裁剪处理以保持统一尺寸。
使用方法
数据集的使用便捷而直观,适用于图像分类任务的训练与评估。用户可通过HuggingFace Datasets库直接加载,默认配置下自动获取预定义的train、valid与test三个子集。每个数据实例包含一个PIL图像对象与一个整数标签,标签0、1、2分别对应欠发酵、过发酵与发酵完美。数据以parquet格式存储于data目录下,支持流式加载以节省内存。研究者亦可利用该数据集作为迁移学习的基准,或结合自定义模型进行面包发酵程度的实时检测应用。
背景与挑战
背景概述
面包发酵程度的精确判断是烘焙科学与食品工业中的一项关键挑战,传统上依赖经验丰富的烘焙师通过视觉与触觉进行主观评估,缺乏客观量化标准。为此,camfruss/bread_proofing数据集应运而生,由研究人员于2024年基于Reddit社区(r/Breadit和r/Sourdough)及Academic Torrents平台构建,旨在通过计算机视觉方法实现面包发酵状态的自动分类。该数据集包含2,880张切片面包图像,标注为欠发酵、过发酵或发酵完美三类,核心研究问题在于利用深度学习模型从面包内部气孔结构(crumb)中提取特征以区分发酵程度。数据集采用80/10/10的训练-验证-测试划分,并借助GPT-4.0-mini模型结合帖子标题、描述及评论进行低成本(约0.30美元)标注,为食品图像分析领域提供了首个专注于面包发酵的标准化资源,推动了烘焙质量自动化检测的研究进展。
当前挑战
该数据集面临的核心挑战包括:首先,在领域问题层面,面包发酵程度的视觉判别具有高度模糊性,不同发酵状态的气孔纹理差异细微,且受拍摄角度、光照条件和面包种类影响显著,导致传统图像分类模型难以稳定学习判别性特征。其次,数据构建过程中存在多重挑战:原始数据源自Reddit匿名用户的非专业摄影,部分图像并非理想的气孔特写(crumb shot),且存在光照不均、构图杂乱等噪声;标注依赖社区评论的文本推理,因评论者信息有限且主观性强,引入了中等程度的标签噪声;此外,从12,558条提及发酵的帖子中,仅2,880张图像通过文本一致性筛选,大量数据因评论矛盾或图像质量不佳被剔除,导致样本规模有限且类别分布可能不均衡,限制了模型泛化能力。
常用场景
经典使用场景
在食品科学与计算机视觉的交叉领域中,面包发酵状态评估是一个兼具挑战性与实用价值的研究课题。camfruss/bread_proofing 数据集提供了2880张切片面包的纹理图像,并标注了欠发酵、过发酵与发酵得当三种状态。该数据集最经典的使用场景是作为图像分类任务的基准,用于训练和测试深度学习模型在面包内部气孔结构上的识别能力。研究者通常利用该数据集验证卷积神经网络(如ResNet、EfficientNet)或视觉Transformer在细粒度食品图像分类中的表现,尤其是在光照不均、背景复杂等真实拍摄条件下模型鲁棒性的评估。
解决学术问题
该数据集有效解决了面包发酵状态自动判定的学术难题,填补了食品发酵领域缺乏标准化图像数据集的空白。传统上,发酵程度的判断依赖烘焙师的经验与主观观察,难以量化与复现。通过引入该数据集,研究者得以探索基于视觉特征的发酵状态分类方法,推动食品科学从经验驱动向数据驱动转型。其意义在于为食品质量检测、发酵过程监控等研究提供了可重复的实验基础,促进了计算机视觉技术在农业与食品工业中的学术应用,并为后续更复杂的多模态发酵分析研究奠定了数据基石。
实际应用
在实际产业场景中,该数据集可被部署于智能烘焙设备或食品生产线的质量监控系统。例如,面包房或大型烘焙企业可利用基于该数据集训练的模型,对流水线上的面包切片进行实时拍照与发酵状态分类,及时发现欠发酵或过发酵产品并调整工艺参数。此外,该技术还可嵌入家用智能烤箱或手机应用,帮助家庭烘焙爱好者获取专业级的发酵建议,提升烘焙成功率。该数据集的低标注成本(仅约0.30美元)也使其成为中小企业实现食品质量自动化检测的可行方案,具有显著的经济效益与推广潜力。
数据集最近研究
最新研究方向
在食品科学与计算机视觉交叉的前沿领域,烘焙发酵状态智能识别正成为精准农业与自动化厨房研究的新热点。该数据集聚焦于面包发酵程度的视觉分类,通过采集Reddit社区中大量真实烘焙图片,并借助GPT-4.0-mini模型进行语义标签化,构建了包含2304张训练样本的标准化图像库。当前研究方向主要围绕利用深度学习模型对面包切面气孔结构进行细粒度分析,以区分发酵不足、过度与完美状态,这一工作与近年来AI辅助食品质量检测、家庭烘焙数字化趋势紧密相关。数据集的发布填补了发酵过程视觉基准的空白,为开发低成本、高鲁棒性的发酵状态监测系统提供了关键训练资源,有望推动烘焙行业从经验依赖向数据驱动转型,并促进食品图像理解在社交媒体大数据中的应用拓展。
以上内容由遇见数据集搜集并总结生成


