
UBC-NLP/nadi26_subtask_5_SLU_test
收藏官方服务:
资源简介:
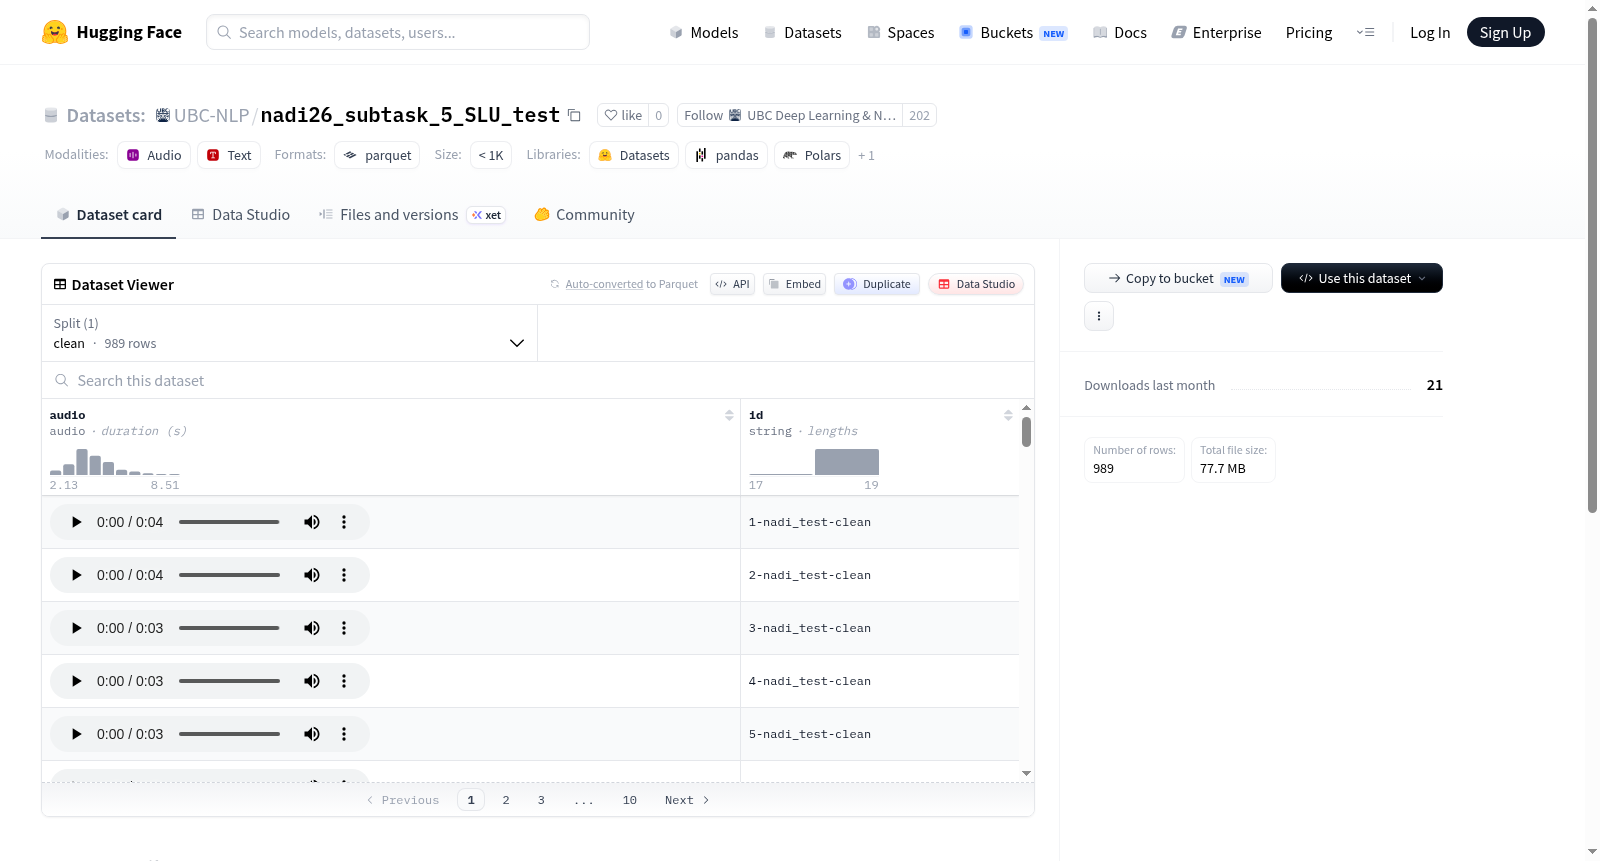
NADI 2026官方测试集,专门用于NADI 2026 Subtask 5:口语理解任务。该数据集包含一个clean测试分割,共有989个样本。每个样本包括音频数据(直接嵌入在Parquet文件中)和对应的唯一标识符(ID)。音频数据以音频格式存储,ID为字符串类型。
Official test set for NADI 2026 Subtask 5: Spoken Language Understanding. The dataset contains the clean test split with 989 examples. Each example includes audio (embedded directly in Parquet) and an ID.
提供机构:
UBC-NLP搜集汇总
数据集介绍
构建方式
NADI 2026 子任务5口语理解测试集(nadi26_subtask_5_SLU_test)的构建以支持阿拉伯方言口语理解研究为初衷,聚焦于多方言场景下的语音语义解析。该数据集采用Parquet格式直接嵌入音频数据,共收录989条纯净语音样本,每条样本包含音频文件及其唯一标识符,形成结构化的测试基准。数据采集与标注过程依托NADI 2026竞赛框架,确保样本覆盖方言多样性及语义复杂性,为模型评估提供标准化基础。
特点
该数据集的核心特色在于其高度集中的测试场景设计,仅提供纯净语音(clean split)以避免噪声干扰,从而精准评估模型在多方言口语理解任务中的鲁棒性。每个样本以音频与ID的简洁配对形式呈现,摒弃冗余元数据,强化了数据集的易用性与可扩展性。此外,Parquet格式的嵌入方式保证了音频数据的快速加载与兼容性,适应现代深度学习框架的流式处理需求。
使用方法
使用者可通过HuggingFace数据集加载工具直接获取该测试集,利用load_dataset函数指定配置名与分割标签,即可将音频数据及ID高效载入Python环境。加载后,音频字段可直接输入预训练语音模型进行推理,ID用于追踪样本来源或对齐评估结果。数据集无需额外预处理步骤,适合作为标准化Benchmark用于阿拉伯方言口语理解系统的性能对比与改进验证。
背景与挑战
背景概述
NADI 2026 Subtask 5 Spoken Language Understanding (SLU) 测试集(nadi26_subtask_5_SLU_test)由UBC-NLP团队创建,旨在推动阿拉伯方言口语理解领域的研究。该数据集发布于NADI 2026评测任务框架下,聚焦于阿拉伯语方言的语音到语义映射这一核心问题。其创建背景源于阿拉伯语方言多样性与资源稀缺之间的矛盾,为多方言口语理解系统提供了标准化的评估基准。该测试集包含989条清洁语音样本,每条样本配备音频与唯一标识符,以Parquet格式嵌入音频数据,简化了数据加载流程。作为NADI系列评测的一部分,该数据集对评估多方言SLU系统的泛化能力、促进低资源阿拉伯方言的语音技术发展具有重要影响,尤其为跨方言口语理解模型的公平比较提供了关键支撑。
当前挑战
该数据集面临的首要挑战是解决阿拉伯语方言多样性带来的语音识别与语义理解问题。阿拉伯语具有数十种差异显著的地域方言,不同方言在音系、词汇和句法上存在巨大鸿沟,使得单一SLU模型难以覆盖全部变体,且缺乏统一标注规范。其次,构建过程中的挑战尤为突出:获取覆盖广泛方言的高质量语音数据面临采集成本高、标注一致性难以保障等困难,同时需确保音频在清洁环境下录制以降低噪声干扰。此外,将989例测试样本设计为能够有效区分系统性能、避免偶然性评估,也是数据集设计中的关键难点,需权衡样本数量与方言分布的平衡性。
常用场景
经典使用场景
在阿拉伯方言处理这一前沿领域,NADI 2026子任务5的口语理解测试集为研究社区提供了标准化的评估基准。该数据集包含989条纯净音频样本,每条样本均以原生格式嵌入Parquet文件中,并配有唯一标识符。经典使用场景聚焦于多方言口语理解系统的性能评测,研究者可借助该测试集检验模型在阿拉伯语不同变体上的理解能力,尤其适用于评估端到端语音理解架构在真实方言场景中的泛化表现。
实际应用
在实际应用中,该测试集成为智能客服与语音助手开发的关键验证工具。针对阿拉伯世界广泛存在方言差异的现实需求,企业可借助该数据集评估其语音系统在埃及、黎凡特、马格里布等主要方言区域的响应准确性。医疗问诊语音转录、多语言会议纪要生成、公共信息服务热线等场景均能从该数据集的方言理解能力评测中获益,有效提升语音应用的跨区域服务韧性。
衍生相关工作
该数据集的发布催生了一系列具有影响力的衍生工作,包括方言感知的语音编码器预训练方法、基于对比学习的跨方言语义对齐模型,以及结合语音与文本模态的联合理解框架。部分研究还探索了将测试集作为正则化约束融入连续词嵌入训练的技术路径,显著提升了模型在方言边界案例上的鲁棒性。这些工作共同构建了从语音信号到方言语义的完整推理链条,构成了阿拉伯口语理解研究的重要知识图谱。
以上内容由遇见数据集搜集并总结生成


